ماتریکسهاب
MatrixHubمحصول دائوکلاد
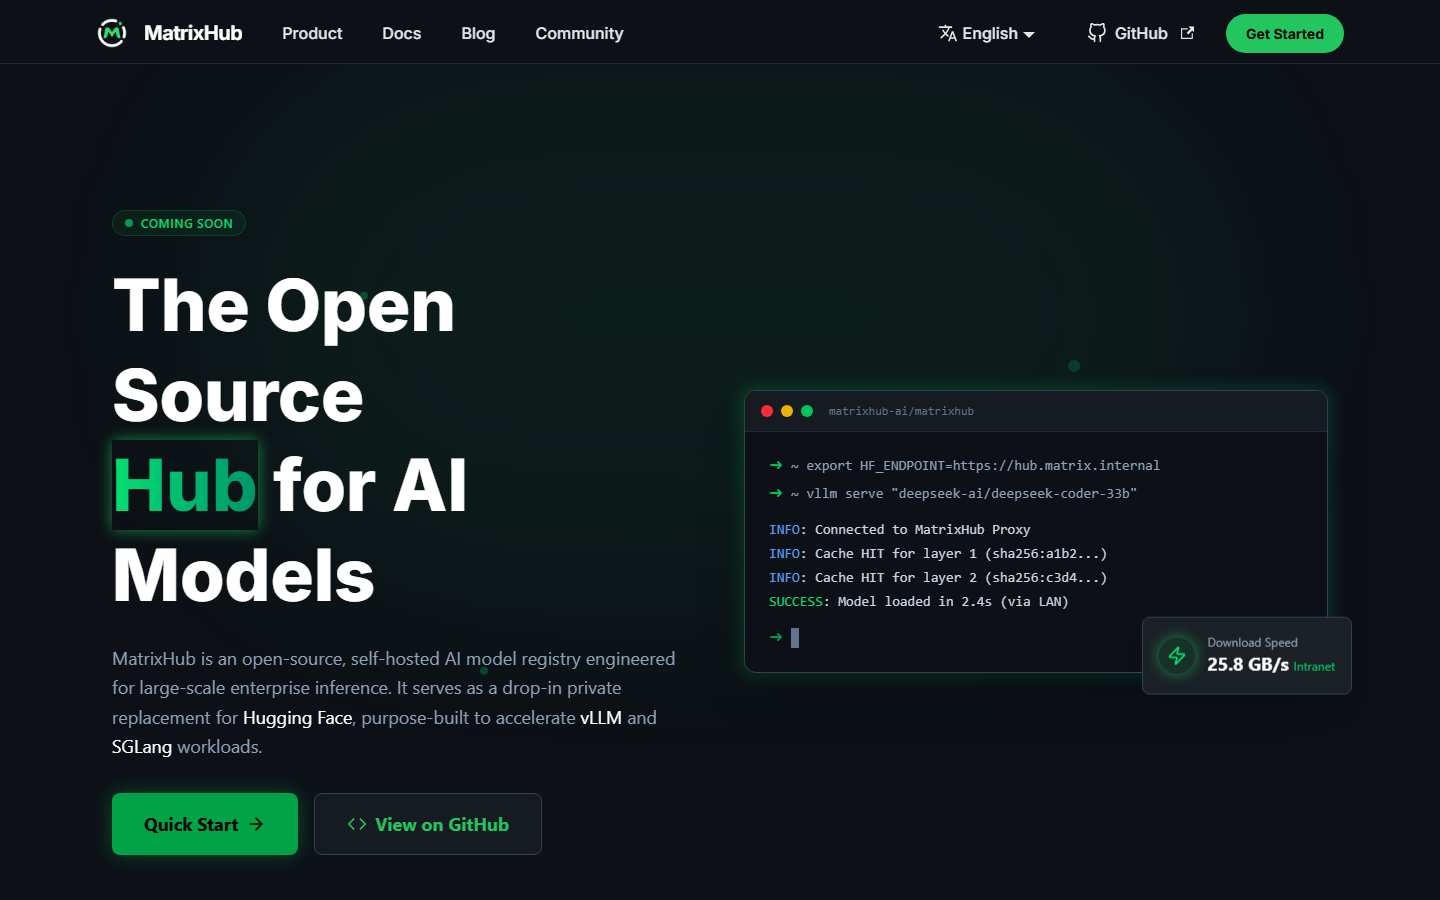
کش داخلی Hugging Face برای سرورهای GPU سازمان: هر مدل یک بار از بیرون دانلود میشود و بعد همهٔ سرورها، حتی در قطعی اینترنت، از داخل شبکه میگیرندش؛ متنباز (Apache-2.0) ولی هنوز نسخهٔ اولیه.
معرفی: ماتریکسهاب
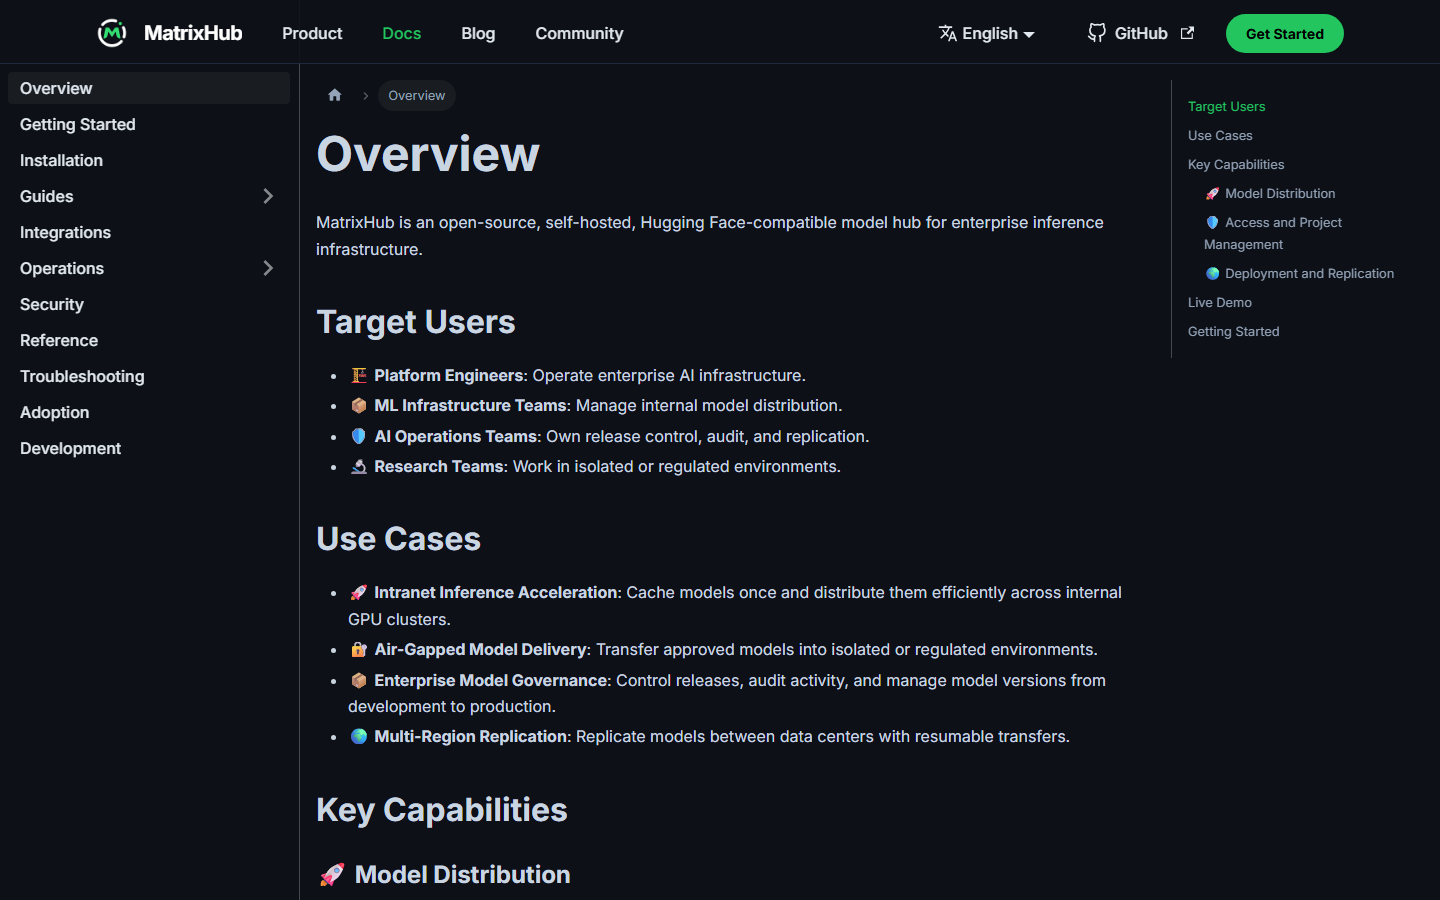
MatrixHub پروژهٔ متنباز شرکت چینی DaoCloud (شانگهای) است که ژوئیهٔ ۲۰۲۶ برای ورود به بنیاد CNCF درخواست داده است. با مجوز Apache-2.0 و بدون نسخهٔ پولی، خودش را «جایگزین خصوصی Hugging Face» برای سرورهای vLLM و SGLang معرفی میکند.
کارش ساده است: یک «پروژهٔ پراکسی» میسازید که به huggingface.co یا آینهای مثل hf-mirror.com وصل است. بار اولی که سروری مدلی را میخواهد، MatrixHub آن را از بیرون میگیرد و ذخیره میکند؛ از آن به بعد، حتی در قطعی اینترنت، از دیسک خودش میدهد. روی هر سرور GPU فقط HF_ENDPOINT را روی آدرس MatrixHub میگذارید و hf download و vLLM مثل قبل کار میکنند. همگامسازی زمانبندیشده (مثلاً همهٔ مدلهای Qwen)، تکثیر بین دو هاب، نقش کاربری، حساب ربات و توکن هم دارد.
نصبش سبک است: یک برنامه با پایگاه دادهٔ SQLite در Docker، و ایمیجها روی ghcr.io گیتهاباند نه Docker Hub. محدودیت اصلی تازگی آن است: نسخهٔ ۰٫۲ (۱۸ سپتامبر ۲۰۲۶) هنوز دیتاست، ورود با LDAP یا SSO و ذخیره در S3 ندارد و خروجی گرفتن آرشیوی برای شبکهٔ کاملاً ایزوله مستند نشده است.
در برابر CSGHub: اگر کتابخانهٔ کامل با دیتاست و مخزن تیمی میخواهید CSGHub، و اگر فقط میخواهید سرورهای GPU هر مدل را یک بار از بیرون بگیرند و بعد از داخل، MatrixHub سادهتر است.
بهترین کاربردها
- •سرورهای GPU شرکت مدلها رو فقط یک بار از اینترنت بگیرن و بعد از داخل شبکه
- •یه کش داخلی برای Hugging Face بسازم که موقع قطعی اینترنت هم مدل بده
- •برای vLLM روی سرورهای سازمان مخزن مدل داخلی راه بندازم
- •مدلهای Qwen رو خودکار و زمانبندیشده روی سرور داخلی همگام کنم
- •به جای Nexus یا Harbor یه مخزن داخلی مخصوص مدلهای هوش مصنوعی داشته باشم
برای این کارها سراغش نروید
- –چت با هوش مصنوعی (برای این کار Open WebUI یا Jan)
- –نگهداری و مدیریت دیتاست (هنوز پشتیبانی نمیشود)
- –اجرای مدل روی لپتاپ شخصی
اجرا روی سیستم خودتان
این برنامه را روی سیستم خودتان نصب میکنید و هوش مصنوعی روی همان دستگاه اجرا میشود؛ متن و فایلهایتان از آن بیرون نمیرود.
- بعد از نصب، بدون اینترنت
- متنباز
- Apache-2.0 — استفادهٔ تجاری آزاد
- رابط وب
- API
بعد از پر شدن، داخل شبکه بدون اینترنت کار میکند و مدلهای ذخیرهشده را میدهد. دریافت مدل تازه از Hugging Face یا آینهها اینترنت میخواهد.
متنباز و بدون نسخهٔ پولی؛ استفادهٔ تجاری آزاد است.
سختافزار لازم
- کارت گرافیک لازم نیست
- حداقل سختافزار اعلام نشده. برآورد ما: یک سرور کوچک (۴ هسته و ۸ گیگابایت رم) با دیسکی متناسب با مدلها (برای دهها مدل چند ترابایت). خودش کارت گرافیک نمیخواهد.
نصب و اجرا
- ۱
فایلها را بگیرید و اجرا کنیدلینوکس
export MATRIXHUB_VERSION=v0.2.0 mkdir -p matrixhub && cd matrixhub curl -fL "https://raw.githubusercontent.com/matrixhub-ai/matrixhub/$MATRIXHUB_VERSION/deploy/docker-compose.yml" -o docker-compose.yml curl -fL "https://raw.githubusercontent.com/matrixhub-ai/matrixhub/$MATRIXHUB_VERSION/deploy/config.yaml" -o config.yaml MATRIXHUB_IMAGE_TAG="$MATRIXHUB_VERSION" docker compose up -dرابط در پورت ۳۰۰۱ سرور باز میشود؛ ورود با admin و رمز changeme که باید فوراً عوض شود. ایمیج از ghcr.io گرفته میشود و دادهها در پوشهٔ data/matrixhub میماند.
- ۲
منبع و پروژهٔ پراکسی بسازید
در Registry Management یک منبع (huggingface.co یا hf-mirror.com) تعریف کنید. بعد در Project Management پروژهای مثلاً به نام Qwen بسازید، پراکسی را روشن کنید و سازمان Qwen را برایش بنویسید.
- ۳
سرورهای GPU را به آن وصل کنیدلینوکس
export HF_ENDPOINT="http://192.168.1.20:3001" hf download Qwen/Qwen3-0.6Bبار اول از بیرون میگیرد و ذخیره میکند؛ دفعههای بعد و در قطعی اینترنت از همین سرور. vLLM و SGLang هم با همین متغیر کار میکنند.
دانلود
- GitHub: matrixhub-ai/matrixhub ↗رسمی
کد و یادداشت نسخهها.
- مستندات نصب ↗رسمی
نصب با Docker Compose و Helm.
- نسخهٔ نمایشی ↗رسمی
برای دیدن رابط پیش از نصب؛ هر لحظه ممکن است پاک شود.
نکات امنیتی
- رمز پیشفرض admin (changeme) را فوراً عوض کنید و هاب را فقط روی شبکهٔ داخلی باز کنید.
- برای سرورها بهجای حساب مدیر، حساب ربات با دسترسی خواندن بسازید.
- فایلهای safetensors یا GGUF را به فایلهای pickle (.bin یا .pt) ترجیح دهید و هش فایلها را با منبع مقایسه کنید.
برای شرکتها و سازمانها
برای سازمانی با چند سرور GPU: HF_ENDPOINT را یک بار روی هر سرور تنظیم کنید تا همه از یک کش داخلی بخوانند. کنار vLLM برای اجرا و Open WebUI برای کارمندان کامل میشود. اگر دیتاست و مخزن تیمی هم لازم دارید، CSGHub را ببینید.
همسطح ابری
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۵ خرداد ۱۴۰۵
تصاویر محیط ابزار
نقاط قوت
- ✓دقیقاً برای کش مدل: هر مدل یک بار دانلود و بعد از داخل شبکه داده میشود
- ✓سازگار با hf download، vLLM و SGLang فقط با تنظیم HF_ENDPOINT
- ✓همگامسازی زمانبندیشده (مثلاً همهٔ مدلهای Qwen) و تکثیر بین دو هاب
- ✓نصب سبک با یک برنامه و SQLite؛ ایمیجها روی ghcr.io گیتهاب، نه Docker Hub
- ✓متنباز با Apache-2.0 و بدون نسخهٔ پولی
نقاط ضعف
- ✗سرور جدا با دیسک بزرگ لازم است (هر مدل ۸ میلیاردی حدود ۱۶ گیگابایت) و حداقل سختافزار اعلام نشده؛ راهاندازی کار واحد IT است
- ✗نسخهٔ اولیه (۰٫۲، سپتامبر ۲۰۲۶)؛ ممکن است تغییرات ناسازگار داشته باشد
- ✗هنوز دیتاست، ورود با LDAP یا SSO و گزارش ممیزی ندارد
- ✗رابط فقط انگلیسی و چینی است
- ✗خروجی آرشیوی برای شبکهٔ کاملاً ایزوله هنوز مستند نشده است
پرسشهای پرتکرار
MatrixHub چه فرقی با CSGHub دارد؟
MatrixHub یک کش خودکار برای سرورهای GPU است: هر مدل را بار اول از بیرون میگیرد و بعد از داخل میدهد. CSGHub کتابخانهٔ کامل با دیتاست، کارت مدل و مخزن تیمی است ولی نسخهٔ رایگانش مستقیم از Hugging Face همگام نمیشود. بیشتر سازمانها یکی را لازم دارند.
در قطعی اینترنت چه میکند؟
هر مدلی که پیش از قطعی از طریقش دانلود شده یا با قاعدهٔ همگامسازی گرفتهاید، از دیسک خودش داده میشود. مدل تازه را در قطعی نمیتواند بگیرد؛ پس مدلهای لازم را از قبل همگام کنید.
نام کاربری و رمز پیشفرض چیست؟
admin و changeme. بلافاصله بعد از اولین ورود عوضش کنید و هاب را فقط روی شبکهٔ داخلی باز کنید.
گزینهٔ سبکتری هست؟
Olah یک کش سادهتر Hugging Face است (مجوز MIT، نصب با pip install olah) که حالت آفلاین دارد و در قطعی فقط از کش میدهد. رابط وب و کاربر ندارد و پروژهٔ کوچکی است.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
سیاسجیهاب (OpenCSG)
CSGHub (OpenCSG)
نسخهٔ داخلی و متنباز Hugging Face برای سرور سازمان: مدلها و دیتاستها را با نسخهبندی و دسترسی تیمی نگه میدارد تا کارمندان و سرورهای GPU در قطعی اینترنت هم از داخل شبکه دانلود کنند.
هاگینگ فیس
Hugging Face
گیتهابِ دنیای هوش مصنوعی؛ بزرگترین مرجع مدلهای متنباز، دیتاستها و دموهای آنلاین (Spaces) که هر توسعهدهنده هوش مصنوعی دیر یا زود سر و کارش به آن میافتد.
اینفرکس
InferX
زیرساخت استنتاج سرورلس برای مدلهای AI با cold start بسیار سریع، API سازگار با OpenAI و پرداخت فقط برای زمان فعال GPU.