جما ۴ (آفلاین)
Gemma 4 (offline)خانوادهٔ مدل باز گوگل که روی لپتاپ یا کامپیوتر خودتان و بدون اینترنت اجرا میشود: چت، خلاصهنویسی، کدنویسی و فهم تصویر در پنج اندازه از E2B تا 31B، با مجوز آزاد Apache 2.0.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- Apache-2.0 — استفادهٔ تجاری آزاد
- فارسی: متوسط
بعد از دانلود کاملاً آفلاین کار میکند. برچسبهای gemma4:cloud و gemma4:31b-cloud در Ollama روی سرور Ollama اجرا میشوند و آفلاین نیستند.
جما ۴ برخلاف جما ۳ با Apache 2.0 منتشر شده، نه با شرایط استفادهٔ Gemma. استفادهٔ تجاری، تغییر و بازنشر آزاد است؛ اگر مدل را بازنشر میکنید، متن مجوز را همراهش بگذارید.
نسخهها و سختافزار لازم
- E2B۵٫۱B (فعال ۲٫۳B)طول متن ۱۲۸ هزار توکن
- حجم دانلود:
- ۴٫۳ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۶ گیگ یا رم ۸ گیگ
ollama run gemma4:e2b-it-qatبرآورد. نسخهٔ QAT گوگل که از همان آموزش برای ۴ بیتیشدن آماده شده؛ برچسب پیشفرض gemma4:e2b با ۷٫۲ گیگابایت بزرگتر است. متن، تصویر و صدا؛ ۲٫۳ میلیارد پارامتر مؤثر.
- E4B۸B (فعال ۴٫۵B)طول متن ۱۲۸ هزار توکن
- حجم دانلود:
- ۶٫۱ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۸ گیگ یا رم ۱۰ گیگ
ollama run gemma4:e4b-it-qatبرآورد. نسخهٔ QAT گوگل؛ برچسب پیشفرض gemma4:e4b ۹٫۶ گیگابایت است. برای بیشتر لپتاپها انتخاب متعادل.
- 12B۱۲Bطول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۷٫۲ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۹ گیگ یا رم ۱۱ گیگ
ollama run gemma4:12b-it-qatبرآورد. ژوئن ۲۰۲۶ اضافه شد و گوگل آن را برای لپتاپ یا کارت گرافیک ۱۶ گیگابایتی ساخته؛ صدا و تصویر را بدون انکودر جدا میگیرد. برچسب پیشفرض gemma4:12b ۷٫۶ گیگابایت است.
- 26B A4B۲۵٫۲B (فعال ۳٫۸B)طول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۱۶ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۲۰ گیگ یا رم ۲۲ گیگ
ollama run gemma4:26b-a4b-it-qatبرآورد. MoE: در هر توکن حدود ۳٫۸ میلیارد پارامتر کار میکند و سریع است، ولی کل مدل باید در حافظه جا شود. برچسب پیشفرض gemma4:26b (نسخهٔ mtp) ۱۹ گیگابایت است.
- 31B۳۰٫۷Bطول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۱۹ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۲۳ گیگ یا رم ۲۵ گیگ
ollama run gemma4:31b-it-qatبرآورد. قویترین نسخه؛ متن و تصویر (بدون صدا). برچسب پیشفرض gemma4:31b ۲۰ گیگابایت است.
نصب و اجرا
- ۱
Ollama را روی ویندوز نصب کنیدویندوز
irm https://ollama.com/install.ps1 | iexاین دستور را در PowerShell بزنید (ویندوز ۱۰ به بعد). فایل نصبی OllamaSetup.exe هم در صفحهٔ دانلود Ollama و بخش Releases گیتهاب آن هست.
- ۲
Ollama را روی لینوکس یا مک نصب کنیدلینوکس
curl -fsSL https://ollama.com/install.sh | shهمین دستور روی مک (macOS 14 به بعد) هم کار میکند؛ روی مک میتوانید فایل نصبی را هم از سایت Ollama بگیرید.
- ۳
مدل را دانلود و اجرا کنید
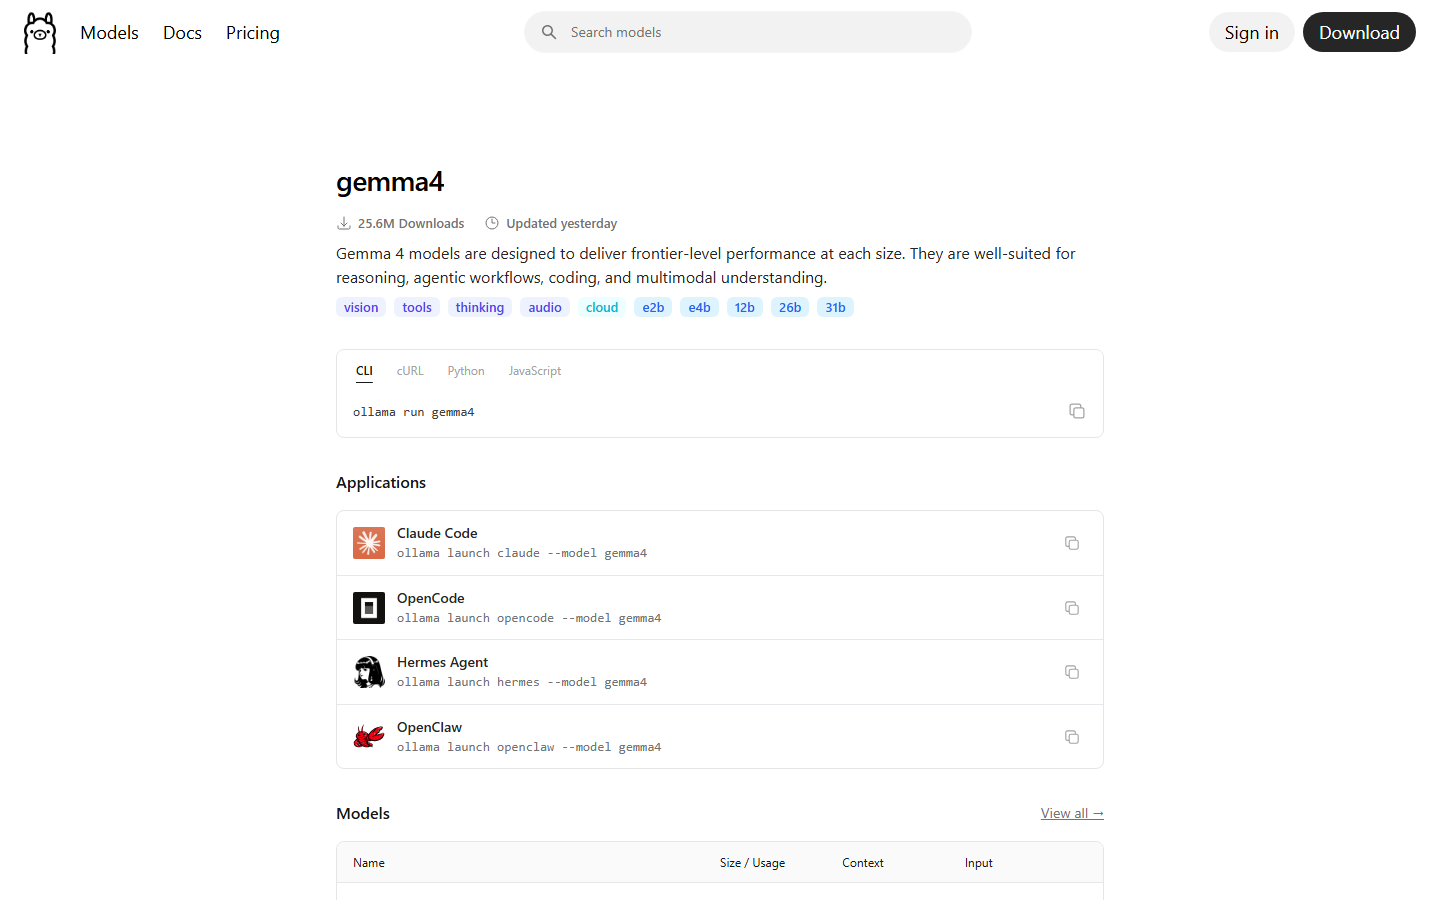
ollama run gemma4:e4b-it-qatبار اول حدود ۶ گیگابایت دانلود میشود و بعد آفلاین کار میکند. برای لپتاپ ضعیف gemma4:e2b-it-qat و برای کارت گرافیک ۲۴ گیگابایتی gemma4:26b-a4b-it-qat یا gemma4:31b-it-qat را بزنید.
- ۴
یا با LM Studio و Jan
lms get google/gemma-4-e4bاول LM Studio را از lmstudio.ai نصب و یکبار باز کنید تا دستور lms کار کند؛ یا در خود برنامه Gemma 4 را جستوجو کنید. در Jan هم از تب Hub همین مدل را جستوجو و دانلود کنید.
- ۵
نصب کاملاً آفلاین با فایل GGUF
ollama create gemma4-offline -f Modelfileروی سیستم متصل فایل رسمی gemma-4-E4B_q4_0-it.gguf را از مخزن google/gemma-4-E4B-it-qat-q4_0-gguf بگیرید و با فلش منتقل کنید. کنارش یک فایل متنی به نام Modelfile با خط FROM ./gemma-4-E4B_q4_0-it.gguf بسازید، این دستور را بزنید و بعد ollama run gemma4-offline (Ollama نسخهٔ ۰٫۳۰ به بعد). این روش متن را راه میاندازد؛ برای ورودی تصویر سادهتر است پوشهٔ مدلهای Ollama را از سیستمی که مدل را pull کرده کپی کنید. در Jan هم میتوانید همین فایل را از تنظیمات Llama.cpp با گزینهٔ Import وارد کنید.
دانلود
- Ollama ↗رسمی
همهٔ اندازهها و نسخههای QAT؛ برچسبهای cloud آفلاین نیستند.
- Hugging Face (Google) ↗رسمی
وزنهای اصلی safetensors؛ فرم دسترسی ندارد.
- GGUF رسمی گوگل (E4B، QAT) ↗رسمی
فایل مدل ۵٫۲ گیگابایتی بهعلاوهٔ فایل mmproj حدود ۱ گیگابایتی برای تصویر؛ مخزنهای مشابه برای E2B، 12B، 26B و 31B هم هست.
- Kaggle ↗رسمی
مسیر دانلود دیگری که گوگل در اعلام رسمی آورده.
- LM Studio ↗رسمی
گوگل در اعلام رسمی به آن لینک داده؛ نسخههای GGUF و MLX.
نکات امنیتی
- پورت 11434 را روی اینترنت باز نکنید: Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و API آن رمز ندارد؛ اگر روی شبکهٔ داخلی لازمش دارید، پشت پروکسی با احراز هویت یا فایروال بگذارید.
- فایل مدل را فقط از منبع رسمی بگیرید، GGUF یا safetensors را به فایلهای pickle (.bin یا .pt) ترجیح دهید و هش SHA256 فایل را با صفحهٔ دانلود مقایسه کنید.
- اگر به مدل اجازهٔ اجرای دستور، دسترسی به فایل یا ابزار میدهید (حالت ایجنت)، کارهای برگشتناپذیر مثل پاککردن و ارسال را فقط با تأیید دستی انجام دهید.
برای شرکتها و سازمانها
برای سرور شرکت، 26B یا 31B روی یک کارت گرافیک ۲۴ گیگابایتی مناسب است. Ollama برای چند کاربر کم کافی است؛ برای درخواستهای همزمان زیاد، vLLM یا SGLang که گوگل پشتیبانیشان را اعلام کرده بهترند. مجوز Apache 2.0 استفادهٔ درونسازمانی و تجاری را بیشرط آزاد گذاشته است.
برنامههایی که این مدل را اجرا میکنند
 اولاما
 الام استودیو
 اوپن وبیوآی
 دیفای
 انیتینگالالام
 لاما سیپیپی
 Jan
 پاکتپال ایآی
 ویالالام
 چری استودیو
 گوگل ایآی اج گالری
 لوکالایآی
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۴ اسفند ۱۴۰۴
معرفی: جما ۴ (آفلاین)
جما ۴ خانوادهٔ مدلهای باز گوگل دیپمایند است که ۳۱ مارس ۲۰۲۶ منتشر شد و نسخهٔ 12B آن ژوئن ۲۰۲۶ اضافه شد. وزنها را یکبار دانلود میکنید و بعد مدل کاملاً روی دستگاه خودتان کار میکند؛ هیچ متن یا فایلی به سرور گوگل نمیرود. همهٔ نسخهها متن و تصویر میگیرند، حالت «فکر کردن» دارند و میتوانند ابزار صدا بزنند.
برای دانشجو، فریلنسر، کسبوکار کوچک و تیم IT مناسب است که دستیار هوش مصنوعی بدون اشتراک و بدون وابستگی به اینترنت میخواهند: خلاصهکردن متن، پیشنویس ایمیل و گزارش، توضیح و نوشتن کد، و خواندن متن و جدول از عکس و PDF.
سختافزار به زبان ساده: E2B روی لپتاپ معمولی با ۸ گیگابایت رم اجرا میشود و E4B حدود ۱۰ گیگابایت رم میخواهد. گوگل نسخهٔ 12B را برای لپتاپهای ۱۶ گیگابایتی ساخته است. 26B و 31B کارت گرافیک ۲۴ گیگابایتی یا مک با حدود ۳۲ گیگابایت حافظه میخواهند؛ 26B از نوع MoE است و در هر توکن فقط حدود ۴ میلیارد پارامترش کار میکند، برای همین با وجود حجم زیاد سریع جواب میدهد.
برای شروع، Ollama را نصب کنید و بنویسید ollama run gemma4:e4b-it-qat؛ یا در LM Studio و Jan نام Gemma 4 را جستوجو کنید. برای سیستمی که اصلاً اینترنت ندارد، فایل GGUF رسمی گوگل را یکبار روی سیستم دیگری بگیرید و با فلش منتقل کنید.
محدودیتها: گوگل فهرست زبانها را منتشر نکرده و فارسی را جدا نام نبرده، پس فارسی را خودتان محک بزنید. دانش مدل تا ژانویهٔ ۲۰۲۵ است و نسخههای کوچک در اطلاعات عمومی زیاد اشتباه میکنند. برچسبهای cloud در Ollama آفلاین نیستند.
بهترین کاربردها
- •یه چتبات آفلاین روی لپتاپ ۸ گیگ رم نصب کنم
- •بدون اینترنت یه متن طولانی رو خلاصه کنم
- •متن داخل عکس یا PDF رو بدون آپلود جایی استخراج کنم
- •یه دستیار برنامهنویسی آفلاین روی لپتاپم داشته باشم
- •روی سرور شرکت یه ChatGPT داخلی راه بندازم که داده بیرون نره
- •با Ollama یه ایجنت محلی بسازم که ابزار صدا بزنه
- •نمودار یا جدول داخل تصویر رو بدون اینترنت تحلیل کنم
- •ایمیل و گزارش کاری رو آفلاین پیشنویس کنم
برای این کارها سراغش نروید
- –ساخت تصویر یا لوگو
- –ساخت ویدئو
- –تبدیل متن به گفتار
- –جستوجوی زنده در اینترنت و خبرهای روز
تصاویر محیط ابزار
نقاط قوت
- ✓مجوز Apache 2.0: استفادهٔ تجاری، تغییر و بازنشر بدون شرط اضافه
- ✓پنج اندازه برای هر سختافزار، از لپتاپ ۸ گیگابایتی تا کارت گرافیک ۲۴ گیگابایتی
- ✓فهم تصویر در همهٔ نسخهها (متن عکس، جدول، نمودار، PDF و دستخط)؛ E2B، E4B و 12B صدا را هم میفهمند
- ✓نسخهٔ 26B از نوع MoE است و تقریباً با سرعت یک مدل ۴ میلیاردی جواب میدهد
- ✓فایل GGUF رسمی از خود گوگل و پشتیبانی از روز اول در Ollama، LM Studio، llama.cpp و vLLM
- ✓حالت فکر کردن قابل خاموشکردن و فراخوانی ابزار برای ساخت ایجنت محلی
نقاط ضعف
- ✗برای نسخههای 26B و 31B دستکم ۲۰ تا ۲۳ گیگابایت حافظهٔ کارت گرافیک (یا مک با ۳۲ گیگابایت حافظه) لازم است؛ روی پردازنده خیلی کند میشوند
- ✗فارسی در فهرست رسمی نیامده؛ گوگل فقط از «بیش از ۱۴۰ زبان» حرف میزند
- ✗نسخههای E2B و E4B در دانش عمومی و استدلال سنگین ضعیفاند و ممکن است با اطمینان جواب غلط بدهند
- ✗دانش مدل تا ژانویهٔ ۲۰۲۵ است و بدون اینترنت از اتفاقهای تازه خبر ندارد
- ✗ورودی صدا حداکثر ۳۰ ثانیه و ویدئو حداکثر ۶۰ ثانیه (فریمبهفریم) است
پرسشهای پرتکرار
برای اجرای جما ۴ چه لپتاپ یا کامپیوتری لازم است؟
برای E2B حدود ۸ گیگابایت رم کافی است (نسخهٔ QAT با حجم ۴٫۳ گیگابایت). E4B حدود ۱۰ و 12B حدود ۱۱ گیگابایت رم میخواهد و گوگل برای 12B لپتاپ ۱۶ گیگابایتی را پیشنهاد میکند. 26B و 31B را روی کارت گرافیک ۲۴ گیگابایتی یا مک ۳۲ گیگابایتی اجرا کنید. این اعداد برآورد ما از حجم فایلهاست و با متنهای خیلی بلند بیشتر میشود.
جما ۴ فارسی بلد است؟
گوگل میگوید مدل روی بیش از ۱۴۰ زبان آموزش دیده و بیش از ۳۵ زبان را آماده پشتیبانی میکند، ولی فهرست را منتشر نکرده و فارسی را جدا نام نبرده. پس احتمالاً فارسی را میفهمد، ولی تضمین رسمی ندارد؛ قبل از کار جدی چند نمونه از کار خودتان را امتحان کنید. نسخههای بزرگتر معمولاً در زبانهای غیرانگلیسی بهترند.
چطور جما ۴ را روی کامپیوتری که اصلاً اینترنت ندارد نصب کنم؟
روی یک سیستم متصل، نصبکنندهٔ Ollama و فایل رسمی gemma-4-E4B_q4_0-it.gguf (مخزن google/gemma-4-E4B-it-qat-q4_0-gguf) را بگیرید و با فلش منتقل کنید. کنار فایل، یک فایل متنی به نام Modelfile با خط FROM ./gemma-4-E4B_q4_0-it.gguf بسازید و بزنید ollama create gemma4-offline -f Modelfile. راه سادهتر: روی سیستم متصل ollama pull gemma4:e4b-it-qat بزنید و پوشهٔ مدلهای Ollama را به سیستم آفلاین کپی کنید.
استفادهٔ تجاری از جما ۴ آزاد است؟
بله. جما ۴ برخلاف نسلهای قبلی با مجوز Apache 2.0 منتشر شده و میتوانید آن را در محصول تجاری یا روی سرور شرکت به کار ببرید و حتی تغییرش دهید. اگر مدل را بازنشر میکنید، متن مجوز را همراهش بگذارید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
کوئن ۳.۵ (آفلاین)
Qwen3.5 (offline)
خانوادهٔ مدل باز علیبابا که فارسی در فهرست رسمی زبانهایش است؛ از 0.8B برای لپتاپ ضعیف تا 35B-A3B برای سیستم قوی، با فهم تصویر، حافظهٔ متنی ۲۶۲ هزار توکنی و مجوز Apache 2.0.

چتجیپیتی
ChatGPT
شناختهشدهترین دستیار هوش مصنوعی؛ چت و نگارش فارسی، ساخت و ویرایش عکس با Images 2.5، پژوهش عمیق، Codex و ChatGPT Work — با چت متنی نامحدود در پلن رایگان (GPT-5.6 Luna).

جمنای
Gemini
دستیار هوش مصنوعی گوگل: رایگان با Gemini 3.6 Flash و جستجوی زنده، عکس با Nano Banana، ویدئو با Gemini Omni (پلن پولی) و گفتگوی صوتی با Gemini Live.