کوئن ۳.۵ (آفلاین)
Qwen3.5 (offline)خانوادهٔ مدل باز علیبابا که فارسی در فهرست رسمی زبانهایش است؛ از 0.8B برای لپتاپ ضعیف تا 35B-A3B برای سیستم قوی، با فهم تصویر، حافظهٔ متنی ۲۶۲ هزار توکنی و مجوز Apache 2.0.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- Apache-2.0 — استفادهٔ تجاری آزاد
- فارسی: خوب
بعد از دانلود کاملاً آفلاین کار میکند. برچسبهای qwen3.5:cloud و qwen3.5:397b-cloud در Ollama روی سرور Ollama اجرا میشوند و آفلاین نیستند.
استفادهٔ تجاری، تغییر و بازنشر آزاد است؛ اگر مدل را بازنشر میکنید، متن مجوز را همراهش بگذارید.
نسخهها و سختافزار لازم
- 0.8B۸۰۰Mطول متن ۲۵۶ هزار توکن
- حافظهٔ لازم:
- کارت گرافیک ۲ گیگ یا رم ۴ گیگ
ollama run qwen3.5:0.8bبرآورد از برچسب پیشفرض (۸ بیتی، ۱ گیگابایت). برای کارهای خیلی ساده و سیستمهای ضعیف.
- 2B۲Bطول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۱٫۹ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۴ گیگ یا رم ۶ گیگ
ollama run qwen3.5:2bبرآورد از برچسب پیشفرض که ۸ بیتی و ۲٫۷ گیگابایت است؛ نسخهٔ ۴ بیتی qwen3.5:2b-q4_K_M ۱٫۹ گیگابایت است.
- 4B۴Bطول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۳٫۴ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۵ گیگ یا رم ۷ گیگ
ollama run qwen3.5:4bبرآورد. برای لپتاپ ۸ گیگابایتی.
- 9B۹Bطول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۶٫۶ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۸ گیگ یا رم ۱۰ گیگ
ollama run qwen3.5:9bبرآورد. پیشنهاد ما برای متن فارسی روی لپتاپ ۱۶ گیگابایتی؛ روی مک برچسب qwen3.5:9b-mlx هم هست. از ۴ اکتبر ۲۰۲۶ برچسبهای MTP (پیشبینی چندتوکنی برای تولید سریعتر) هم در Ollama آمده، مثل qwen3.5:9b-mtp-q8_0 (۱۳ گیگابایت) و qwen3.5:9b-mtp-nvfp4 (۷٫۶ گیگابایت).
- Qwen3.6-35B-A3B۳۵B (فعال ۳B)
- حجم دانلود:
- ۲۴ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۲۹ گیگ یا رم ۳۱ گیگ
ollama run qwen3.6:35b-a3b-q4_K_Mجانشین Qwen3.5-35B-A3B؛ ۱۵ آوریل ۲۰۲۶ با مجوز Apache-2.0 منتشر شد. MoE با حدود ۳ میلیارد پارامتر فعال در هر توکن؛ کل مدل باید در حافظه جا شود. فهرست زبانهای Qwen3.6 را جدا بررسی نکردهایم. حافظهٔ لازم برآوردی است. نسخهٔ قدیمی Qwen3.5-35B-A3B هنوز با برچسب qwen3.5:35b-a3b در Ollama هست.
نصب و اجرا
- ۱
Ollama را روی ویندوز نصب کنیدویندوز
irm https://ollama.com/install.ps1 | iexاین دستور را در PowerShell بزنید (ویندوز ۱۰ به بعد). فایل نصبی OllamaSetup.exe هم در صفحهٔ دانلود Ollama و بخش Releases گیتهاب آن هست.
- ۲
Ollama را روی لینوکس یا مک نصب کنیدلینوکس
curl -fsSL https://ollama.com/install.sh | shهمین دستور روی مک (macOS 14 به بعد) هم کار میکند؛ روی مک میتوانید فایل نصبی را هم از سایت Ollama بگیرید.
- ۳
مدل را دانلود و اجرا کنید
ollama run qwen3.5:9bحدود ۶٫۶ گیگابایت دانلود میشود و بعد آفلاین کار میکند. برای لپتاپ ضعیفتر qwen3.5:4b (۳٫۴ گیگابایت) یا qwen3.5:2b را بزنید.
- ۴
یا با LM Studio و Jan
lms get qwen/qwen3.5-9bاول LM Studio را از lmstudio.ai نصب و یکبار باز کنید تا دستور lms کار کند؛ یا در خود برنامه Qwen3.5 را جستوجو کنید. در Jan هم از تب Hub همین مدل را جستوجو و دانلود کنید.
- ۵
نصب کاملاً آفلاین با فایل GGUF
ollama create qwen35-offline -f ModelfileQwen برای این نسل GGUF رسمی نداده؛ فایل Qwen3.5-9B-Q4_K_M.gguf (۵٫۶ گیگابایت) از مخزن lmstudio-community/Qwen3.5-9B-GGUF همان است که LM Studio دانلود میکند. آن را منتقل کنید، Modelfile با خط FROM ./Qwen3.5-9B-Q4_K_M.gguf بسازید و این دستور را بزنید (Ollama نسخهٔ ۰٫۳۰ به بعد). این روش متن را راه میاندازد؛ در ۲۰۲۶ برای افزودن فایل تصویر جدا (mmproj) به این معماری در Ollama مشکل گزارش شده بود، پس برای ورودی تصویر پوشهٔ مدلهای Ollama را از سیستمی که مدل را pull کرده کپی کنید.
دانلود
- Ollama ↗رسمی
از 0.8B تا 122B؛ برچسبهای cloud آفلاین نیستند.
- Hugging Face (Qwen) ↗رسمی
وزنهای اصلی؛ مخزنهای همنام برای 0.8B، 2B، 4B، 27B و 35B-A3B هم هست.
- ModelScope (Qwen) ↗رسمی
مسیری که خود Qwen برای کسانی که به Hugging Face دسترسی ندارند پیشنهاد میکند؛ وزنهای safetensors برای vLLM و SGLang.
- LM Studio ↗غیررسمی
صفحهٔ مدل در LM Studio؛ نسخههای GGUF و MLX.
- GGUF (LM Studio Community) ↗غیررسمی
فایلهای GGUF که LM Studio استفاده میکند؛ ساخت Qwen نیست.
نکات امنیتی
- پورت 11434 را روی اینترنت باز نکنید: Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و API آن رمز ندارد؛ اگر روی شبکهٔ داخلی لازمش دارید، پشت پروکسی با احراز هویت یا فایروال بگذارید.
- فایل مدل را فقط از منبع رسمی بگیرید، GGUF یا safetensors را به فایلهای pickle (.bin یا .pt) ترجیح دهید و هش SHA256 فایل را با صفحهٔ دانلود مقایسه کنید.
- اگر به مدل اجازهٔ اجرای دستور، دسترسی به فایل یا ابزار میدهید (حالت ایجنت)، کارهای برگشتناپذیر مثل پاککردن و ارسال را فقط با تأیید دستی انجام دهید.
برای شرکتها و سازمانها
برای سرور شرکت، وزنها را از ModelScope بگیرید (مثلاً با modelscope download --model Qwen/Qwen3.5-35B-A3B) و با vLLM یا SGLang سرو کنید؛ مخزن Qwen خودش این دو را برای بار کاری سنگین پیشنهاد میکند. نسخهٔ 122B-A10B هم برای سرورهای بزرگ هست (۸۱ گیگابایت در Ollama).
برنامههایی که این مدل را اجرا میکنند
 اولاما
 الام استودیو
 اوپن وبیوآی
 دیفای
 انیتینگالالام
 لاما سیپیپی
 Jan
 رگفلو (پرسش و پاسخ از اسناد)
 پاکتپال ایآی
 ویالالام
 چری استودیو
 لوکالایآی
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۶ بهمن ۱۴۰۴
معرفی: کوئن ۳.۵ (آفلاین)
کوئن ۳.۵ نسل مدلهای باز تیم Qwen علیبابا است که فوریه و مارس ۲۰۲۶ منتشر شد. مدلها از پایه چندوجهیاند: متن و تصویر میگیرند و متن تحویل میدهند. Qwen فارسی را، همراه دری و تاجیکی، در فهرست رسمی ۲۰۱ زبان و گویش این نسل آورده است.
اگر دستیار فارسی آفلاین میخواهید، گزینهٔ خوبی برای شروع است: خلاصه و بازنویسی متن فارسی، ترجمه، جوابدادن از روی سند، خواندن عکس و فرم، و کمک در برنامهنویسی. نسخههای کوچکش برای لپتاپهای معمولی ساخته شدهاند.
سختافزار: 0.8B با ۴ گیگابایت رم، 4B با حدود ۷ و 9B با حدود ۱۰ گیگابایت رم یا کارت گرافیک ۸ گیگابایتی اجرا میشود. در اندازهٔ 35B-A3B بهتر است جانشینش Qwen3.6-35B-A3B (آوریل ۲۰۲۶) را بگیرید که حدود ۳۲ گیگابایت رم یا کارت گرافیک بزرگ میخواهد؛ چون در هر توکن فقط حدود ۳ میلیارد پارامترش فعال است، از مدلهای متراکم همحجم سریعتر جواب میدهد.
شروع: بعد از نصب Ollama بزنید ollama run qwen3.5:9b. در LM Studio و Jan هم Qwen3.5 را جستوجو کنید. خود Qwen برای کسانی که به Hugging Face دسترسی ندارند سایت ModelScope را پیشنهاد میکند.
محدودیتها: 0.8B و 2B برای متن فارسی جدی و استدلال سنگین ضعیفاند. برای اندازهٔ ۲۷ میلیاردی، Qwen3.8-27B جدیدتر و قویتر است (مدخل جدا) و در اندازهٔ 35B-A3B، Qwen3.6-35B-A3B جای Qwen3.5-35B-A3B را گرفته است. اما 0.8B تا 9B هنوز جدیدترین مدلهای کوچک Qwenاند، چون Qwen3.6 و Qwen3.8 فقط در اندازههای بزرگتر منتشر شدهاند. برچسبهای cloud در Ollama آفلاین نیستند.
بهترین کاربردها
- •یه چتبات فارسی آفلاین روی لپتاپ اجرا کنم
- •بدون اینترنت متن فارسی رو خلاصه یا بازنویسی کنم
- •متن انگلیسی رو آفلاین به فارسی ترجمه کنم
- •از روی عکس فاکتور یا فرم، اطلاعات رو بدون اینترنت دربیارم
- •روی لپتاپ ۸ گیگ رم یه مدل هوش مصنوعی سبک نصب کنم
- •روی سرور شرکت یه دستیار فارسی داخلی راه بندازم
- •از روی یه سند طولانی آفلاین به سؤالهام جواب بگیرم
- •بدون اینترنت کد پایتون بنویسم و دیباگ کنم
برای این کارها سراغش نروید
- –ساخت تصویر
- –ساخت ویدئو یا انیمیشن
- –تبدیل گفتار به متن
- –جستوجوی زنده در اینترنت
تصاویر محیط ابزار
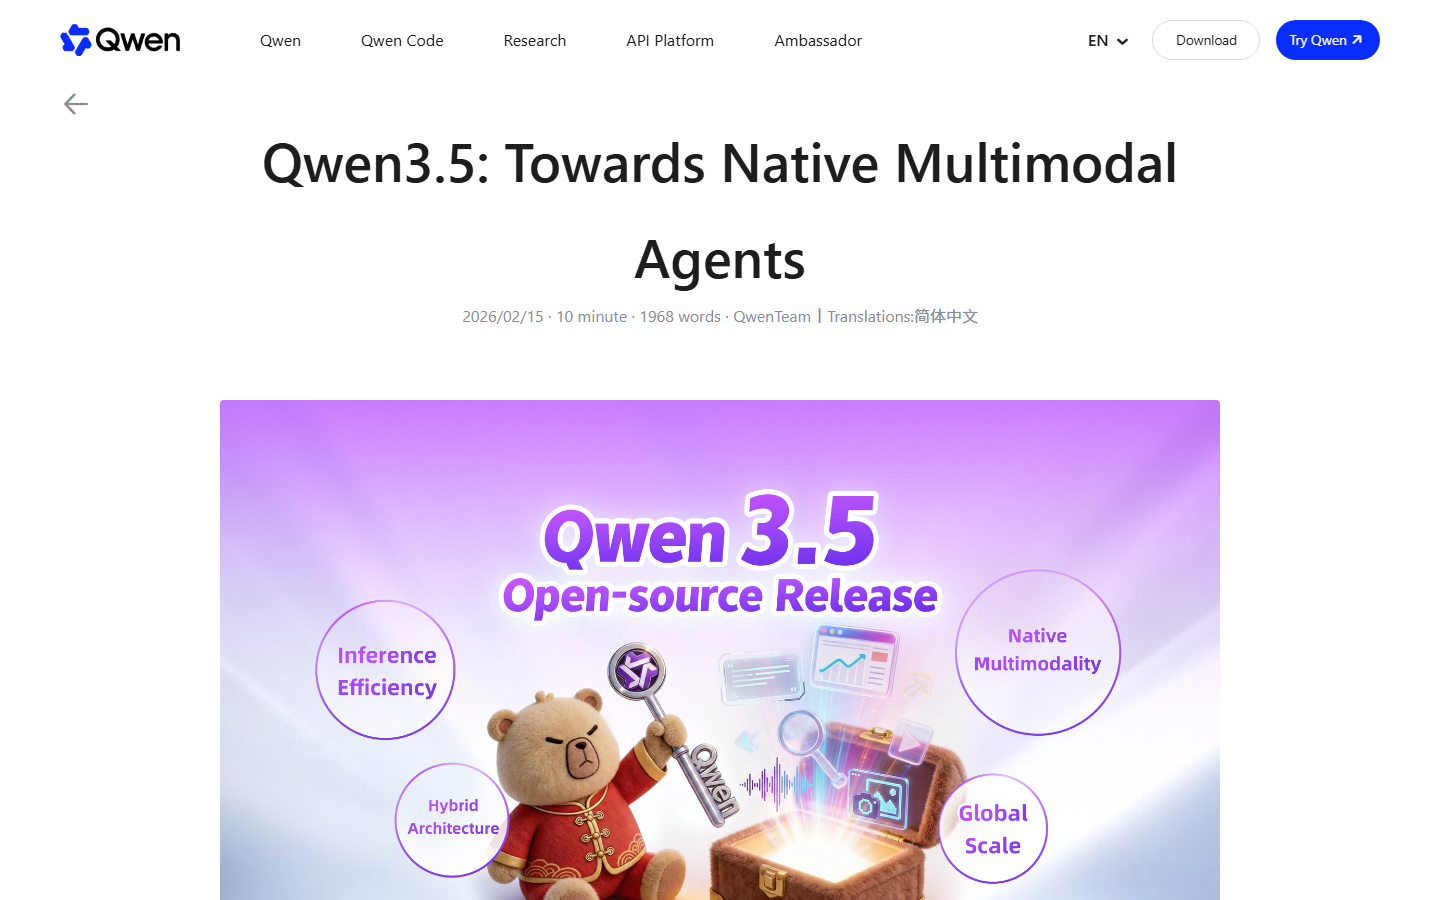
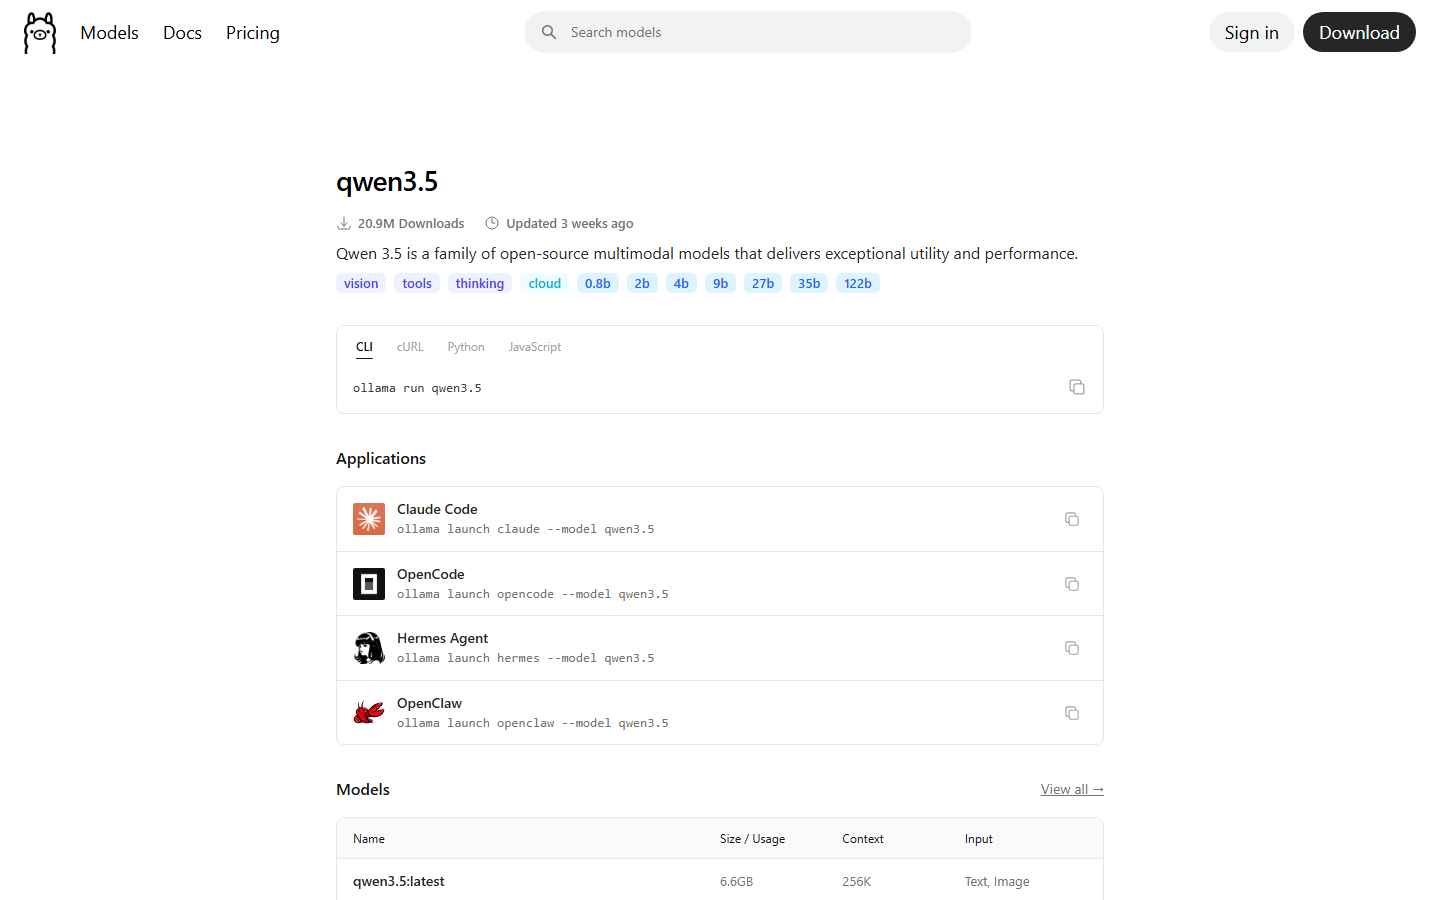
نقاط قوت
- ✓فارسی، دری و تاجیکی در فهرست رسمی ۲۰۱ زبان و گویش
- ✓اندازه برای هر سیستم، از 0.8B تا 35B-A3B؛ برای لپتاپ ۸ گیگابایتی هم گزینه دارد
- ✓فهم تصویر و سند در همهٔ اندازهها، با نمرهٔ خوب در آزمونهای سند و OCR مثل OmniDocBench
- ✓حافظهٔ متنی ۲۶۲ هزار توکنی برای سندهای طولانی
- ✓مجوز Apache 2.0 و دانلود رسمی از ModelScope علاوه بر Hugging Face
- ✓فراخوانی ابزار و حالت فکر کردن
نقاط ضعف
- ✗برای 9B حدود ۱۰ گیگابایت رم و برای 35B-A3B حدود ۳۲ گیگابایت رم (یا کارت گرافیک بزرگ) لازم است؛ نسخههای سبکتر کیفیت پایینتری دارند
- ✗0.8B و 2B برای نوشتن فارسی جدی و استدلال چندمرحلهای ضعیفاند
- ✗Qwen برای این نسل فایل GGUF رسمی نداده؛ فایلهای GGUF موجود کار جامعهاند
- ✗بنچمارک جداگانهٔ فارسی منتشر نشده و کیفیت فارسی را باید خودتان بسنجید
- ✗برای اندازههای 27B و 35B-A3B نسخههای جدیدتری از Qwen3.6 و Qwen3.8 منتشر شده است
پرسشهای پرتکرار
کدام نسخهٔ کوئن ۳.۵ را برای لپتاپم انتخاب کنم؟
با ۸ گیگابایت رم نسخهٔ 4B (حدود ۳٫۴ گیگابایت دانلود) و با ۱۶ گیگابایت رم نسخهٔ 9B (حدود ۶٫۶ گیگابایت) را بگیرید. 0.8B و 2B برای سیستمهای خیلی ضعیف و کارهای ساده مثل دستهبندی متناند. طبق برآورد ما 9B تقریباً کامل روی کارت گرافیک ۸ گیگابایتی جا میشود.
کوئن ۳.۵ فارسی را خوب میفهمد؟
فارسی در فهرست رسمی زبانهای Qwen3.5 آمده، پس پشتیبانی رسمی دارد. کیفیت به اندازه بستگی دارد: 9B و بزرگتر برای خلاصه، ترجمه و نوشتن فارسی مناسبترند و نسخههای خیلی کوچک ممکن است جملههای نادرست یا مخلوط با انگلیسی بسازند.
بدون اینترنت چطور نصبش کنم؟
راه مطمئن: روی سیستم متصل Ollama را نصب کنید، بزنید ollama pull qwen3.5:9b و پوشهٔ مدلهای Ollama را به سیستم آفلاین کپی کنید. راه دیگر: فایل GGUF (مثلاً Qwen3.5-9B-Q4_K_M.gguf) را یکبار بگیرید، کنارش Modelfile با خط FROM بسازید و ollama create بزنید.
برای کار تجاری مجاز است؟
بله. مجوز Apache 2.0 است: استفادهٔ تجاری، تغییر و ساخت محصول روی آن آزاد است. فقط هنگام بازنشر، متن مجوز را همراه کنید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
جما ۴ (آفلاین)
Gemma 4 (offline)
خانوادهٔ مدل باز گوگل که روی لپتاپ یا کامپیوتر خودتان و بدون اینترنت اجرا میشود: چت، خلاصهنویسی، کدنویسی و فهم تصویر در پنج اندازه از E2B تا 31B، با مجوز آزاد Apache 2.0.

چتجیپیتی
ChatGPT
شناختهشدهترین دستیار هوش مصنوعی؛ چت و نگارش فارسی، ساخت و ویرایش عکس با Images 2.5، پژوهش عمیق، Codex و ChatGPT Work — با چت متنی نامحدود در پلن رایگان (GPT-5.6 Luna).

جمنای
Gemini
دستیار هوش مصنوعی گوگل: رایگان با Gemini 3.6 Flash و جستجوی زنده، عکس با Nano Banana، ویدئو با Gemini Omni (پلن پولی) و گفتگوی صوتی با Gemini Live.