ویسپر
OpenAI Whisperمحصول اوپنایآی
مدل متنباز تشخیص گفتار OpenAI؛ استاندارد عملی پیادهسازی صوت به متن که فارسی را هم خوب میفهمد و رایگان روی سیستم خودتان اجرا میشود.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- MIT — استفادهٔ تجاری آزاد
- فارسی: متوسط
- دیگر بهروز نمیشود
بار اولی که یک اندازهٔ مدل را صدا میزنید، فایلش از سرور OpenAI دانلود و در پوشهٔ ~/.cache/whisper ذخیره میشود؛ بعد از آن بدون اینترنت کار میکند. میتوانید فایل .pt را روی کامپیوتر دیگری بگیرید و در همین پوشه (یا مسیری که با --model_dir میدهید) بگذارید.
کد و وزنهای مدل هر دو با مجوز MIT منتشر شدهاند و استفادهٔ تجاری آزاد است. نسخهٔ ابری (مدل whisper-1 در API اوپنایآی) جداست و پولی است.
نسخهها و سختافزار لازم
- small۲۴۴M
- حافظهٔ لازم:
- کارت گرافیک ۲ گیگ یا رم ۴ گیگ
سبک و سریع و مناسب سیستم ضعیف، اما دقتش برای فارسی از مدلهای بزرگتر خیلی کمتر است. حدود ۲ گیگابایت حافظهٔ گرافیک طبق README؛ رم تخمینی است.
- medium۷۶۹M
- حافظهٔ لازم:
- کارت گرافیک ۵ گیگ یا رم ۷ گیگ
حد وسط دقت و سرعت برای کارتهای میانرده؛ حدود ۵ گیگابایت حافظهٔ گرافیک طبق README. ترجمهٔ گفتار به انگلیسی را هم انجام میدهد.
- turbo (large-v3-turbo)۸۰۹M
- حافظهٔ لازم:
- کارت گرافیک ۶ گیگ یا رم ۸ گیگ
نسخهٔ بهینهٔ large-v3 و مدل پیشفرض خط فرمان: طبق README حدود ۸ برابر سریعتر از large با افت کم در دقت و حدود ۶ گیگابایت حافظهٔ گرافیک. برای ترجمهٔ گفتار به انگلیسی آموزش ندیده است.
- large-v3۱٫۶B
- حافظهٔ لازم:
- کارت گرافیک ۱۰ گیگ یا رم ۱۲ گیگ
دقیقترین نسخه برای فارسی؛ حدود ۱۰ گیگابایت حافظهٔ گرافیک طبق README. روی CPU کند است.
- BuzzASR Persian (large-v3 fine-tune)۱٫۶B
- حافظهٔ لازم:
- کارت گرافیک ۶ گیگ یا رم ۸ گیگ
فاینتیون فقطفارسی Whisper large-v3 از گروه BuzzASR (مخزن ۸ سپتامبر ۲۰۲۶، مقالهٔ Findings of EMNLP 2026)، مجوز MIT و استفادهٔ تجاری آزاد. طبق کارت مدل، خطای نویسه (CER) روی FLEURS ۵٫۱۳٪ در برابر ۷٫۱۸٪ برای large-v3 اصلی و روی Common Voice 25 حدود ۴٫۰۵٪ در برابر ۱۴٪ است؛ این دو مجموعه در دادههای آموزشش هم بودهاند و گفتار محاورهای سنجیده نشده. با کتابخانهٔ Transformers اجرا میشود، نه با بستهٔ openai-whisper؛ تبدیل به whisper.cpp یا faster-whisper آزمایش نشده، چون توکنایزر عوض شده است. حافظهٔ گرافیک (حدود ۵ تا ۶ گیگابایت در fp16) و رم تخمینیاند.
نصب و اجرا
- ۱
ffmpeg را نصب کنید (لینوکس)لینوکس
sudo apt update && sudo apt install ffmpegدر مک: brew install ffmpeg
- ۲
ffmpeg را نصب کنید (ویندوز)ویندوز
choco install ffmpegیا با Scoop: scoop install ffmpeg
- ۳
ویسپر را با pip نصب کنید
pip install -U openai-whisperپایتون ۳٫۸ تا ۳٫۱۳. در ویندوز اگر کارت انویدیا دارید، اول PyTorch نسخهٔ CUDA را طبق راهنمای pytorch.org نصب کنید.
- ۴
یک فایل فارسی را به زیرنویس تبدیل کنید
whisper audio.mp3 --model turbo --language Persian --output_format srtبار اول مدل turbo (حدود ۱٫۶ گیگابایت) دانلود میشود. برای دقت بیشتر --model large-v3 و برای ترجمهٔ گفتار به انگلیسی --task translate (با large-v3 یا medium).
- ۵
استفاده روی کامپیوتر بدون اینترنت
whisper audio.mp3 --model turbo --model_dir ./models --language Persianفایل large-v3-turbo.pt را روی کامپیوتر دیگری دانلود کنید و در پوشهٔ models بگذارید؛ ویسپر هش آن را چک میکند و دیگر سراغ اینترنت نمیرود.
- ۶
اختیاری: مدل فارسی BuzzASR با Transformers
pip install transformers torch torchaudioبعد کد ششخطی کارت مدل BuzzASR/persian را اجرا کنید؛ زبان فارسی در تنظیمات تولید آن ثابت شده است. فایل مدل (۳٫۰۹ گیگابایت، safetensors) بار اول از Hugging Face دانلود میشود.
دانلود
- openai-whisper (PyPI) ↗رسمی
بستهٔ رسمی پایتون؛ آخرین نسخه 20250625
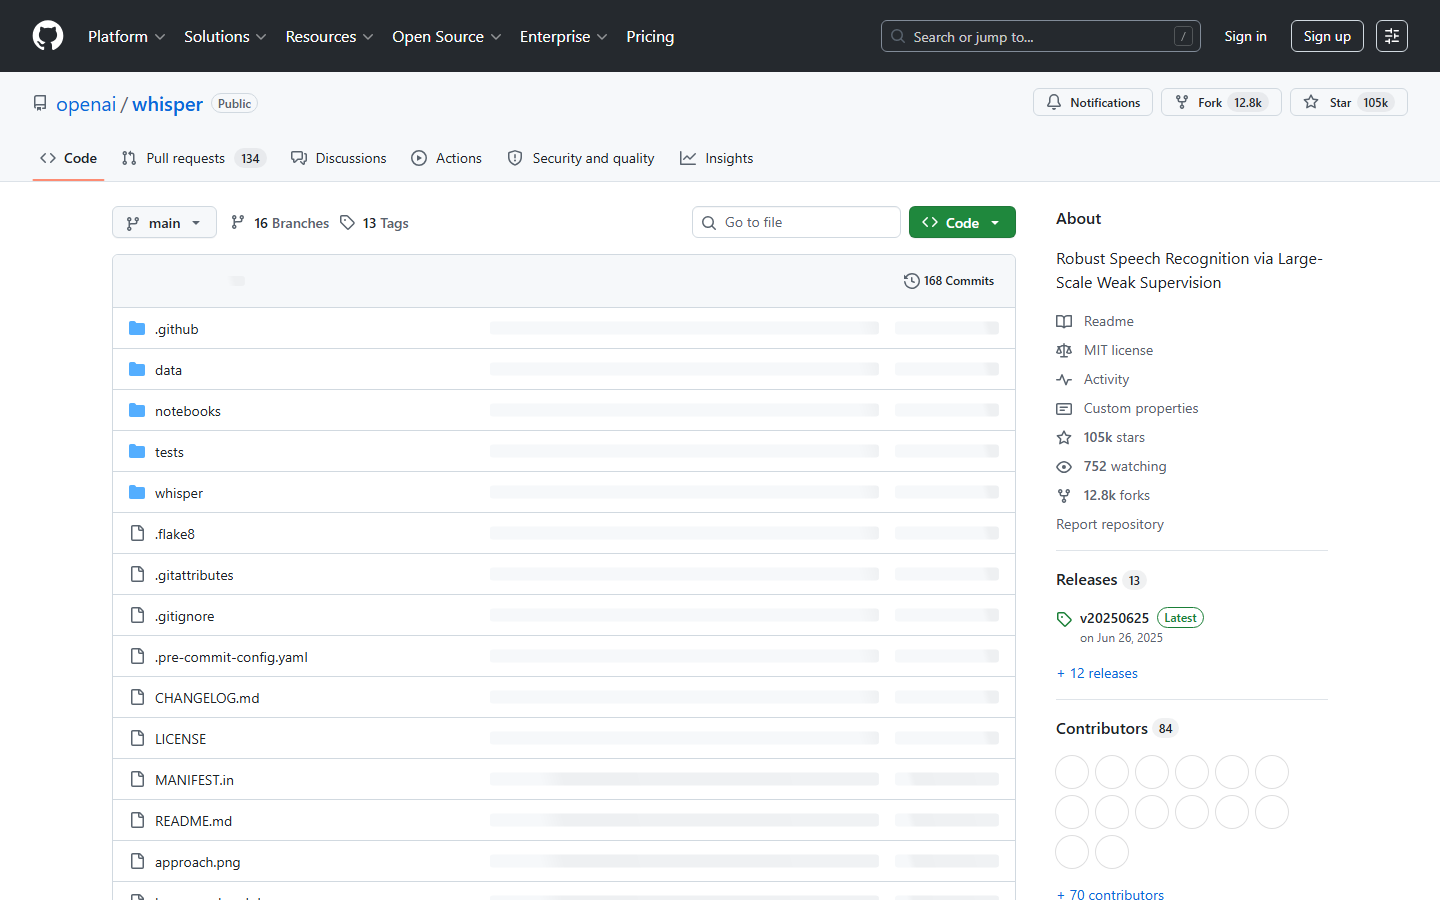
- کد منبع و راهنما (GitHub) ↗رسمی
- Whisper large-v3 (Hugging Face) ↗رسمی
نسخهٔ Transformers با قالب safetensors
- Whisper large-v3-turbo (Hugging Face) ↗رسمی
- BuzzASR/persian (Hugging Face) ↗غیررسمی
فاینتیون فارسی large-v3 با مجوز MIT؛ ساختهٔ OpenAI نیست.
نکات امنیتی
- ویسپر هش SHA-256 فایل مدل را با مقدار رسمی مقایسه میکند و اگر فایل کپیشده جور نباشد هشدار میدهد و دوباره دانلود میکند؛ این هشدار را نادیده نگیرید.
- فایلهای .pt قالب pickle پایتوناند و میتوانند کد اجرا کنند؛ فقط فایل رسمی را بارگذاری کنید. نسخههای Hugging Face قالب امنتر safetensors دارند.
- ابزارهای آنلاینی که «Whisper» در نامشان دارند لزوماً محلی نیستند؛ برای صدای محرمانه (جلسه، پرونده، مصاحبه) خود ویسپر را روی سیستم خودتان اجرا کنید.
برای شرکتها و سازمانها
ویسپر رابط وب یا سرور API ندارد؛ برای سرویس داخلی شرکت معمولاً آن را پشت یک اسکریپت یا سرویس پایتونی روی سروری با کارت انویدیا میگذارند و فایلها را دستهای پردازش میکنند.
برنامههایی که این مدل را اجرا میکنند
 اوداسیتی
 اوپن وبیوآی
 Buzz
 هندی (تایپ صوتی آفلاین)
 لوکالایآی
 میتیلی (متن و خلاصهٔ جلسه)
همسطح ابری
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۴ شهریور ۱۴۰۱
معرفی: ویسپر
ویسپر روی ۶۸۰ هزار ساعت صوت چندزبانه آموزش دیده و از انتشارش در ۲۰۲۲ به استاندارد متنباز تبدیل گفتار به متن تبدیل شده؛ دهها ابزار زیرنویس و ترنسکرایب روی آن ساخته شدهاند. برای فارسی جزو بهترین گزینههای در دسترس است — بهخصوص مدل large-v3 — و علاوه بر پیادهسازی، ترجمهٔ گفتار به انگلیسی هم انجام میدهد.
خود مدل رایگان است اما اجرای آن کمی فنی است (پایتون یا ابزارهایی مثل whisper.cpp) و مدل بزرگ به GPU نیاز دارد. نسخهٔ API ابری OpenAI پولی است. خروجی فارسی روی اسم خاص و اعداد گاهی خطا دارد و علائم نگارشی همیشه دقیق نیست.
برای فارسی یک فاینتیون تازه هم هست: BuzzASR Persian (سپتامبر ۲۰۲۶، مجوز MIT) که روی large-v3 ساخته شده و طبق کارت مدلش خطای نویسه (CER) را روی FLEURS از ۷٫۱۸٪ large-v3 اصلی به ۵٫۱۳٪ و روی Common Voice 25 از ۱۴٪ به ۴٫۰۵٪ رسانده است؛ این دو مجموعه در دادههای آموزشش هم بودهاند و گفتار محاورهای سنجیده نشده. با کتابخانهٔ Transformers اجرا میشود، نه با بستهٔ openai-whisper. از اجراکنندهها هم whisper.cpp به نسخهٔ 1.9.4 (۱۱ سپتامبر ۲۰۲۶) رسیده است.
بهترین کاربردها
- •فایل صوتی فارسی را به متن تبدیل کن
- •پادکست را به متن تبدیل کن
- •برای ویدئو زیرنویس خودکار بساز
- •برای فیلم زیرنویس فارسی بساز
- •صدای ویدئو را به متن تبدیل کن
- •گفتار فارسی را به انگلیسی ترجمه کن
- •مصاحبه را پیادهسازی کن
- •جلسه و کلاس را به متن تبدیل کن
برای این کارها سراغش نروید
- –تشخیص گویندههای مختلف در فایل صوتی
- –ویرایش ویدئو و چسباندن زیرنویس
- –تبدیل متن به گفتار فارسی
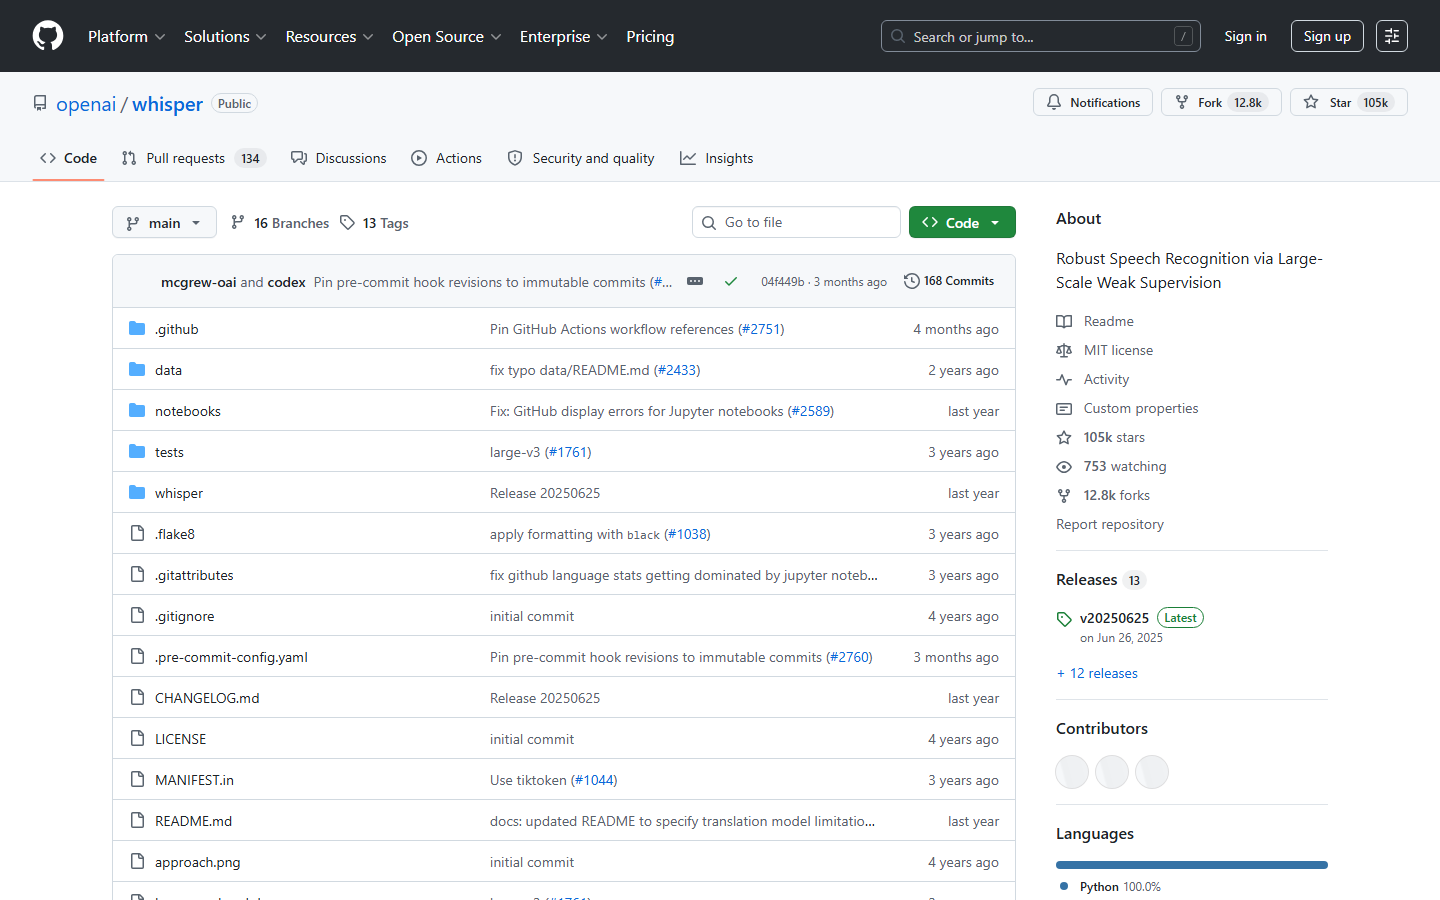
تصاویر محیط ابزار
نقاط قوت
- ✓دقت بالای فارسی در بین ابزارهای متنباز
- ✓رایگان و قابل اجرا روی سیستم شخصی
- ✓پایهٔ دهها ابزار زیرنویس و ترنسکرایب
- ✓ترجمهٔ گفتار به انگلیسی
- ✓فاینتیون فارسی BuzzASR (مجوز MIT) با خطای کمتر از large-v3 اصلی روی FLEURS و Common Voice
نقاط ضعف
- ✗راهاندازی محلی دانش فنی و GPU میخواهد
- ✗تشخیص گوینده (diarization) ندارد
- ✗روی اسم خاص و اعداد فارسی گاهی خطا میکند
نظرات کاربران (۵)
دنبال چیزی شبیه این بودم که رسیدم به. اگه ویدیو آموزش کوتاه بذارید عالیه
نقاط قوت و ضعف هر دو مشخص است؛ در مجموع مناسب به نظر میرسد.
دنبال چیزی شبیه این بودم که رسیدم به. در کل بد نیست و کار راه میندازه 👍 فقط گاهی کند میشه
برای نیاز حرفهای ما عملکرد قابل قبولی داشت.
اولش بهش خوشبین نبودم. کاش نسخهی فارسیش کاملتر بود
ابزارهای مشابه
مشاهده همه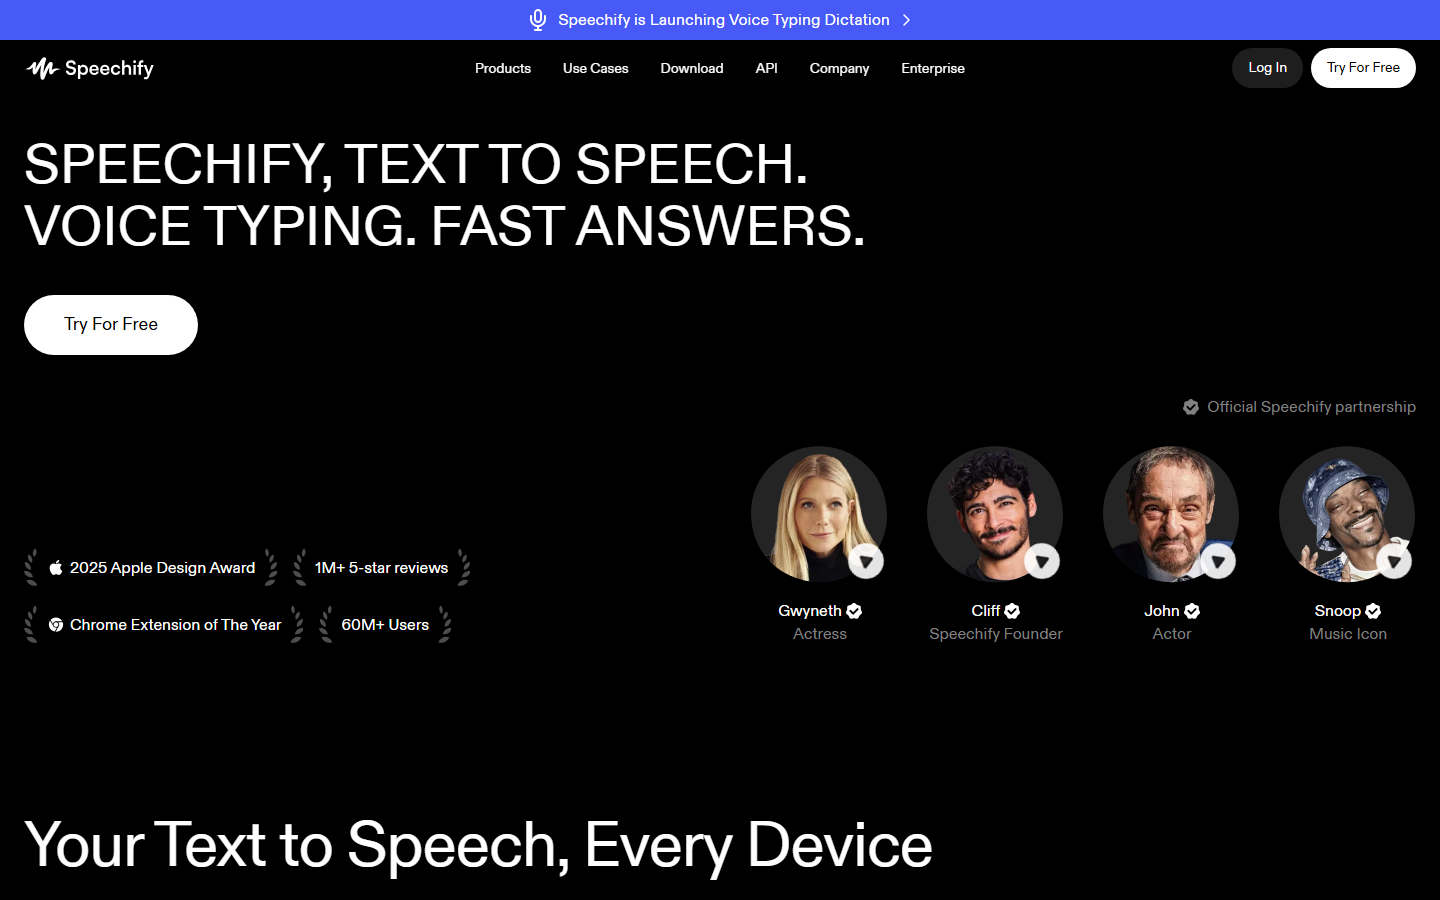
اسپیچیفای
Speechify
اپ محبوب «بخوان برایم»: مقاله، PDF، ایمیل و کتاب را با صدای طبیعی و حتی صدای سلبریتیها برایتان میخواند.
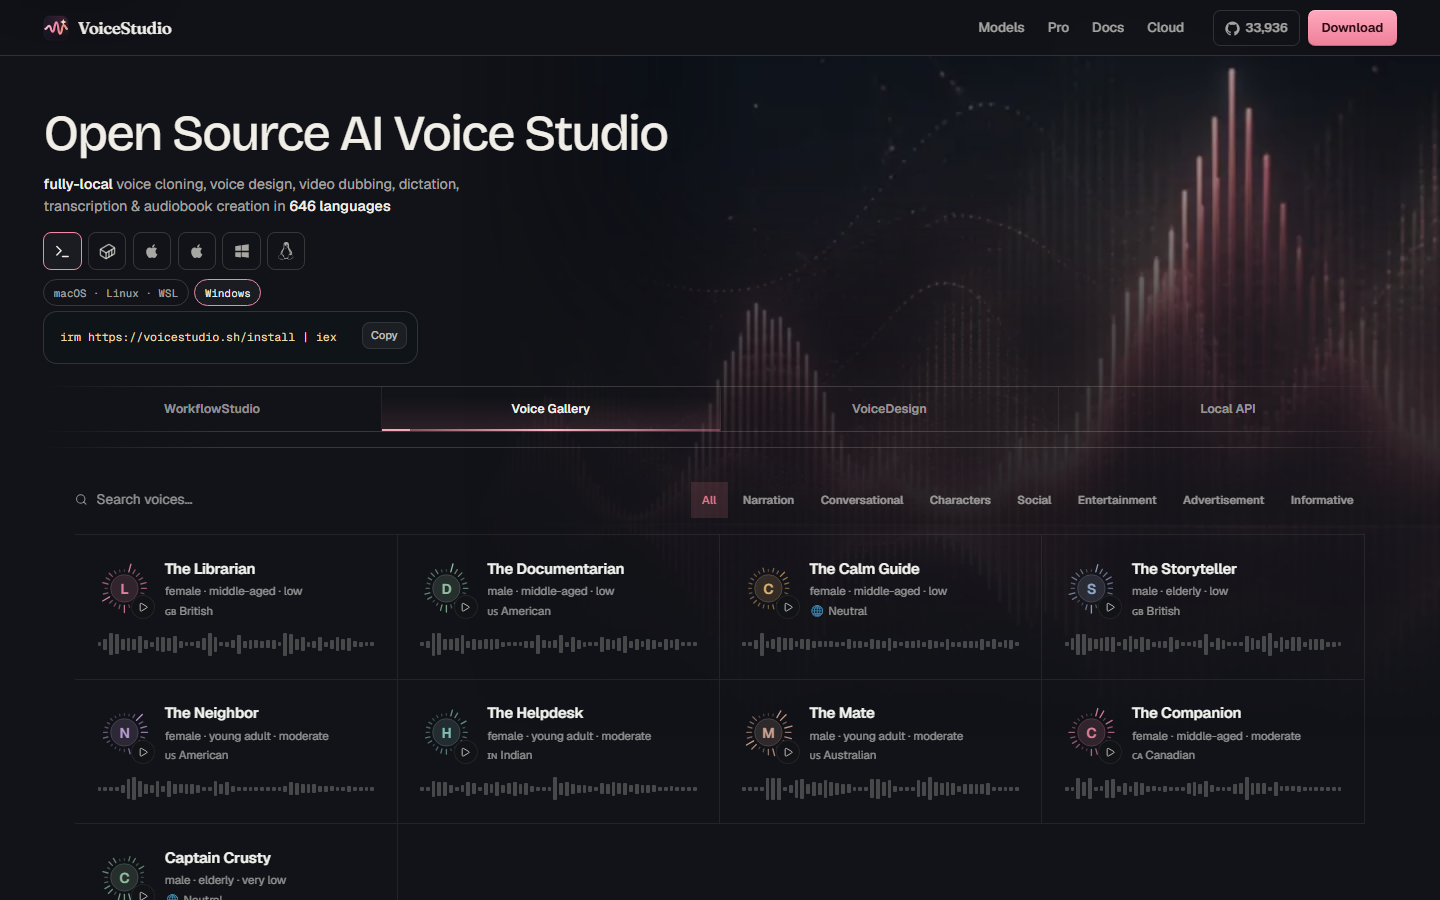
ویساستودیو
VoiceStudio
استودیوی صدای رایگان، متنباز و کاملاً آفلاین (نام قبلی OmniVoice Studio): کلون صدا از چند ثانیه نمونه، ساخت صدای جدید با توصیف، دوبلهٔ ویدئو و تبدیل گفتار به متن در ۶۴۶ زبان — از جمله فارسی — روی کامپیوتر خودتان.
مورف
Murf AI
استودیوی ساخت صدای گوینده با هوش مصنوعی؛ متن را تایپ میکنید و با صدها صدای طبیعی برای ویدئو، دورهٔ آموزشی و تبلیغ نریشن میگیرید.