اولاما
Ollamaمحصول اولاما
ابزار متنباز و رایگان برای اجرای مدلهای باز مثل Qwen3.5 و Gemma 4 روی ویندوز، مک و لینوکس: با یک دستور مدل را میگیرد و اجرا میکند، برنامهٔ چت دارد و API محلی روی پورت ۱۱۴۳۴ میدهد.
معرفی: اولاما
اولاما (Ollama) ابزاری متنباز (مجوز MIT) است که مدلهای باز را با یک دستور دانلود و روی کامپیوتر خودتان اجرا میکند؛ مثلاً ollama run qwen3.5 مدل را میگیرد و چت را در ترمینال باز میکند. کتابخانهٔ رسمی آن نسخههای آماده از Qwen3.5، Gemma 4، gpt-oss، Qwen3.8، Muse Glimmer و دهها مدل دیگر دارد. روی ویندوز و مک یک برنامهٔ چت ساده هم نصب میشود که فایل و تصویر میگیرد؛ روی لینوکس فقط خط فرمان و API هست.
بیشتر به کار برنامهنویسها و واحدهای IT میآید: یک API محلی روی http://localhost:11434 میدهد که با کلاینتهای OpenAI و Anthropic سازگار است، پس Open WebUI، افزونههای ویرایشگر کد و ابزارهای دیگر مستقیم به آن وصل میشوند. دستور ollama launch هم Claude Code، Codex یا OpenCode را با مدل محلی راه میاندازد.
سختافزار را مدل تعیین میکند: qwen3.5:4b حدود ۳٫۴ گیگابایت و qwen3.5:9b حدود ۶٫۶ گیگابایت است و روی لپتاپ ۸ و ۱۶ گیگ جا میشوند؛ مدلهای ۲۷ تا ۳۰ میلیاردی ۱۷ تا ۲۰ گیگ حجم دارند. کارتهای انویدیا (compute capability ۵٫۰ به بالا)، AMD و مکهای اپل شتاب میگیرند و بدون کارت گرافیک هم با رم اجرا میشود، فقط کندتر.
شروع: روی ویندوز OllamaSetup.exe را نصب کنید (دسترسی ادمین لازم نیست)، روی مک فایل dmg را و روی لینوکس اسکریپت نصب را اجرا کنید؛ بعد ollama run qwen3.5:9b کافی است. فایلهای نصب در واقع از بخش Releases گیتهاب دانلود میشوند.
نکتهٔ مهم: همهٔ مدلهای اولاما آفلاین نیستند. تگهایی که cloud دارند (مثل deepseek-v4-flash:cloud) روی سرورهای Ollama در آمریکا و اروپا اجرا میشوند، اینترنت و ورود به حساب میخواهند و بعد از سهمیهٔ رایگان پولیاند. اگر میخواهید مطمئن باشید چیزی از سیستم بیرون نمیرود، OLLAMA_NO_CLOUD=1 را تنظیم کنید.
تازهها: نسخهٔ 0.35.1 (۲۹ سپتامبر ۲۰۲۶) «مدلهای تصمیمگیر» را از راه /v1/systemone اضافه کرد که بهجای متن، گزینه، احتمال و امتیاز برمیگردانند، و جستوجوی وب را تا ۱۰ پرسش برای هر پاسخ بالا برد.
نسخهٔ 0.40.2 (۸ اکتبر ۲۰۲۶): از 0.40 به بعد، روی مکهای اپل سیلیکون مدلهایی که معماریشان پشتیبانی میشود بهطور پیشفرض با موتور MLX اجرا میشوند و مدلهایی که قبلاً دانلود کردهاید در اولین اجرا در پسزمینه بهروز میشوند. تکرار مدلها در فهرست ollama list رفع شده و ollama launch claude حالا از کل حافظهٔ متنی مدل استفاده میکند. دو مدل محلی تازه هم به کتابخانه آمده: qwen3.8-flash-next، قویترین Qwen برای اجرا روی سیستم شخصی که نسخهٔ ۴ بیتیاش ۱۲۰ گیگابایت است و فقط به سیستمهای پرحافظه میخورد، و embeddinggemma-2 گوگل (۳۷۸ مگابایت تا ۱٫۳ گیگابایت) برای جستوجو در متن، عکس، صدا و ویدیو بر اساس معنا. mistral-large-4 در کتابخانه فقط ابری است و آفلاین اجرا نمیشود.
بهترین کاربردها
- •مدل هوش مصنوعی رو با یه دستور روی لپتاپ اجرا کنم
- •بدون اینترنت با Qwen3.5 فارسی چت کنم
- •روی سرور شرکت یه API داخلی شبیه ChatGPT راه بندازم
- •Open WebUI رو به یه مدل محلی وصل کنم
- •برای RAG اسناد شرکت، بردار متن (embedding) بسازم بدون فرستادن داده به بیرون
- •Claude Code یا Codex رو با مدل محلی اجرا کنم
- •از روی عکس یا اسکن سند با مدل OCR محلی متن دربیارم
- •فایل GGUF دانلودشده رو بدون اینترنت اجرا کنم
برای این کارها سراغش نروید
- –ساخت تصویر یا ویدئو
- –چت با رابط فارسی و راستچین
- –اجرای مدل روی گوشی موبایل
- –آموزش یا فاینتیون مدل
اجرا روی سیستم خودتان
این برنامه را روی سیستم خودتان نصب میکنید و هوش مصنوعی روی همان دستگاه اجرا میشود؛ متن و فایلهایتان از آن بیرون نمیرود.
- بعد از نصب، بدون اینترنت
- متنباز
- MIT — استفادهٔ تجاری آزاد
- برنامهٔ گرافیکی
- خط فرمان
- API
بعد از دانلود مدل (ollama pull) همهچیز آفلاین کار میکند. مدلهای cloud، جستجوی وب و ورود به حساب اینترنت میخواهند؛ با OLLAMA_NO_CLOUD=1 یا گزینهٔ disable_ollama_cloud در ~/.ollama/server.json این بخشها کاملاً خاموش میشوند. در اولین اجرا گزینهٔ ادامه بهصورت محلی (بدون ورود) هم هست.
استفادهٔ تجاری، تغییر و بازنشر آزاد است. مجوز هر مدل جداست و باید جدا بررسی شود.
سختافزار لازم
- حداقل رم: ۸ گیگابایت — پیشنهادی: ۱۶ گیگابایت
- کارت گرافیک اختیاری است
- ویندوز ۱۰ (22H2) به بعد، macOS 14 به بعد (مک اپل با GPU؛ مک اینتل فقط CPU) یا لینوکس؛ دستکم ۴ گیگ فضا برای خود برنامه. عدد رم برآورد برای qwen3.5:4b است (۳٫۴ گیگ × ۱٫۲ + ۲ گیگ سیستمعامل ≈ ۷ گیگ). کارت انویدیا با compute capability ۵٫۰ به بالا و درایور ۵۵۰ به بعد؛ AMD با ROCm 7 یا Vulkan.
نصب و اجرا
- ۱
روی ویندوز نصب کنیدویندوز
irm https://ollama.com/install.ps1 | iexدر PowerShell بزنید؛ یا فایل OllamaSetup.exe را از صفحهٔ دانلود بگیرید. دسترسی ادمین لازم نیست.
- ۲
روی لینوکس یا مک نصب کنیدلینوکس
curl -fsSL https://ollama.com/install.sh | shروی مک (macOS 14 به بعد) میشود فایل Ollama.dmg را هم نصب کرد.
- ۳
یک مدل فارسیدان اجرا کنید
ollama run qwen3.5:9bحدود ۶٫۶ گیگ دانلود میشود؛ روی سیستم ضعیفتر qwen3.5:4b (۳٫۴ گیگ).
- ۴
بدون اینترنت: فایل GGUF را وارد کنید
ollama create qwen35-local -f Modelfileداخل Modelfile بنویسید FROM ./Qwen3.5-9B-Q4_K_M.gguf؛ فایل GGUF را قبلاً روی سیستم دیگری گرفتهاید.
- ۵
قابلیتهای ابری را خاموش کنید (اختیاری)لینوکس
OLLAMA_NO_CLOUD=1 ollama serveدر ویندوز و مک همین متغیر را در متغیرهای محیطی بگذارید، یا در ~/.ollama/server.json مقدار disable_ollama_cloud را true کنید.
دانلود
- Ollama download page ↗رسمی
ویندوز، مک و لینوکس؛ فایلها از گیتهاب دانلود میشوند
- GitHub Releases (v0.40.2) ↗رسمی
همهٔ نسخهها همراه sha256sum.txt برای بررسی فایل
- Ollama model library ↗رسمی
فهرست مدلها؛ تگهای cloud آفلاین نیستند
- Docker Hub: ollama/ollama ↗رسمی
نکات امنیتی
- پورت ۱۱۴۳۴ را روی اینترنت باز نکنید: Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و API محلی رمز ندارد. اگر OLLAMA_HOST=0.0.0.0 میگذارید، فقط پشت فایروال یا پروکسی با احراز هویت.
- برای اطمینان از اینکه هیچ درخواستی به سرورهای Ollama نمیرود، OLLAMA_NO_CLOUD=1 را تنظیم کنید؛ در لاگ باید Ollama cloud disabled: true دیده شود.
- فایل نصب را فقط از ollama.com یا گیتهاب رسمی بگیرید و با sha256sum.txt مقایسه کنید.
- وقتی با ollama launch به مدل اجازهٔ اجرای دستور و ویرایش فایل میدهید، کارهای برگشتناپذیر را دستی تأیید کنید.
برای شرکتها و سازمانها
برای سرور شرکت مناسب است: روی لینوکس سرویس systemd دارد، با OLLAMA_NUM_PARALLEL و OLLAMA_MAX_LOADED_MODELS چند درخواست و چند مدل را همزمان مدیریت میکند و Docker با GPU انویدیا و AMD پشتیبانی میشود. کاربر و رمز ندارد؛ برای چند کاربر آن را پشت Open WebUI یا پروکسی با احراز هویت بگذارید. برای بار سنگین و کاربران زیاد، vLLM گزینهٔ پرتوانتری است.
مدلهایی که با این برنامه اجرا میشوند
 کوئن ۳.۵ (آفلاین)
 جما ۴ (آفلاین)
 کوئن ۳ کدر (آفلاین)
 کوئن ۳ ویال (آفلاین)
 کوئن ۳.۸ 27B (آفلاین)
 میمو ۲.۶ (آفلاین)
 اورنیث ۱.۵ (آفلاین)
 جیپیتی اواساس (آفلاین)
 ترنسلیتجما (آفلاین)
 جیالام اوسیآر (آفلاین)
 کوئن ۳.۸ فلش نکست (آفلاین)
 نموترون ۳.۵ لایتنینگ (آفلاین)
آخرین بررسی: ۱۷ مهر ۱۴۰۵
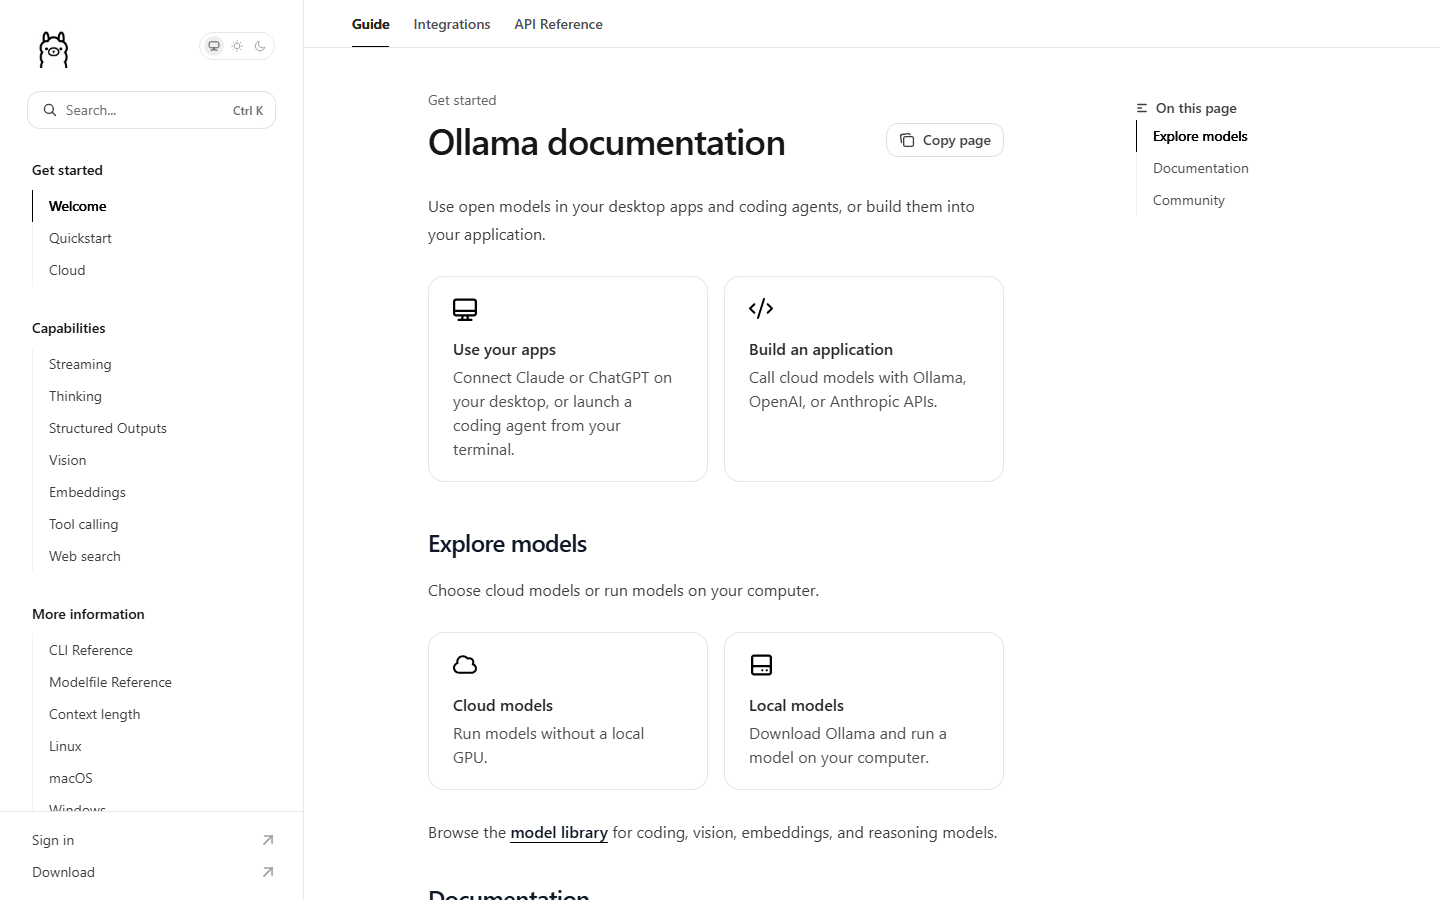
تصاویر محیط ابزار
نقاط قوت
- ✓متنباز (MIT) و رایگان؛ نصب ساده روی ویندوز، مک و لینوکس و بدون نیاز به ادمین در ویندوز
- ✓کتابخانهٔ آمادهٔ مدلها با یک دستور: Qwen3.5، Gemma 4، gpt-oss، Qwen3.8 و مدلهای بردارسازی و OCR
- ✓API محلی سازگار با OpenAI و Anthropic؛ به Open WebUI، ویرایشگرهای کد و عاملهای کدنویسی وصل میشود
- ✓روی مکهای اپل با موتور MLX و روی کارتهای انویدیا و AMD شتاب میگیرد
- ✓قابلیتهای ابری را میشود کاملاً خاموش کرد (OLLAMA_NO_CLOUD)
- ✓واردکردن فایل GGUF از دیسک با Modelfile، بدون نیاز به مخزن آنلاین Ollama
نقاط ضعف
- ✗فایل نصب ویندوز حدود ۱٫۶ گیگابایت است و یک مدل خوب فارسی مثل qwen3.5:9b هم ۶٫۶ گیگ دیگر دانلود و حدود ۸ گیگ حافظهٔ گرافیک یا ۱۰ گیگ رم آزاد میخواهد (برآورد)
- ✗بعضی مدلهای کتابخانه فقط ابریاند و اینترنت، حساب کاربری و پول میخواهند؛ باید حواستان به تگ cloud باشد
- ✗برنامهٔ دسکتاپ ساده است، رابط فارسی ندارد و پاسخ فارسی را راستچین نشان نمیدهد
- ✗API محلی رمز ندارد؛ اگر روی شبکه بازش کنید، باید خودتان پشت پروکسی با احراز هویت بگذارید
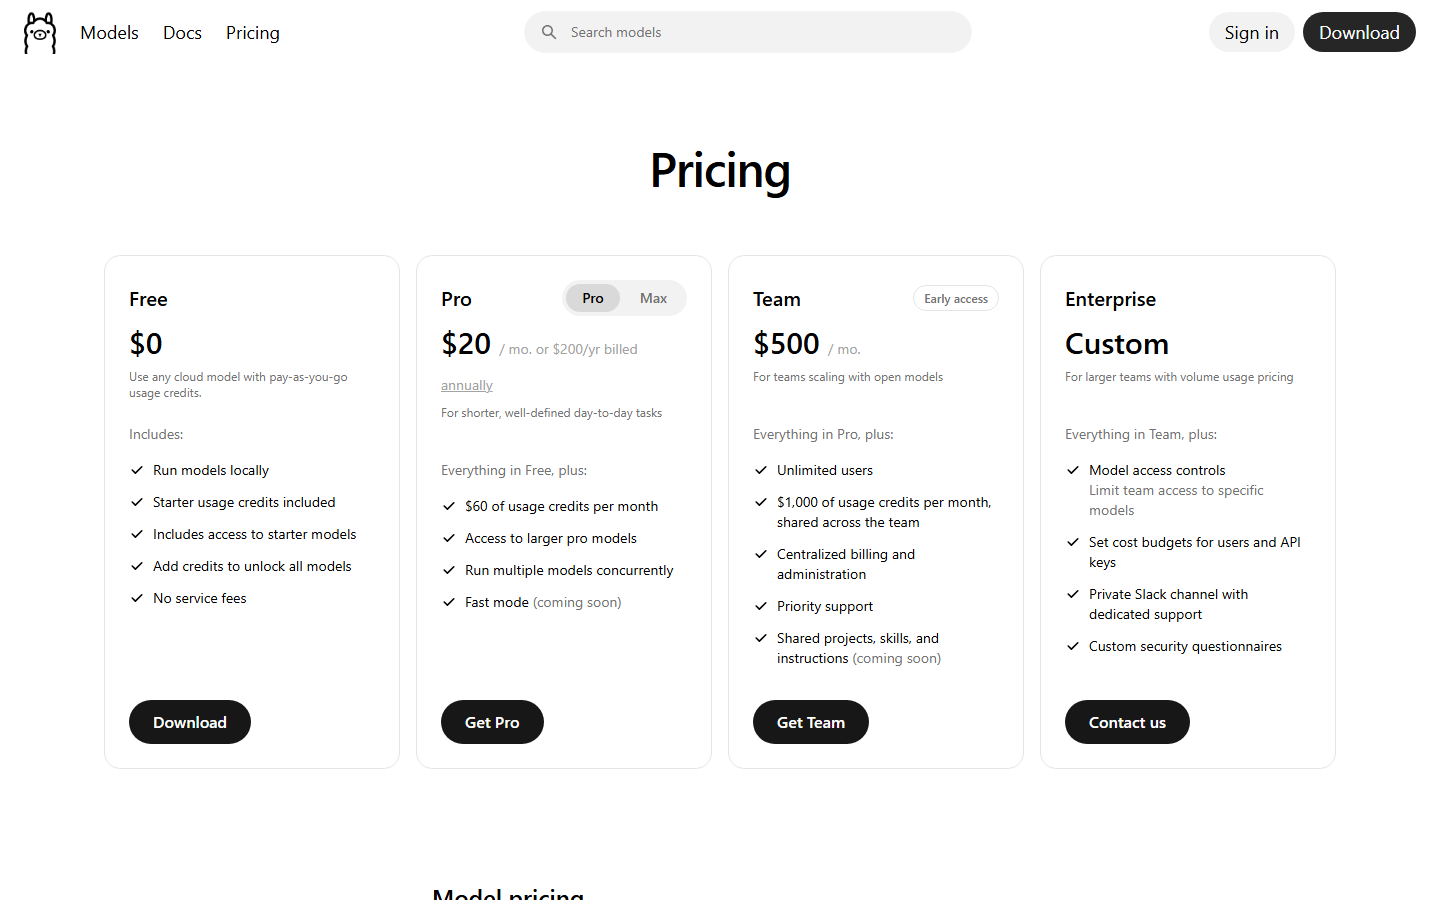
قیمتگذاری
رایگان
Freeرایگان
- • اجرای مدلهای محلی بدون محدودیت
- • سهمیهٔ کم ماهانه برای چند مدل ابری پایه
- • خرید اعتبار بهازای مصرف، بدون اشتراک
پرو
Pro$20 در ماه
- • ۶۰ دلار اعتبار مصرف مدلهای ابری در ماه
- • دسترسی به مدلهای ابری بزرگتر
- • اجرای همزمان چند مدل
- • سالانه ۲۰۰ دلار
مکس
Max$100 در ماه
- • ۳۰۰ دلار اعتبار مصرف در ماه
- • دسترسی زودتر به مدلهای تازه
- • ۱۰ درخواست همزمان
تیم
Team$500 در ماه
- • ۱٬۰۰۰ دلار اعتبار مشترک در ماه برای کاربران نامحدود
- • صورتحساب و مدیریت متمرکز
- • پشتیبانی اولویتدار
- • فعلاً در مرحلهٔ دسترسی اولیه
سازمانی
Enterpriseتماس / سفارشی
- • قیمت حجمی توافقی
- • محدودکردن دسترسی تیم به مدلهای مشخص و بودجهبندی هزینه
قیمتها تقریبی و بر اساس آخرین بازبینی است؛ برای قیمت دقیق به سایت رسمی مراجعه کنید.
پرسشهای پرتکرار
Ollama رایگان است؟
بله. خود Ollama متنباز (MIT) است و اجرای مدل روی سیستم خودتان هزینهای ندارد. فقط مدلهای ابری (تگهای cloud) بعد از سهمیهٔ رایگان پولیاند؛ پلن Pro ماهی ۲۰ دلار است.
چه سیستمی لازم دارم؟
ویندوز ۱۰ نسخهٔ 22H2 به بعد، macOS 14 به بعد یا لینوکس. کارت گرافیک اجباری نیست ولی سرعت را خیلی بیشتر میکند. برای qwen3.5:4b (۳٫۴ گیگ) لپتاپ ۸ گیگ و برای qwen3.5:9b (۶٫۶ گیگ) لپتاپ ۱۶ گیگ یا کارت گرافیک ۸ گیگ کافی است (برآورد).
کدام مدل برای فارسی مناسب است؟
Qwen3.5 فارسی را در فهرست رسمی زبانهایش دارد؛ با ollama run qwen3.5:9b شروع کنید و اگر سیستم ضعیف است qwen3.5:4b. برای ترجمه translategemma و برای فهم تصویر gemma4 هم هست. رابط خود Ollama فارسی ندارد.
مدلهای cloud چه فرقی دارند؟
این مدلها روی سرورهای Ollama در آمریکا و اروپا اجرا میشوند، نه روی کامپیوتر شما. اینترنت و ورود به حساب (ollama signin) میخواهند و بعد از سهمیهٔ رایگان پولیاند. برای کار آفلاین تگی بدون cloud انتخاب کنید یا با OLLAMA_NO_CLOUD=1 آنها را کاملاً خاموش کنید.
میشود روی سرور شرکت برای چند نفر راهش انداخت؟
بله. روی لینوکس سرویس systemd دارد و با OLLAMA_NUM_PARALLEL چند درخواست را همزمان جواب میدهد. ولی API آن رمز ندارد؛ آن را پشت Open WebUI یا Nginx با احراز هویت بگذارید و پورت ۱۱۴۳۴ را روی اینترنت باز نکنید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
لاما سیپیپی
llama.cpp
موتور متنباز (MIT) اجرای مدلهای GGUF که خیلی از برنامههای محلی رویش ساخته شدهاند؛ llama serve یک سرور سازگار با OpenAI همراه رابط وب چت، روی هر سختافزاری از لپتاپ تا سرور، راه میاندازد.
لوکالایآی
LocalAI
جایگزین خودمیزبان API اوپنایآی: متن، تصویر، گفتار و بردارسازی را با یک API روی سرور یا کامپیوتر خودتان اجرا میکند، حتی بدون کارت گرافیک. رایگان و متنباز (MIT).
الام استودیو
LM Studio
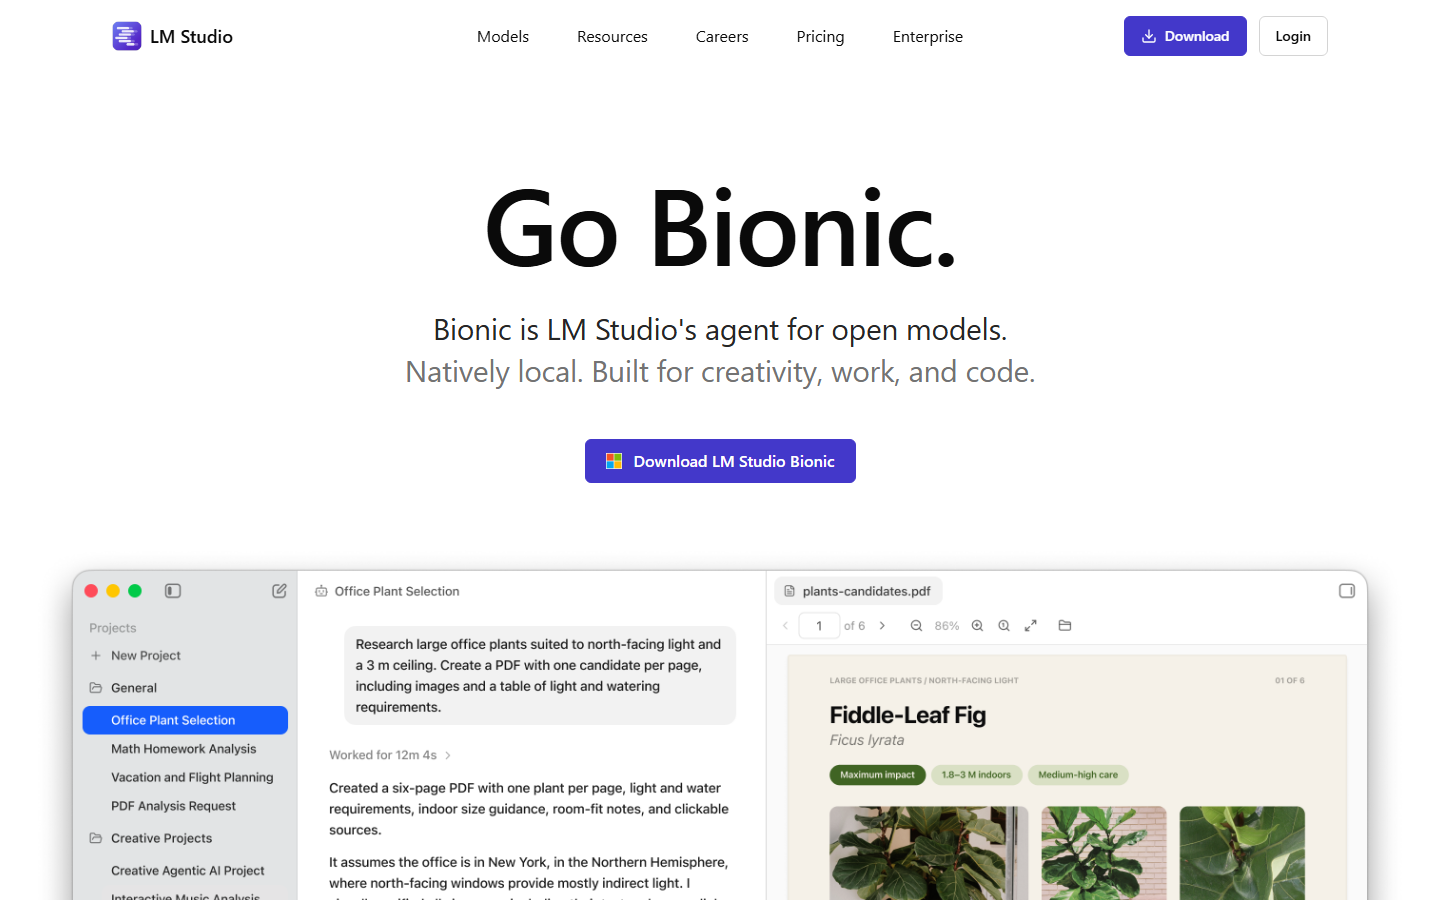
برنامهٔ رایگان ویندوز، مک و لینوکس برای دانلود و اجرای مدلهای زبانی روی کامپیوتر خودتان: چت آفلاین، گفتوگو با اسناد، سرور API سازگار با OpenAI و ایجنت Bionic برای کار و کدنویسی.