کوئن ۳ ایاسآر (آفلاین)
Qwen3-ASR (offline)مدلهای متنباز تبدیل گفتار به متن Qwen (0.6B و 1.7B) با مجوز Apache-2.0 برای ۳۰ زبان؛ فارسی رسماً پشتیبانی میشود ولی دقتش پایین است (خطای کلمه حدود ۳۰٪).
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- Apache-2.0 — استفادهٔ تجاری آزاد
- فارسی: ضعیف
بستهٔ qwen-asr مدل را با نامش از اینترنت دانلود میکند. برای کار آفلاین، مدل را یک بار در یک پوشه دانلود کنید و مسیر همان پوشه را به جای نام مدل بدهید؛ بعد از آن اینترنت لازم نیست.
استفادهٔ تجاری، تغییر و بازنشر آزاد است؛ متن مجوز را همراه مدل نگه دارید.
نسخهها و سختافزار لازم
- Qwen3-ASR-0.6B۶۰۰M
- حافظهٔ لازم:
- کارت گرافیک ۳ گیگ یا رم ۵ گیگ
سبک و بسیار پرسرعت؛ طبق Qwen در همزمانی ۱۲۸ درخواست به «توان پردازشی ۲۰۰۰ برابر» میرسد. برای فارسی ضعیف است: خطای کلمه روی FLEURS حدود ۵۴٪. رم و حافظهٔ گرافیک تخمینی.
- Qwen3-ASR-1.7B۱٫۷B
- حافظهٔ لازم:
- کارت گرافیک ۶ گیگ یا رم ۸ گیگ
دقیقترین نسخه؛ خطای کلمهٔ فارسی روی FLEURS حدود ۳۰٪ در برابر حدود ۳٫۴٪ برای انگلیسی. رم و حافظهٔ گرافیک تخمینی.
نصب و اجرا
- ۱
بستهٔ qwen-asr را نصب کنید
pip install -U qwen-asrسازنده محیط تازهٔ پایتون ۳.۱۲ را پیشنهاد میکند. برای سرعت بیشتر و پخش زنده روی لینوکس: pip install -U "qwen-asr[vllm]".
- ۲
مدل را یک بار در یک پوشه دانلود کنید
hf download Qwen/Qwen3-ASR-1.7B --local-dir ./Qwen3-ASR-1.7Bمسیر جایگزین رسمی: modelscope download --model Qwen/Qwen3-ASR-1.7B --local_dir ./Qwen3-ASR-1.7B. این پوشه را میتوانید به سیستم آفلاین منتقل کنید.
- ۳
رابط وب محلی را اجرا کنیدلینوکس
qwen-asr-demo --asr-checkpoint ./Qwen3-ASR-1.7B --backend transformers --cuda-visible-devices 0 --ip 127.0.0.1 --port 8000آدرس http://127.0.0.1:8000 را باز کنید و فایل صوتی بدهید. با 127.0.0.1 سرویس فقط روی همین کامپیوتر در دسترس است.
- ۴
سرور API برای شرکت (vLLM)لینوکس
qwen-asr-serve ./Qwen3-ASR-1.7B --gpu-memory-utilization 0.8 --host 127.0.0.1 --port 8000API سازگار با OpenAI میدهد (مسیرهای chat/completions و transcriptions). برای دسترسی از شبکهٔ داخلی، آن را پشت پراکسی با احراز هویت بگذارید.
دانلود
- Qwen/Qwen3-ASR-1.7B (Hugging Face) ↗رسمی
نسخهٔ دقیقتر، حدود ۴٫۷ گیگابایت.
- Qwen/Qwen3-ASR-0.6B (Hugging Face) ↗رسمی
نسخهٔ سبک، حدود ۱٫۹ گیگابایت.
- ModelScope ↗رسمی
آینهٔ رسمی علیبابا.
- QwenLM/Qwen3-ASR (GitHub) ↗رسمی
کد، راهنما و نمونهها.
- qwen-asr (PyPI) ↗رسمی
بستهٔ پایتون رسمی.
نکات امنیتی
- در دستورهای نمونهٔ سازنده --ip 0.0.0.0 آمده که سرویس را روی کل شبکه باز میکند؛ برای استفادهٔ شخصی 127.0.0.1 بگذارید.
- فایلهای صوتی محرمانه روی همین سیستم پردازش میشوند؛ پوشهٔ خروجی و لاگها را روی سرور مشترک محافظت کنید.
- مدل را فقط از مخزن رسمی Qwen بگیرید؛ فایلها safetensors هستند.
برای شرکتها و سازمانها
برای شرکتها گزینهٔ خوبی برای پیادهسازی انبوه فایلهای انگلیسی، عربی، ترکی و چینی روی سرور داخلی است؛ qwen-asr-serve با vLLM درخواستهای همزمان را پاسخ میدهد. برای فارسی دقت فعلی کافی نیست.
برنامههایی که این مدل را اجرا میکنند
 ویالالام
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۵ دی ۱۴۰۴
معرفی: کوئن ۳ ایاسآر (آفلاین)
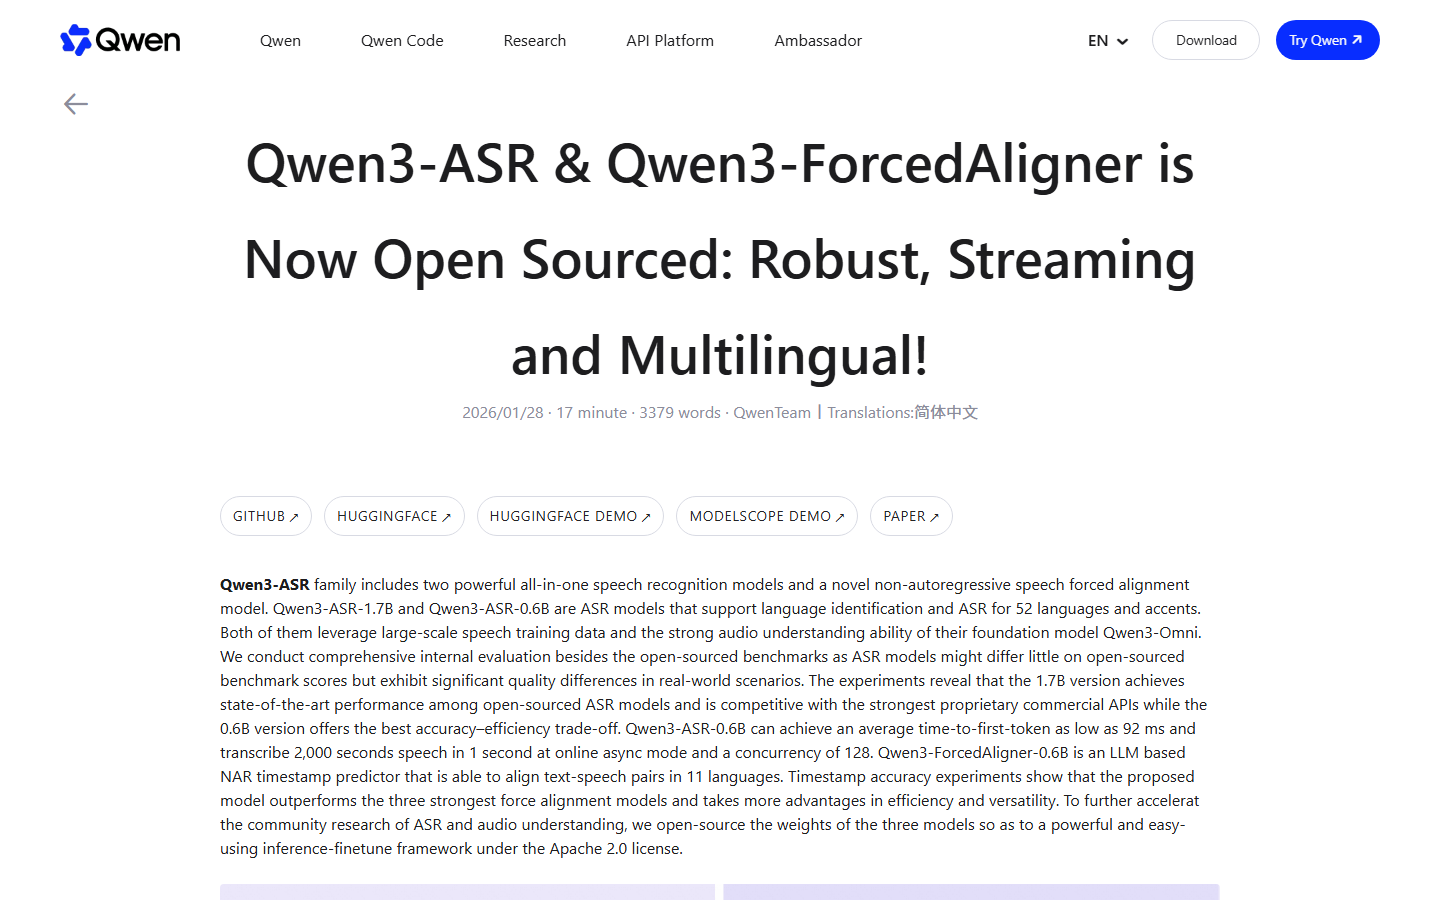
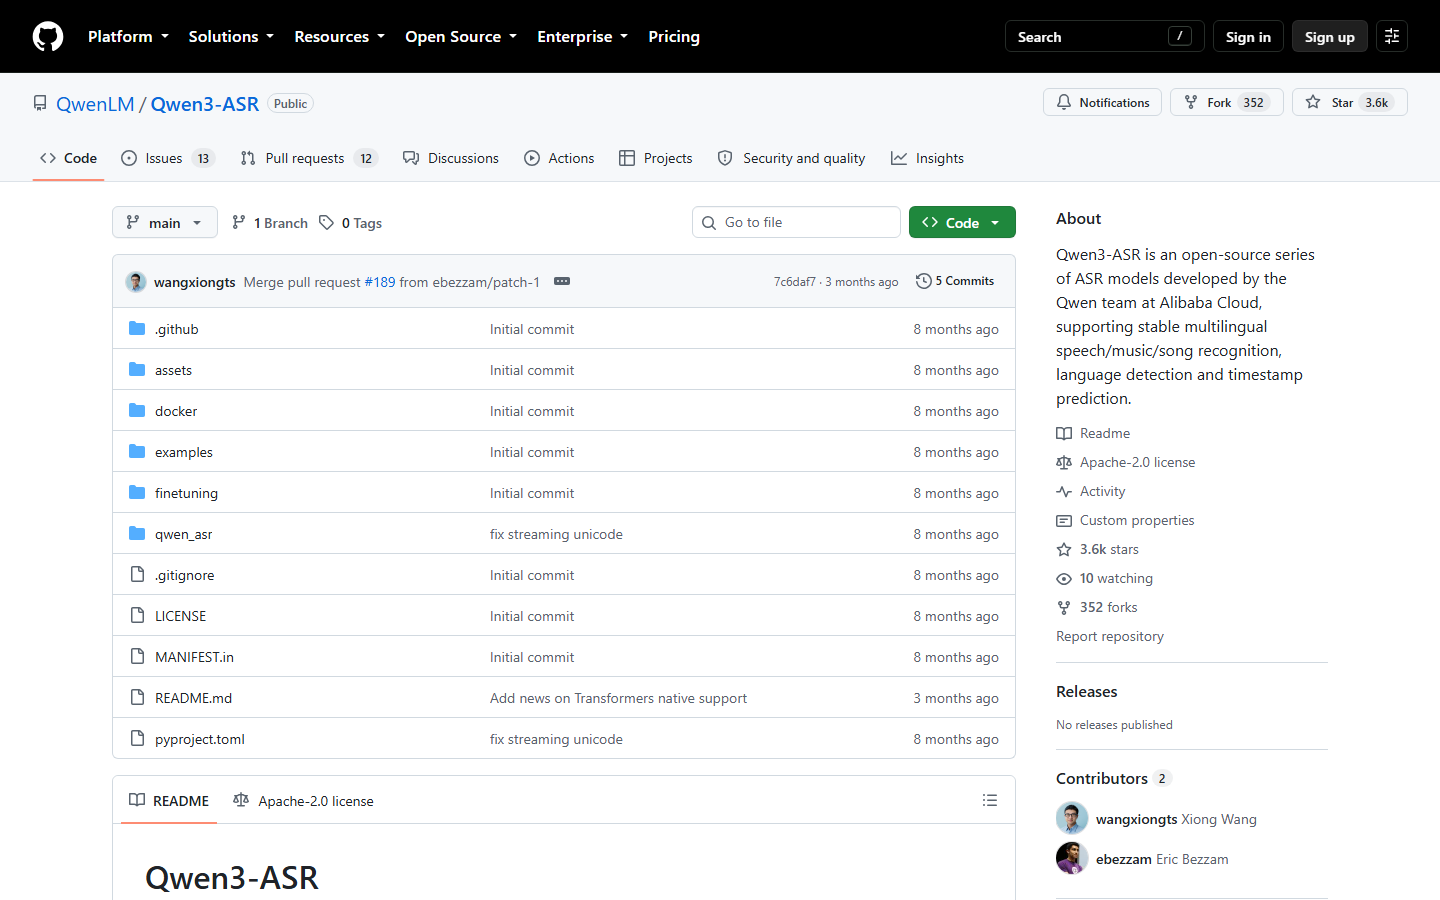
Qwen3-ASR دو مدل تبدیل گفتار به متن از تیم Qwen علیباباست که ژانویهٔ ۲۰۲۶ با مجوز Apache-2.0 منتشر شد: 0.6B برای سرعت و 1.7B برای دقت. ۳۰ زبان و ۲۲ گویش چینی را میشناسد، زبان صدا را خودش تشخیص میدهد و حتی آواز و آهنگِ همراه با موسیقی را هم به متن تبدیل میکند.
فارسی در فهرست رسمی هست، اما گزارش فنی خود Qwen خطای کلمهٔ فارسی روی آزمون FLEURS را برای 1.7B حدود ۳۰٪ و برای 0.6B حدود ۵۴٪ نشان میدهد؛ برای انگلیسی این عدد حدود ۳٪ است. یعنی متن فارسی خروجی ویرایش جدی میخواهد. در جدول خود Qwen، روی گروه زبانهایی که فارسی هم جزو آن است، Whisper large-v3 خطای کمتری داشته است.
سختافزار سبک است: فایل 1.7B حدود ۴٫۷ و 0.6B حدود ۱٫۹ گیگابایت است و کارت گرافیک ۶ گیگابایتی برای 1.7B کافی به نظر میرسد (تخمین ما). برای سرور، پشتیبانی vLLM و پخش زنده (streaming) دارد.
شروع: بستهٔ پایتون qwen-asr را نصب کنید، مدل را یک بار دانلود کنید و رابط وب محلی qwen-asr-demo را اجرا کنید. برای شرکتها، دستور qwen-asr-serve یک API سازگار با OpenAI بالا میآورد.
محدودیت دیگر: مدل زمانبندی کلمهها (Qwen3-ForcedAligner) فقط ۱۱ زبان دارد و فارسی جزو آن نیست؛ پس زیرنویس فارسیِ زماندار مستقیم از این ابزار بیرون نمیآید.
بهترین کاربردها
- •فایل صوتی انگلیسی جلسه را بدون اینترنت به متن تبدیل کنم
- •پادکست را بدون آپلود روی کامپیوتر خودم پیاده کنم
- •زیرنویس انگلیسی زماندار برای ویدیو آفلاین بسازم
- •روی سرور شرکت سرویس داخلی تبدیل گفتار به متن راه بیندازم
- •صدای عربی یا ترکی را آفلاین به متن تبدیل کنم
- •متن آهنگ را از روی فایل صوتی استخراج کنم
- •پیشنویس متن فایل صوتی فارسی را آفلاین بگیرم و بعد ویرایش کنم
برای این کارها سراغش نروید
- –پیادهسازی دقیق صدای فارسی بدون ویرایش
- –زیرنویس فارسی زماندار
- –کامپیوتر بدون کارت گرافیک
- –ترجمهٔ خودکار گفتار
تصاویر محیط ابزار
نقاط قوت
- ✓مجوز Apache-2.0 و استفادهٔ تجاری آزاد
- ✓۳۰ زبان با تشخیص خودکار زبان؛ حتی آواز و آهنگ را متن میکند
- ✓سبک: 0.6B حدود ۱٫۹ و 1.7B حدود ۴٫۷ گیگابایت
- ✓سرور vLLM، پخش زنده و پردازش فایلهای طولانی برای شرکتها
- ✓در انگلیسی و چینی همسطح بهترین سرویسهای تجاری (طبق Qwen)
نقاط ضعف
- ✗برای اجرای راحت کارت گرافیک انویدیا لازم است (حدود ۶ گیگابایت برای 1.7B، تخمینی) و راهاندازی با پایتون انجام میشود
- ✗دقت فارسی پایین: خطای کلمه روی FLEURS حدود ۳۰٪ (1.7B) و ۵۴٪ (0.6B)
- ✗زمانبندی کلمهها برای زیرنویس، فارسی را پشتیبانی نمیکند
- ✗رابط گرافیکی کامل ندارد؛ فقط دموی وب و خط فرمان
پرسشهای پرتکرار
برای پیاده کردن فایل صوتی فارسی خوب است؟
برای پیشنویس شاید، برای متن نهایی نه. طبق گزارش Qwen خطای کلمهٔ فارسی در نسخهٔ 1.7B حدود ۳۰٪ است؛ یعنی تقریباً از هر سه کلمه یکی نیاز به اصلاح دارد.
زیرنویس فارسی زماندار میسازد؟
مستقیم نه. مدل زمانبندی Qwen3-ForcedAligner فقط ۱۱ زبان دارد و فارسی جزو آن نیست. برای زبانهایی مثل انگلیسی و آلمانی زمانبندی کلمهبهکلمه میدهد.
بدون کارت گرافیک اجرا میشود؟
همهٔ نمونههای رسمی با کارت انویدیا (CUDA) هستند و سازنده اجرای CPU را مستند نکرده است.
برای شرکت و چند کاربر مناسب است؟
بله. دستور qwen-asr-serve یک سرور vLLM با API سازگار با OpenAI بالا میآورد و طبق Qwen، نسخهٔ 0.6B در همزمانی ۱۲۸ درخواست به «توان پردازشی ۲۰۰۰ برابر» میرسد.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه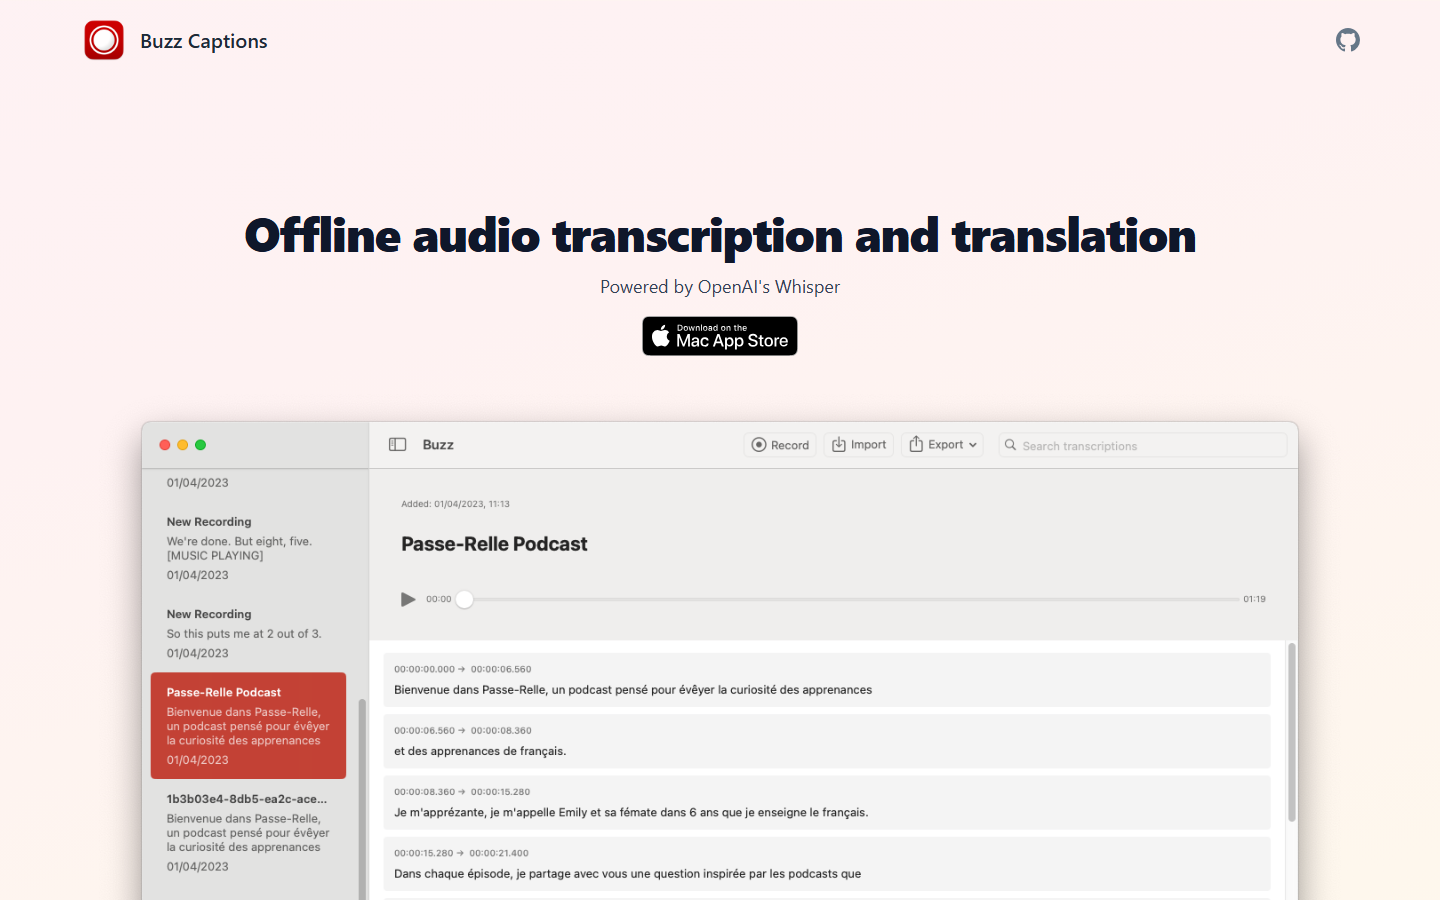
Buzz
Buzz
برنامهٔ دسکتاپ رایگان و متنباز برای تبدیل گفتار به متن و ساخت زیرنویس SRT و VTT بدون اینترنت با Whisper؛ گفتار فارسی را هم متن میکند. ویندوز، مک و لینوکس.
ویسپر
OpenAI Whisper
مدل متنباز تشخیص گفتار OpenAI؛ استاندارد عملی پیادهسازی صوت به متن که فارسی را هم خوب میفهمد و رایگان روی سیستم خودتان اجرا میشود.
توربوسکرایب
TurboScribe
تبدیل گفتار به متن و زیرنویس با Timestamp دقیق (SRT/VTT)؛ ستون فقرات پایپلاین دوبله ارزان — استخراج متن ویدئو قبل از ترجمه و TTS.