موتور متنباز گفتار به متن آفلاین؛ در Subtitle Edit از مسیر Audio to text (Vosk) بدون آپلود به ابر زیرنویس میسازد.
معرفی: وسک
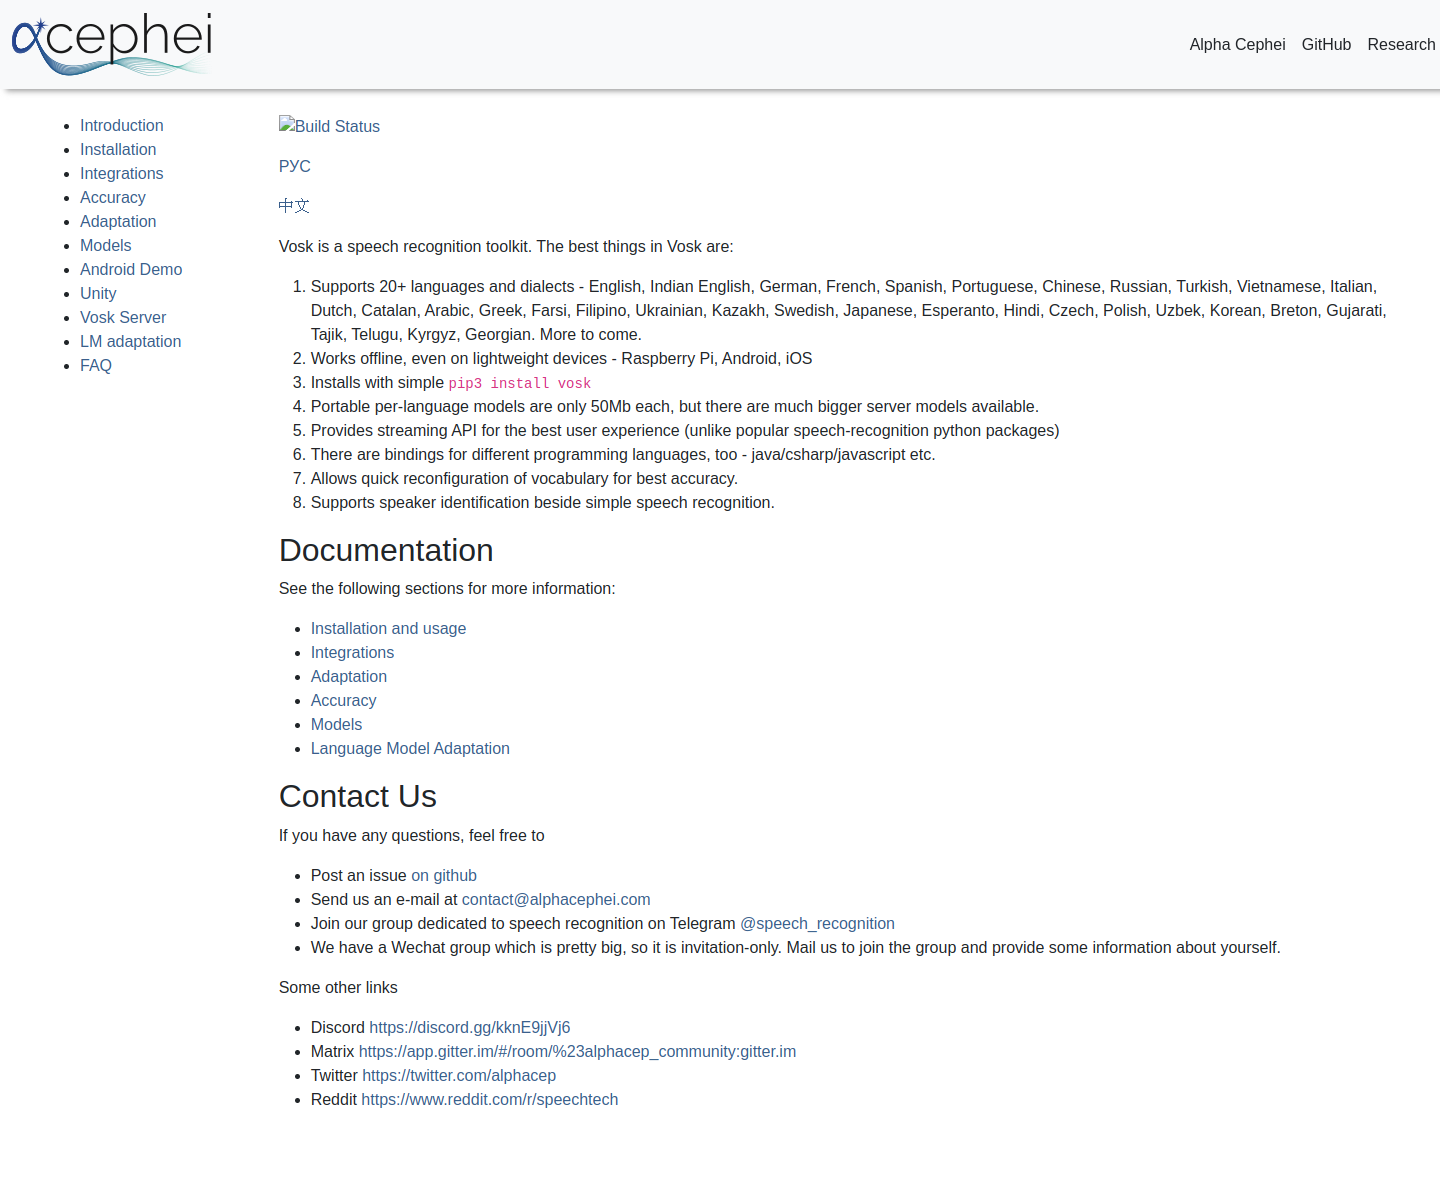
وسک (Alphacephei) کتابخانه و مدلهای سبک STT چندزبانه است که روی CPU معمولی هم اجرا میشود. کاربردیترین مسیر برای غیرفنیها: نصب Subtitle Edit و انتخاب Video → Audio to text (Vosk/Kaldi) تا مدل را دانلود و روی ویدئو رونویسی کند — مناسب حریم خصوصی، کلاس آفلاین و اینترنت ضعیف.
دقت معمولاً پایینتر از Whisper بزرگ یا Speechmatics ابری است؛ برای فارسی مدل جدا لازم است و لهجه/نویز را حتماً تست کنید. برنامهنویسها میتوانند مستقیماً از API/بایندینگهای Vosk هم استفاده کنند.
وضعیت پروژه: آخرین نسخهٔ رسمی کتابخانه 0.3.50 (آوریل ۲۰۲۴) است، ولی کد همچنان تغییرات کوچک میگیرد؛ تا اوت ۲۰۲۶ مثلاً بستهٔ Ruby و API گفتار اندروید (SpeechService) بهروز شدهاند.
بهترین کاربردها
- •ویدئو را آفلاین به زیرنویس تبدیل کن
- •بدون آپلود فایل صوتی را به متن تبدیل کن
- •زیرنویس فارسی ویدئو بساز
- •پادکست را روی کامپیوتر به متن تبدیل کن
- •برای برنامهام تبدیل گفتار به متن آفلاین اضافه کن
- •در اینترنت ضعیف صوت را به متن تبدیل کن
برای این کارها سراغش نروید
- –تبدیل گفتار به متن با بالاترین دقت
- –رونویسی آنلاین بدون نصب و راهاندازی
اجرا روی سیستم خودتان
این برنامه را روی سیستم خودتان نصب میکنید و هوش مصنوعی روی همان دستگاه اجرا میشود؛ متن و فایلهایتان از آن بیرون نمیرود.
- بعد از نصب، بدون اینترنت
- متنباز
- Apache-2.0 — استفادهٔ تجاری آزاد
- خط فرمان
- API
فقط دانلود مدل اینترنت میخواهد؛ vosk-transcriber مدل را خودکار از سایت سازنده (alphacephei.com) میگیرد. میتوانید فایل zip مدل را جای دیگری دانلود و از حالت فشرده خارج کنید؛ بعد از آن کاملاً آفلاین است.
کد و هر دو مدل فارسی (vosk-model-fa و vosk-model-small-fa) با Apache 2.0 منتشر شدهاند و استفادهٔ تجاری آزاد است.
سختافزار لازم
- حداقل رم: ۲ گیگابایت — پیشنهادی: ۱۶ گیگابایت
- کارت گرافیک لازم نیست
- مدل کوچک فارسی (۵۱ مگابایت) طبق سازنده حدود ۳۰۰ مگابایت رم میگیرد و روی لپتاپ معمولی، رزبریپای و گوشی اندروید کار میکند؛ ۲ گیگابایت با احتساب سیستمعامل تخمینی است. مدل بزرگ (۱٫۶ گیگابایت) دقیقتر است؛ سازنده میگوید مدلهای بزرگ تا ۱۶ گیگابایت رم لازم دارند. کارت گرافیک لازم نیست.
نصب و اجرا
- ۱
کتابخانه و ابزار خط فرمان را نصب کنید
pip install voskپایتون ۳ (۶۴ بیتی) لازم است؛ ابزار vosk-transcriber هم همراهش نصب میشود.
- ۲
ffmpeg را نصب کنیدلینوکس
sudo apt install ffmpegبرای تبدیل ویدئو و MP3 به صوت مناسب لازم است. در مک brew install ffmpeg و در ویندوز choco install ffmpeg.
- ۳
یک فایل فارسی را زیرنویس کنید
vosk-transcriber -n vosk-model-small-fa-0.42 -i input.mp4 -t srt -o output.srtبار اول مدل کوچک فارسی (۵۱ مگابایت) خودکار دانلود میشود.
- ۴
مدل بزرگ را دستی و آفلاین به کار ببرید
vosk-transcriber -m ./vosk-model-fa-0.42 -i input.wav -o output.txtفایل vosk-model-fa-0.42.zip (۱٫۶ گیگابایت) را از صفحهٔ مدلها بگیرید و در همان پوشه از حالت فشرده خارج کنید.
- ۵
سرور گفتار به متن برای شبکهٔ شرکتلینوکس
docker run -d -p 2700:2700 -v /opt/vosk-model-fa-0.42:/opt/vosk-model-en/model alphacep/kaldi-en:latestایمیج رسمی vosk-server را با مدل فارسی اجرا میکند (WebSocket روی پورت ۲۷۰۰). ایمیج روی Docker Hub است.
دانلود
- مدلهای Vosk (فارسی و زبانهای دیگر) ↗رسمی
vosk-model-small-fa-0.42 و vosk-model-fa-0.42؛ چکسام MD5 هر مدل در model-list.json آمده است
- vosk (PyPI) ↗رسمی
- کد منبع و کتابخانهٔ اندروید (GitHub) ↗رسمی
بایندینگ جاوا، سیشارپ و Node.js هم دارد
- vosk-server (GitHub) ↗رسمی
سرور WebSocket، gRPC، MQTT و WebRTC
نکات امنیتی
- چکسام MD5 هر مدل در فایل رسمی model-list.json آمده است (مثلاً مدل بزرگ فارسی: c47c8e497e35e5e3a27cb71c4f0af275)؛ فایلی را که از جای دیگر گرفتهاید با آن مقایسه کنید.
- مستندات vosk-server روشی برای احراز هویت معرفی نکرده است؛ پورت ۲۷۰۰ را فقط در شبکهٔ داخلی باز کنید و به اینترنت نگذارید.
برای شرکتها و سازمانها
برای سازمان مناسب است: vosk-server چند کاربر را همزمان با WebSocket یا gRPC سرویس میدهد و روی CPU اجرا میشود. مدلهای بزرگ رم زیادی میگیرند (تا ۱۶ گیگابایت).
آخرین بررسی: ۱۲ مهر ۱۴۰۵
تصاویر محیط ابزار
نقاط قوت
- ✓اجرای کاملاً آفلاین و خصوصی
- ✓متنباز و رایگان
- ✓مناسب آموزش مفاهیم STT روی دستگاه
نقاط ضعف
- ✗دقت کمتر از سرویسهای ابری بزرگ
- ✗راهاندازی برای غیرفنی سخت است
- ✗مدل فارسی سبکتر از بهترین مدلهای روز
نظرات کاربران (۴)
بینقص نیست ولی میارزه
اوکیه دیگه
سایت خوبه برای کشف ابزار : نسبت به قیمتش اوکیه
نمیخوام تعریف الکی کنم. تو کار روزمره کمکم کرد فقط گاهی کند میشه
ابزارهای مشابه
مشاهده همه
ویسپر
OpenAI Whisper
مدل متنباز تشخیص گفتار OpenAI؛ استاندارد عملی پیادهسازی صوت به متن که فارسی را هم خوب میفهمد و رایگان روی سیستم خودتان اجرا میشود.
نوا
Nova Sharif
پلتفرم ایرانی تبدیل صوت به متن (نوا هوشمند شریف): گفتار فارسی به متن، متن به گفتار، تشخیص گوینده و API سازمانی.
اسپیچماتیکس
Speechmatics
موتور حرفهای تبدیل گفتار به متن (STT) با پشتیبانی فارسی، حالت realtime/batch و API — مناسب زیرنویس، جلسه و محصول سازمانی.