هیگز تیتیاس ۳ (آفلاین)
Higgs TTS 3 (offline)مدل ۴ میلیاردی Boson AI برای گفتار طبیعی و احساسی در بیش از ۱۰۰ زبان، با فارسی در ردهٔ کیفیت بالا؛ اما مجوزش غیرتجاری است.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- کد در دسترس
- Boson Higgs TTS 3 Research and Non-Commercial License — استفادهٔ تجاری با شرط
- فارسی: خوب
بعد از دانلود مدل و نصب SGLang-Omni یا vLLM-Omni، سرور بدون اینترنت کار میکند؛ مسیر محلی پوشهٔ مدل را به --model-path بدهید.
فقط استفادهٔ پژوهشی و غیرتجاری آزاد است. استثنا: «Creator Use Grant» (اضافهشده ۹ ژوئیهٔ ۲۰۲۶) اجازه میدهد تولیدکنندگان محتوا پادکست، ویدیو، کتاب صوتی و پست حتی درآمدزا بسازند، به شرط ذکر واضح نام Boson AI's Higgs Audio در صدا یا توضیحات. میزبانی بهعنوان API یا سرویس، بازفروش، فاینتیون برای فروش و گذاشتن در محصول، مجوز تجاری جدا میخواهد. شبیهسازی صدا بدون رضایت و جعل هویت ممنوع است.
نسخهها و سختافزار لازم
- Higgs TTS 3 (4B)۴٫۷Bطول متن ۸ هزار توکن
- حافظهٔ لازم:
- کارت گرافیک ۱۲ گیگ یا رم ۱۴ گیگ
ستون اصلی حدود ۴ میلیارد پارامتری (با بخشهای صوتی حدود ۴٫۷ میلیارد)، خروجی ۲۴ کیلوهرتز و طول زمینهٔ ۸۱۹۲ توکن. فایل bf16 حدود ۹٫۳ گیگابایت. رم و حافظهٔ گرافیک تخمینیاند.
نصب و اجرا
- ۱
SGLang-Omni را نصب کنیدلینوکس
git clone https://github.com/sgl-project/sglang-omni.git cd sglang-omni uv venv .venv -p 3.12 && source .venv/bin/activate uv pip install -v -e .پیش از هر کاری مجوز را بخوانید. سازنده اجرای داخل ایمیج داکر lmsysorg/sglang-omni را هم پیشنهاد کرده که روی Docker Hub است.
- ۲
مدل را دانلود کنیدلینوکس
hf download bosonai/higgs-tts-3-4bحدود ۹٫۳ گیگابایت. مخزن دروازه ندارد ولی با دانلود، مجوز را پذیرفتهاید.
- ۳
سرور را اجرا کنیدلینوکس
sgl-omni serve --model-path bosonai/higgs-tts-3-4b --port 8000مسیر جایگزین رسمی: vLLM-Omni با دستور vllm-omni serve bosonai/higgs-tts-3-4b --trust-remote-code --omni.
- ۴
یک جمله بسازیدلینوکس
curl -X POST http://localhost:8000/v1/audio/speech -H "Content-Type: application/json" -d '{"input": "<|emotion:contentment|>سلام، حال شما چطور است؟"}' --output out.wavبرچسبهای احساس، سبک و مکث را داخل متن بنویسید؛ برای شبیهسازی صدا، فایل مرجع و متن آن را در فیلد references بدهید.
دانلود
- bosonai/higgs-tts-3-4b (Hugging Face) ↗رسمی
وزنها، متن مجوز و راهنمای برچسبها.
- sgl-project/sglang-omni (GitHub) ↗رسمی
سرور پیشنهادی سازنده.
- vllm-project/vllm-omni (GitHub) ↗رسمی
مسیر جایگزین با دستورالعمل رسمی Higgs-Audio-V3-TTS.
- boson-ai/higgs-audio (GitHub) ↗رسمی
مخزن نسخههای قبلی؛ برای v3 به کارت مدل ارجاع میدهد.
- TTS-Audio-Suite (نود ComfyUI، GitHub) ↗غیررسمی
نود جامعه برای ComfyUI که Higgs TTS 3 را هم اجرا میکند؛ ساختهٔ Boson AI نیست.
- audio.cpp GGUF (Hugging Face) ↗غیررسمی
فایلهای GGUF در دقت BF16 و Q8 برای موتور audio.cpp؛ ساختهٔ Boson AI نیست.
نکات امنیتی
- اجرای vLLM-Omni با --trust-remote-code کد همراه مدل را اجرا میکند؛ فقط از مخزن رسمی bosonai استفاده کنید.
- سرور را روی اینترنت باز نکنید؛ طبق مجوز، ارائهٔ مدل به دیگران بهعنوان سرویس هم بدون مجوز تجاری ممنوع است.
- شبیهسازی صدا بدون رضایت، جعل هویت و فریب طبق مجوز ممنوع است و در بسیاری از کشورها جرم است.
برای شرکتها و سازمانها
گذاشتن مدل در محصول یا سرویس، مجوز تجاری جدا از Boson AI میخواهد.
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۵ خرداد ۱۴۰۵
معرفی: هیگز تیتیاس ۳ (آفلاین)
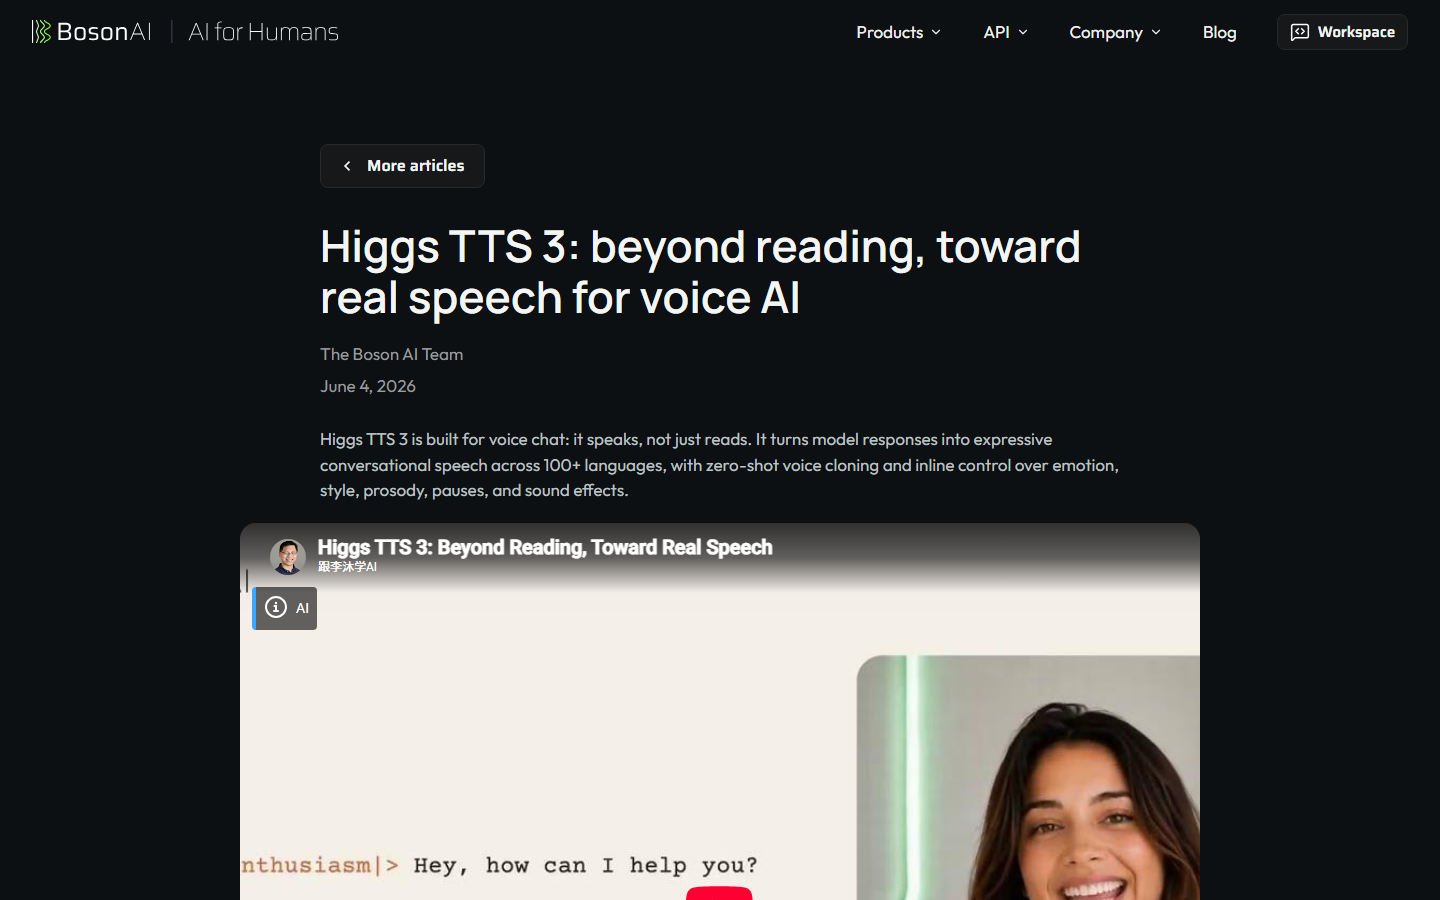
Higgs TTS 3 (نام قبلی: Higgs Audio v3) مدل تبدیل متن به گفتار شرکت Boson AI است که ۴ ژوئن ۲۰۲۶ منتشر شد. به جای «خواندن» متن، سعی میکند مثل آدم حرف بزند: با برچسبهای داخل متن ۲۱ حالت احساسی، سبکهایی مثل آواز و نجوا، افکتهایی مثل خنده و سرفه و سرعت و مکث را کنترل میکنید و صدا را از روی یک نمونه شبیهسازی میکند.
فارسی در کارت مدل جزو ۸۵ زبانی آمده که خطای WER/CER کمتر از ۵ دارند (ردهٔ آماده برای تولید). این از معدود مدلهای باز با ادعای رسمی کیفیت خوب در فارسی است.
هشدار مجوز: مجوز Boson Higgs TTS 3 فقط استفادهٔ پژوهشی و غیرتجاری را آزاد میکند، بهعلاوهٔ یک استثنا برای تولیدکنندگان محتوا (پادکست و ویدیو، حتی درآمدزا) به شرط ذکر نام Boson AI.
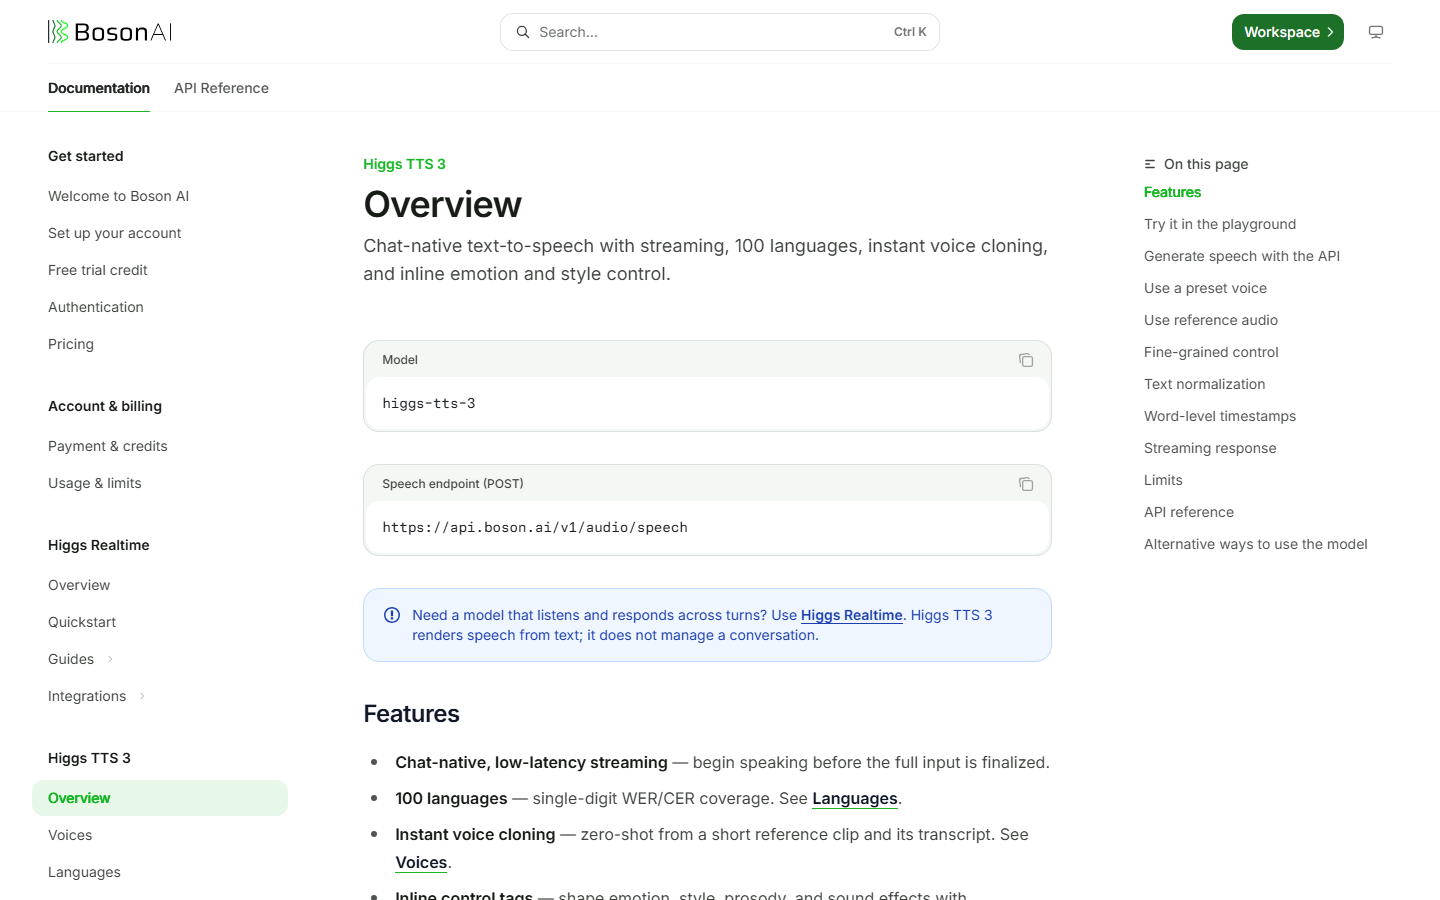
سختافزار: فایل bf16 حدود ۹٫۳ گیگابایت است و کارت انویدیا حدود ۱۲ گیگابایتی (تخمینی) و لینوکس لازم است. راه رسمی اجرا SGLang-Omni یا vLLM-Omni است که API سازگار با OpenAI میدهند؛ سازنده فقط نتایج H100 را منتشر کرده و عدد رسمی برای حافظهٔ گرافیک نداده است، پس ۱۲ گیگابایت برآورد است. دو راه از جامعه هم آمده که ساختهٔ Boson AI نیستند: نود TTS-Audio-Suite برای ComfyUI (نسخهٔ 5.6.0، ۲۵ ژوئیهٔ ۲۰۲۶) و موتور audio.cpp با فایلهای GGUF در دقت BF16 و Q8.
جمعبندی: از نظر فنی گزینهٔ خوبی برای گفتار فارسی است، اما مجوزش غیرتجاری است. Piper جایگزین آزاد و آفلاین فارسی است، هرچند کیفیتش پایینتر است.
بهترین کاربردها
- •متن فارسی را با صدای طبیعی و احساسی آفلاین بخوانم
- •صدای گوینده را برای پادکست فارسی شبیهسازی کنم
- •برای دستیار صوتی گفتار فارسی با مکث و احساس بسازم
- •روی سرور خودم کتاب صوتی چندزبانه بسازم
- •در گفتار ساختگی خنده، آه و نجوا اضافه کنم
- •روی سرور گویندهٔ هوش مصنوعی با API سازگار با OpenAI راه بیندازم
برای این کارها سراغش نروید
- –ارائهٔ سرویس یا API به دیگران بدون مجوز تجاری
- –کامپیوتر بدون کارت گرافیک قوی
- –تبدیل گفتار به متن
تصاویر محیط ابزار
نقاط قوت
- ✓فارسی در ردهٔ کیفیت بالای کارت مدل (خطای WER/CER کمتر از ۵)
- ✓کنترل ۲۱ احساس، سبک، افکت و مکث با برچسب داخل متن
- ✓شبیهسازی صدا از روی نمونهٔ کوتاه در بیش از ۱۰۰ زبان
- ✓API سازگار با OpenAI و پخش زنده با SGLang-Omni
- ✓در جدول سازنده روی هر چهار آزمون چندزبانه کمترین خطا را داشته است
نقاط ضعف
- ✗کارت گرافیک انویدیا حدود ۱۲ گیگابایتی (تخمینی) و لینوکس با SGLang-Omni یا vLLM-Omni لازم است؛ نصب برای کاربر معمولی سخت است
- ✗فقط پژوهشی و غیرتجاری؛ جز تولید محتوای سازندگان با ذکر نام، کار تجاری مجوز جدا میخواهد
- ✗میزبانی بهعنوان سرویس یا گذاشتن در محصول بدون مجوز تجاری ممنوع است
پرسشهای پرتکرار
فارسی را خوب میخواند؟
طبق کارت مدل، فارسی جزو ۸۵ زبانی است که خطای WER/CER کمتر از ۵ دارند. ما خودمان کیفیت را آزمایش نکردهایم.
برای یوتیوب و پادکست میشود استفاده کرد؟
مجوز از ۹ ژوئیهٔ ۲۰۲۶ یک «Creator Use Grant» دارد: تولیدکنندگان محتوا میتوانند پادکست، ویدیو و پست درآمدزا بسازند، به شرط اینکه در خود صدا یا در توضیحات، نام Boson AI's Higgs Audio را واضح بیاورند.
چه سختافزاری لازم است؟
فایل مدل حدود ۹٫۳ گیگابایت است؛ کارت انویدیا با حدود ۱۲ گیگابایت حافظه (تخمینی) و لینوکس لازم است. سازنده فقط نتایج H100 را منتشر کرده است.
جایگزین مجاز فارسی چیست؟
Piper با پنج صدای فارسی روی CPU کار میکند و بیشتر صداهایش دادههای CC0 دارند، هرچند طبیعیبودن Higgs را ندارد.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
کپشنز
Captions
استودیوی AI برای ویدیوهای گفتاری شبکههای اجتماعی؛ زیرنویس متحرک خودکار، ادیت هوشمند، دوبله ۳۰+ زبانه و آواتار دیجیتال در یک اپ.

مینیمکس صدا
MiniMax Audio
بخش صدا و موسیقی MiniMax (minimax.io/audio): تبدیل متن به گفتار طبیعی با Speech 2.8 در ۴۰ زبان از جمله فارسی، طراحی صدا از روی توصیف، کلون از نمونهٔ کوتاه، جداسازی صدا و ساخت آهنگ کامل با Music 3.0.
ویساستودیو
VoiceStudio
استودیوی صدای رایگان، متنباز و کاملاً آفلاین (نام قبلی OmniVoice Studio): کلون صدا از چند ثانیه نمونه، ساخت صدای جدید با توصیف، دوبلهٔ ویدئو و تبدیل گفتار به متن در ۶۴۶ زبان — از جمله فارسی — روی کامپیوتر خودتان.