ویساستودیو
VoiceStudioاستودیوی صدای رایگان، متنباز و کاملاً آفلاین (نام قبلی OmniVoice Studio): کلون صدا از چند ثانیه نمونه، ساخت صدای جدید با توصیف، دوبلهٔ ویدئو و تبدیل گفتار به متن در ۶۴۶ زبان — از جمله فارسی — روی کامپیوتر خودتان.
معرفی: ویساستودیو
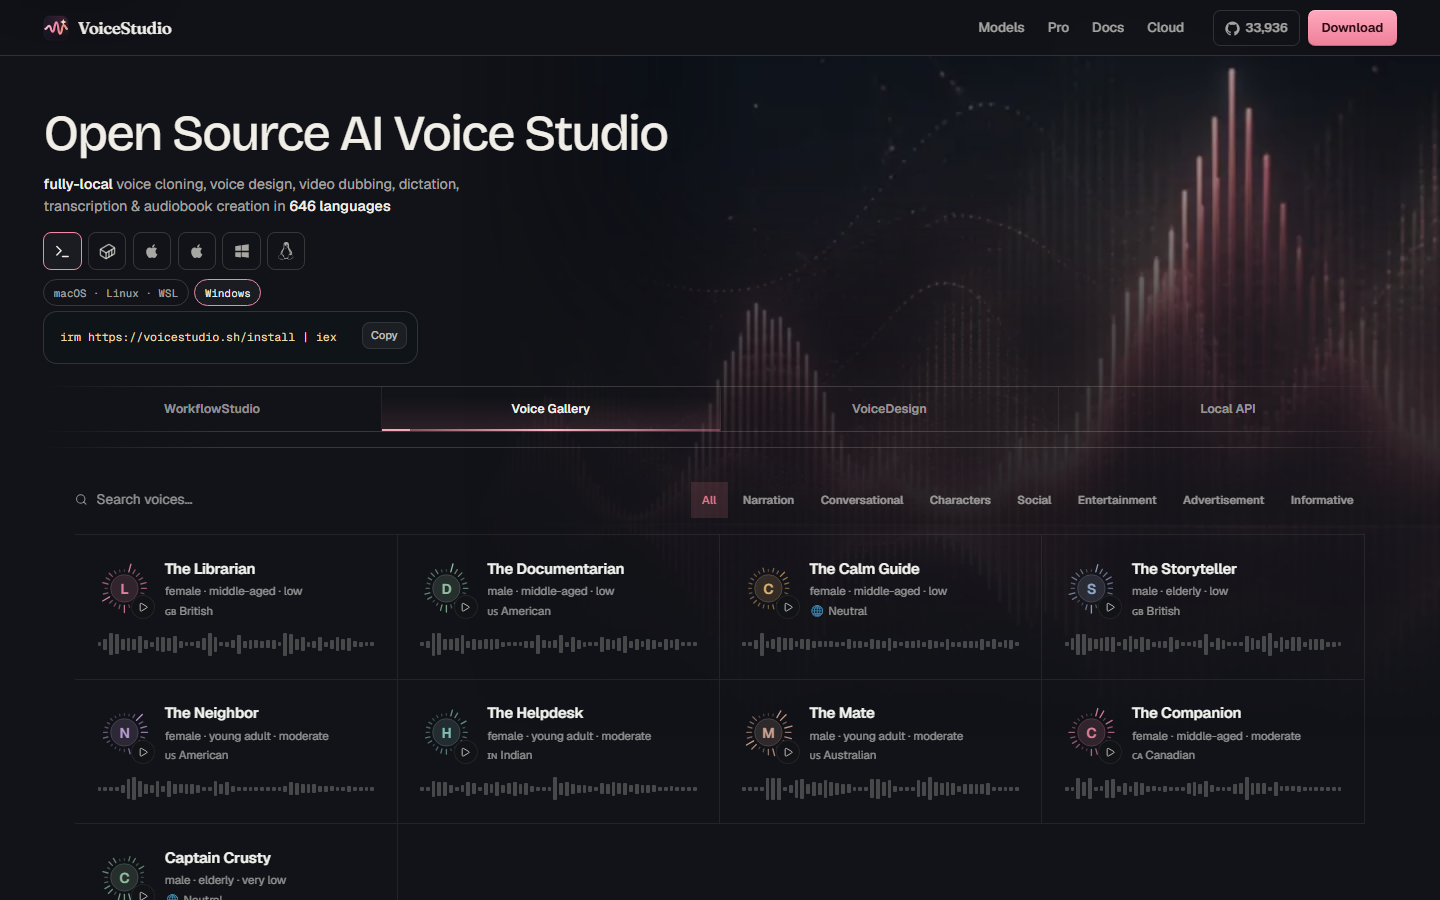
ویساستودیو (voicestudio.sh) که تا اوت ۲۰۲۶ با نام OmniVoice Studio شناخته میشد، اپ دسکتاپ رایگان و متنباز ویندوز، مک و لینوکس است که همهٔ کارهای صوتی را روی سختافزار خودتان انجام میدهد؛ بدون کلید API، بدون حساب کاربری و بدون آپلود فایل. موتور پیشفرضش مدل OmniVoice از تیم k2-fsa (شیائومی) است و در یک برنامه اینها را دارد: کلون صدا با حدود ۳ ثانیه نمونه، ساخت صدای تازه با تعیین جنسیت، سن، لهجه، زیر و بمی و احساس، دوبلهٔ ویدئو (پیادهسازی متن ← ترجمه با NLLB/Argos آفلاین یا Google/DeepL ← گویندگی با حفظ گویندهها و زمانبندی، حتی چسباندن زیرنویس روی تصویر)، کتاب صوتی فصلبندیشده از EPUB، داستان چندصدایی، جداسازی صدای گوینده از موسیقی، تشخیص گوینده، ویجت تایپ صوتی و API محلی سازگار با OpenAI بهعلاوهٔ MCP برای ایجنتها. فارسی در فهرست زبانهای OmniVoice هست (۳۶۶ ساعت دادهٔ آموزشی) و در ارزیابی مقالهٔ سازندگان روی FLEURS، نرخ خطای حروف گفتار فارسی تولیدشده ۱٫۹۰٪ بوده، نزدیک به ۱٫۵۷٪ صدای واقعی؛ یعنی خروجی فارسی قابلفهم است، ولی طبیعیبودن لحن را با یک نمونهٔ مرجع فارسی تمیز خودتان بسنجید.
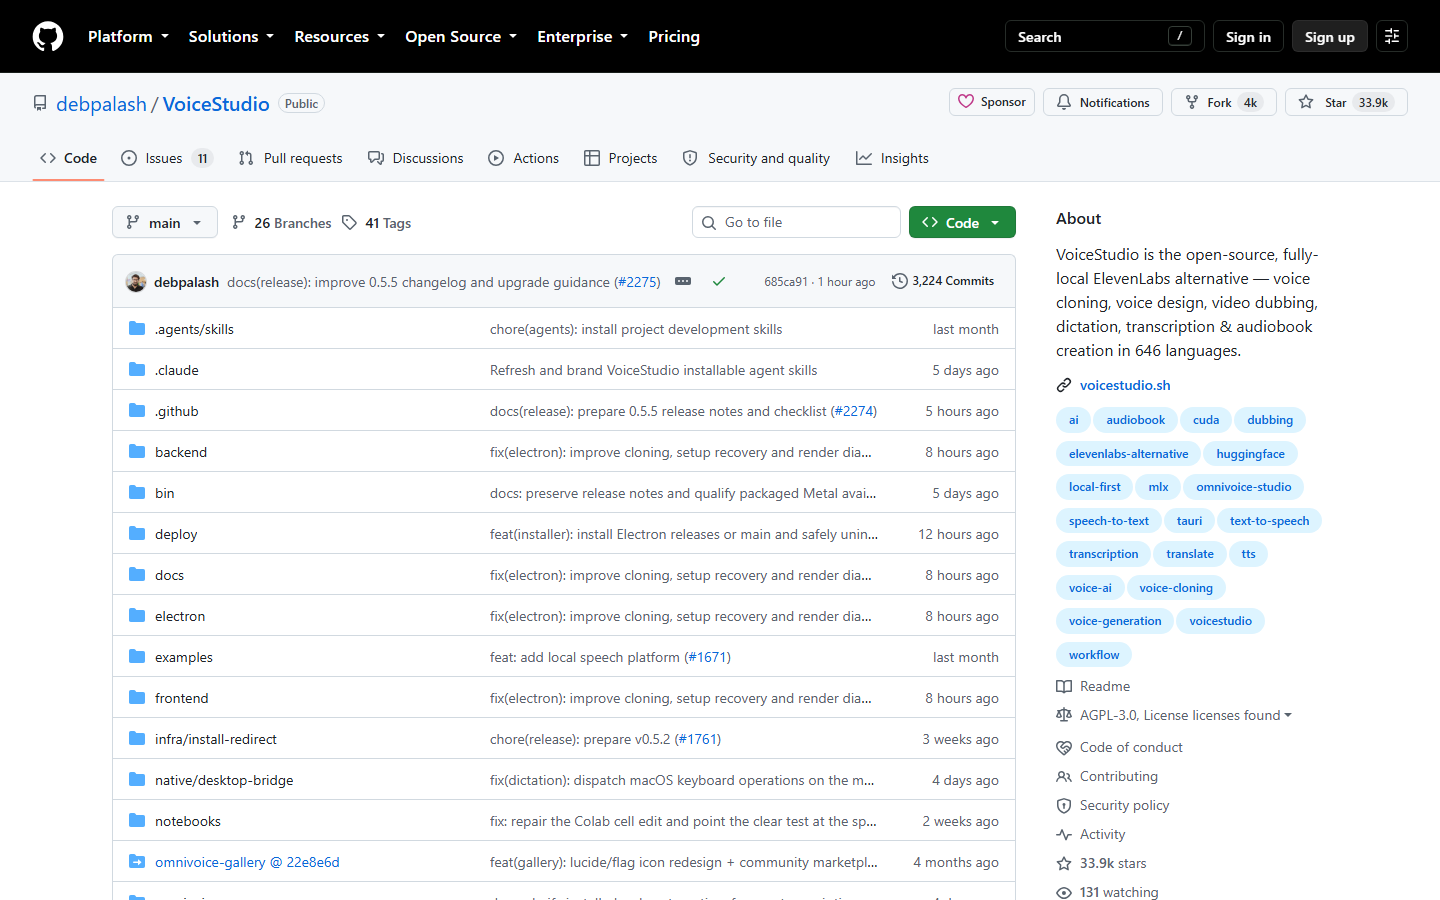
نصب با فایل آماده از صفحهٔ Releases گیتهاب انجام میشود (نسخهٔ 0.5.4، ۲۱ سپتامبر ۲۰۲۶) و مدلها در اولین اجرا از Hugging Face دانلود میشوند؛ حدود ۱۰ گیگ فضای خالی و حداقل ۸ گیگ رم لازم است. کارت گرافیک اختیاری است، ولی برای موتور پیشفرض دستکم ۶ گیگ VRAM توصیه شده، روی ویندوز فقط کارت انویدیا شتاب میدهد و مکهای اینتلی پشتیبانی نمیشوند؛ روی سیستم ضعیف یا بدون GPU نسخهٔ GGUF همان مدل کار میکند اما کندتر است. خود برنامه با مجوز AGPL-3.0 حتی برای کار تجاری آزاد است، اما وزنهای مدل پیشفرض OmniVoice مجوز غیرتجاری CC-BY-NC دارند؛ برای تبلیغ یا سفارش پولی، موتوری با مجوز تجاری انتخاب کنید. کلون صدای دیگران فقط با اجازهٔ خودشان مجاز است.
بهترین کاربردها
- •صدای خودم رو رایگان و روی کامپیوتر خودم با هوش مصنوعی کلون کنم
- •ویدئوی انگلیسی رو با صدای خود گوینده به فارسی دوبله کنم
- •متن فارسی رو با صدای طبیعی بخونه بدون اینکه فایلم جایی آپلود بشه
- •از روی توضیح سن و جنسیت و لهجه یه صدای جدید بسازم
- •کتاب EPUB رو به کتاب صوتی فصلبندیشده تبدیل کنم
- •داستان صوتی با چند گوینده و چند صدای مختلف بسازم
- •فایل صوتی یا ویدئو رو آفلاین به متن تبدیل کنم
- •صدای گوینده رو از موسیقی و صدای پسزمینه جدا کنم
برای این کارها سراغش نروید
- –استفادهٔ تجاری از صدای ساختهشده با مدل پیشفرض
- –تبدیل متن به صدا روی گوشی موبایل
- –سرویس آنلاین بدون نصب برنامه
- –ساخت آهنگ و موسیقی با هوش مصنوعی
اجرا روی سیستم خودتان
این برنامه را روی سیستم خودتان نصب میکنید و هوش مصنوعی روی همان دستگاه اجرا میشود؛ متن و فایلهایتان از آن بیرون نمیرود.
- بعد از نصب، بدون اینترنت
- متنباز
- AGPL-3.0 — استفادهٔ تجاری با شرط
- برنامهٔ گرافیکی
- رابط وب
- API
بار اول برنامه محیط پایتون را میسازد و وزن مدلها را دانلود میکند (طبق صفحهٔ دانلود حدود ۱۰ گیگابایت با مدلها؛ نسخهٔ داکر حدود ۲٫۴ گیگابایت وزن)؛ بعد از آن بدون اینترنت کار میکند. در دوبله، ترجمه با Argos یا NLLB-200 آفلاین است ولی Google، DeepL و Microsoft اینترنت میخواهند.
خود برنامه حتی برای کار تجاری آزاد است؛ فقط اگر نسخهٔ تغییریافته را توزیع کنید یا روی شبکه به دیگران ارائه دهید، باید کدش را در اختیارشان بگذارید. اما وزنهای موتور پیشفرض OmniVoice مجوز غیرتجاری CC-BY-NC دارند؛ برای کار پولی موتوری با مجوز تجاری انتخاب کنید.
سختافزار لازم
- حداقل رم: ۸ گیگابایت — پیشنهادی: ۱۶ گیگابایت
- کارت گرافیک اختیاری است — حداقل حافظهٔ کارت گرافیک: ۴ گیگابایت
- طبق صفحهٔ دانلود رسمی: حدود ۸ گیگابایت رم (۱۶ یا بیشتر پیشنهادی) و ۱۰ گیگابایت فضا؛ کارت گرافیک اختیاری است و با ۴ گیگابایت VRAM و انتقال بخشی از کار به رم هم اجرا میشود. ویندوز ۱۰ (21H2) یا ۱۱ ۶۴ بیتی؛ در ویندوز فقط کارت انویدیا شتاب میدهد و AMD روی CPU اجرا میشود. مک اپل سیلیکون شتاب MPS/MLX دارد و مک اینتلی فقط با CPU کار میکند.
نصب و اجرا
- ۱
ویندوز: نصبکنندهٔ آمادهویندوز
فایل VoiceStudio-Electron-0.5.6-win-x64.exe را از صفحهٔ Releases گیتهاب بگیرید. نصبکننده امضای دیجیتال ندارد و ویندوز ممکن است هشدار بدهد.
- ۲
مک یا لینوکس: نصب با یک دستورلینوکس
curl -fsSL https://voicestudio.sh/install | shروی مک هم همین دستور کار میکند؛ یا DMG (اپل سیلیکون یا اینتل) و AppImage یا deb لینوکس را از Releases بگیرید.
- ۳
مدل را نصب و صدا را کلون کنید
بخش Voice cloning را باز کنید، یک نمونهٔ صدای تمیز چندثانیهای بدهید و مدلی را که برنامه میخواهد نصب کنید؛ بار اول چند گیگابایت دانلود میشود.
- ۴
(اختیاری) اجرا روی سرور با داکرلینوکس
docker run -d --name omnivoice -p 127.0.0.1:3900:3900 -e OMNIVOICE_API_KEY="$OMNIVOICE_API_KEY" -v omnivoice-data:/app/omnivoice_data -v ~/.cache/huggingface:/root/.cache/huggingface ghcr.io/debpalash/omnivoice-studio:stableاول یک کلید تصادفی طولانی در متغیر OMNIVOICE_API_KEY بگذارید؛ برای کارت انویدیا --gpus all اضافه کنید. رابط وب روی http://localhost:3900 باز میشود.
دانلود
- VoiceStudio (GitHub Releases) ↗رسمی
ویندوز x64، مک اپل سیلیکون و اینتل، لینوکس AppImage و deb؛ فایل SHA256SUMS.txt هم هست
- صفحهٔ دانلود رسمی ↗رسمی
- ایمیج داکر (GHCR) ↗رسمی
کپی آن روی Docker Hub با نام palashdeb/omnivoice-studio است
نکات امنیتی
- نصبکنندهها امضای دیجیتال معتبر ندارند و نسخهٔ مک notarize نشده است؛ فقط از Releases گیتهاب بگیرید و هش فایل را با SHA256SUMS.txt مقایسه کنید.
- در داکر پورت ۳۹۰۰ را روی 127.0.0.1 نگه دارید و کلید OMNIVOICE_API_KEY طولانی بگذارید؛ طبق راهنمای رسمی، آن را بدون رمزنگاری مستقیم به اینترنت وصل نکنید.
- کلون صدای دیگران فقط با اجازهٔ خودشان مجاز است.
برای شرکتها و سازمانها
نسخهٔ داکر با کلید API و API سازگار با OpenAI برای سرور تیم مناسب است؛ طبق AGPL اگر نسخهٔ تغییریافته را به کاربران شبکه ارائه کنید باید کدش را در اختیارشان بگذارید.
مدلهایی که با این برنامه اجرا میشوند
 اومنیویس (آفلاین)
آخرین بررسی: ۱۲ مهر ۱۴۰۵
تصاویر محیط ابزار
نقاط قوت
- ✓کاملاً آفلاین و رایگان؛ فایل و صدای شما از کامپیوترتان خارج نمیشود
- ✓فارسی در موتور پیشفرض با خروجی قابلفهم
- ✓دوبلهٔ ویدئو، کتاب صوتی، طراحی صدا و تایپ صوتی در یک برنامه
- ✓بهروزرسانی مداوم و API محلی و MCP برای اتوماسیون
نقاط ضعف
- ✗وزنهای مدل پیشفرض برای استفادهٔ تجاری آزاد نیست (CC-BY-NC)
- ✗دانلود چندگیگی مدلها و سختافزار نسبتاً قوی لازم است
- ✗روی ویندوز فقط کارت انویدیا شتاب میدهد و مک اینتلی پشتیبانی نمیشود
پرسشهای پرتکرار
صدای فارسی هم میسازد؟
بله؛ موتور پیشفرض OmniVoice فارسی را پشتیبانی میکند و در ارزیابی سازندگان خروجی فارسی قابلفهم بوده. برای لحن طبیعیتر، یک نمونهٔ مرجع فارسی تمیز چندثانیهای بدهید.
برای کار تجاری میشود از آن استفاده کرد؟
خود برنامه بله (AGPL-3.0)، ولی وزنهای مدل پیشفرض OmniVoice غیرتجاریاند. برای کار پولی موتوری با مجوز تجاری انتخاب کنید و مجوز هر مدل را قبلش بخوانید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
کپشنز
Captions
استودیوی AI برای ویدیوهای گفتاری شبکههای اجتماعی؛ زیرنویس متحرک خودکار، ادیت هوشمند، دوبله ۳۰+ زبانه و آواتار دیجیتال در یک اپ.
ویسپر
OpenAI Whisper
مدل متنباز تشخیص گفتار OpenAI؛ استاندارد عملی پیادهسازی صوت به متن که فارسی را هم خوب میفهمد و رایگان روی سیستم خودتان اجرا میشود.
الونلبز
ElevenLabs
بهترین کیفیت متنبهگفتار و دوبله بازار — عالی ولی گران؛ برای کار حجیم مسیر Google AI Studio / OpenAI.fm + Descript ارزانتر است.