Jan
Janمحصول منلو ریسرچ
برنامهٔ متنباز و رایگان (Apache-2.0) برای ویندوز، مک و لینوکس که مثل ChatGPT کار میکند ولی مدلها را روی کامپیوتر خودتان اجرا میکند؛ با Hub مدل، گفتوگو با فایل، ابزارهای MCP و سرور API محلی.
معرفی: Jan
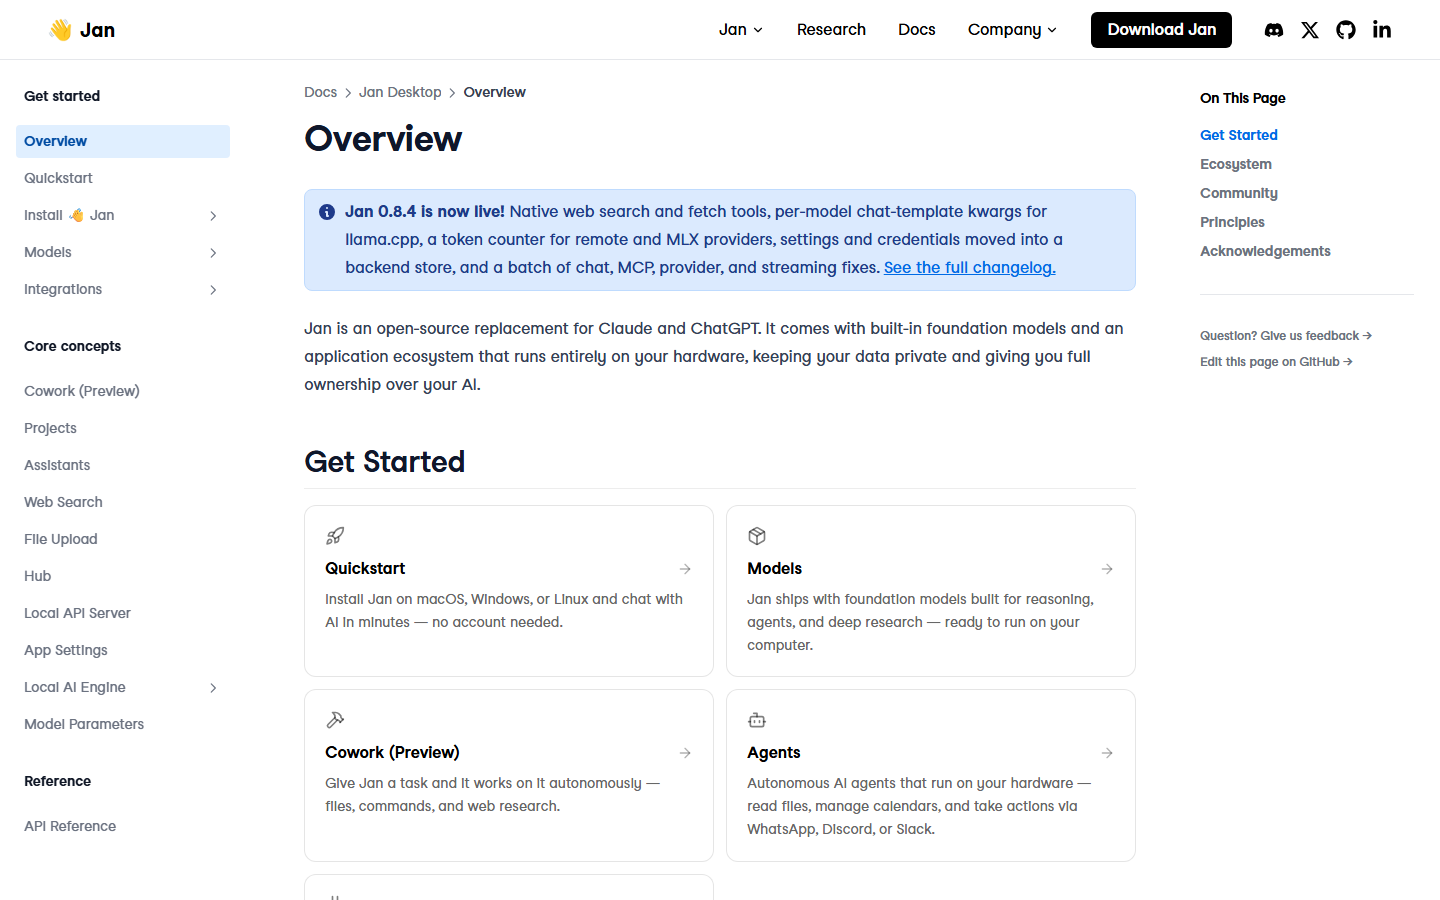
Jan برنامهٔ دسکتاپ متنباز (مجوز Apache-2.0) شرکت Menlo Research است که خودش را جایگزین متنباز ChatGPT و Claude معرفی میکند. مدلها با موتور llama.cpp (و روی مک با MLX) روی سیستم خودتان اجرا میشوند. بخش Hub مدلهای GGUF را از Hugging Face میآورد و برای هر نسخه نشان میدهد روی سختافزار شما جا میشود، کند است یا جا نمیشود.
برای کسی است که یک برنامهٔ چت مرتب و خصوصی میخواهد: پروژه، دستیار سفارشی، آپلود فایل، ابزارهای MCP، جستجوی وب داخلی و حالت آزمایشی Cowork برای کارهای چندمرحلهای دارد. میشود کلید API سرویسهایی مثل OpenAI، Anthropic، Gemini یا OpenRouter را هم اضافه کرد، ولی حالت پیشفرض محلی و بدون حساب کاربری است. یک سرور API سازگار با OpenAI روی پورت ۱۳۳۷ و از مارس ۲۰۲۶ ابزار خط فرمان jan هم دارد.
سختافزار: ویندوز ۱۰ به بعد یا لینوکس با پردازندهٔ دارای AVX2، دستکم ۸ گیگ رم (۱۶ گیگ توصیهشده) و برای شتاب گرافیکی کارت با دستکم ۶ گیگ حافظه؛ روی مک فقط تراشههای اپل با macOS 13.6 به بعد. طبق راهنمای رسمی، مک ۸ گیگ مدلهای تا حدود ۳ میلیارد پارامتر و مک ۱۶ گیگ تا حدود ۷ میلیارد را راحت اجرا میکند.
شروع: نصبکننده را از jan.ai یا گیتهاب بگیرید؛ در اولین اجرا Jan مدل پیشفرض خودش را دانلود میکند. بعد میتوانید از Hub مدلی مثل Qwen3.5 را بگیرید یا فایل GGUF را از دیسک وارد کنید.
نکتهها: رابط فارسی ندارد، اما پاسخهای فارسی را راستبهچپ نمایش میدهد و در نسخهٔ 0.8.4 مشکل بلوکهای کد وسط متن فارسی هم حل شد. برای بعضی مدلها مثل Gemma 4 12B باگ باز گزارش شده است.
نسخهٔ 0.8.6 (۹ اکتبر ۲۰۲۶): موتور llama.cpp حالا داخل خود فایل نصب است و در اولین اجرا جدا دانلود نمیشود، پس راهاندازی روی سیستم بدون اینترنت سادهتر شده است. کندی Qwen3.8 با پیشبینی چندتوکنی (MTP) روی کارتهای ۱۲ گیگابایتی و مشکل کارتهای GTX سری ۱۶ و RTX سری ۲۰ با درایورهای قدیمی رفع شده است. اگر سرور API را روی 0.0.0.0 باز کنید، Jan حالا فقط به میزبانهای فهرست Trusted Hosts جواب میدهد. در عوض مکهای اینتل دیگر نمیتوانند مدل محلی اجرا کنند.
بهترین کاربردها
- •یه برنامهٔ چت شبیه ChatGPT داشته باشم که بدون اینترنت روی لپتاپم کار کنه
- •بدون ثبتنام و بدون فرستادن داده به بیرون با هوش مصنوعی فارسی حرف بزنم
- •فایلها و یادداشتهام رو به چتبات محلی بدم و ازشون سؤال کنم
- •مدل GGUF که دانلود کردم رو توی یه برنامهٔ ساده باز کنم
- •هم مدل محلی و هم کلید API سرویسهای ابری رو توی یه برنامه داشته باشم
- •ابزارهای MCP رو به یه دستیار محلی وصل کنم
- •برای برنامهام یه API محلی سازگار با OpenAI روی لپتاپ داشته باشم
برای این کارها سراغش نروید
- –ساخت تصویر یا ویدئو
- –سرور هوش مصنوعی چندکاربره برای کل شرکت
- –اجرای مدل روی گوشی موبایل
اجرا روی سیستم خودتان
این برنامه را روی سیستم خودتان نصب میکنید و هوش مصنوعی روی همان دستگاه اجرا میشود؛ متن و فایلهایتان از آن بیرون نمیرود.
- بعد از نصب، بدون اینترنت
- متنباز
- Apache-2.0 — استفادهٔ تجاری آزاد
- برنامهٔ گرافیکی
- خط فرمان
- API
بعد از دانلود مدل، چت و گفتوگو با فایل بدون اینترنت کار میکند. Jan در اولین اجرا مدل پیشفرضش را خودکار دانلود میکند؛ روی سیستم بدون اینترنت فایل GGUF را دستی وارد کنید. جستجوی وب داخلی، بهروزرسانی موتور llama.cpp و مدلهای ابری اینترنت میخواهند.
استفادهٔ تجاری، تغییر و بازنشر آزاد است؛ متن مجوز و اعلان کپیرایت Menlo Research را نگه دارید.
سختافزار لازم
- حداقل رم: ۸ گیگابایت — پیشنهادی: ۱۶ گیگابایت
- کارت گرافیک اختیاری است
- طبق مستندات: ویندوز ۱۰ به بعد و لینوکس با AVX2، ۸ گیگ رم حداقل و ۱۶ گیگ توصیهشده، ۱۰ گیگ فضای خالی؛ برای شتاب گرافیکی دستکم ۶ گیگ VRAM (انویدیا، AMD یا Intel Arc). مک: فقط اپلسیلیکون با macOS 13.6 به بعد؛ ۸ گیگ برای مدلهای تا 3B، ۱۶ گیگ تا 7B و ۳۲ گیگ تا 13B.
نصب و اجرا
- ۱
نصبکننده را بگیرید
https://github.com/janhq/jan/releases/latestویندوز: Jan_0.8.6_x64-setup.exe؛ مک: فایل dmg یونیورسال؛ لینوکس: deb، AppImage یا Flathub.
- ۲
در لینوکس بستهٔ deb را نصب کنیدلینوکس
sudo apt install ./Jan_0.8.6_amd64.debیا فایل AppImage را اجرایی کنید و اجرا کنید.
- ۳
مدل بگیرید یا فایل GGUF را وارد کنید
از Hub مدلی مثل Qwen3.5 را دانلود کنید؛ بدون اینترنت از Settings › Llama.cpp › Import فایل GGUF را اضافه کنید.
- ۴
مدل را بهصورت API ارائه کنید
jan serve unsloth/Qwen3.5-9B-GGUFمدل روی http://localhost:6767/v1 در دسترس میشود؛ سرور داخل خود برنامه روی پورت ۱۳۳۷ است.
دانلود
- Jan download page ↗رسمی
ویندوز، مک (یونیورسال) و لینوکس
- GitHub Releases (v0.8.6) ↗رسمی
همان فایلها؛ لینکهای سایت هم به همینجا میرود
- Flathub: ai.jan.Jan ↗رسمی
نسخهٔ Flatpak برای لینوکس
- Microsoft Store ↗رسمی
نسخهٔ فروشگاه ویندوز
نکات امنیتی
- سرور API بهطور پیشفرض روی 127.0.0.1 است؛ اگر آن را روی 0.0.0.0 میگذارید، حتماً API Key و Trusted Hosts را تنظیم کنید.
- سرورهای MCP میتوانند فایل بخوانند و دستور اجرا کنند؛ فقط موارد مطمئن را اضافه کنید و تأیید ابزارها را روشن نگه دارید.
- آمار استفاده فقط با اجازهٔ شما فرستاده میشود؛ در اولین اجرا یا از تنظیمات خاموشش کنید.
- از نسخهٔ 0.8.4 کلیدهای API در keyring سیستمعامل ذخیره میشوند؛ باز هم روی کامپیوتر مشترک کلید نگذارید.
برای شرکتها و سازمانها
Jan برای استفادهٔ یکنفره روی دسکتاپ ساخته شده و مدیریت کاربر ندارد. میشود سرور API آن را با کلید و Trusted Hosts در شبکهٔ داخلی برای چند نفر باز کرد، ولی برای سرور چندکاربرهٔ شرکت، Ollama یا vLLM همراه Open WebUI مناسبترند.
مدلهایی که با این برنامه اجرا میشوند
 جما ۴ (آفلاین)
 جیپیتی اواساس (آفلاین)
همسطح ابری
آخرین بررسی: ۱۷ مهر ۱۴۰۵
تصاویر محیط ابزار
نقاط قوت
- ✓کاملاً متنباز (Apache-2.0) و رایگان، بدون نیاز به حساب کاربری
- ✓رابط چت مرتب با پروژه، دستیار سفارشی، آپلود فایل و شاخهبندی پیامها
- ✓Hub مدل با برچسب «جا میشود، کند است، جا نمیشود» برای سختافزار شما
- ✓پاسخهای فارسی را راستبهچپ نمایش میدهد
- ✓سرور API سازگار با OpenAI، ابزار خط فرمان jan و پشتیبانی از MCP
- ✓مدل محلی و مدلهای ابری را در یک برنامه کنار هم دارد
نقاط ضعف
- ✗دستکم ۸ گیگ رم (۱۶ گیگ توصیهشده)، پردازندهٔ AVX2 و ۱۰ گیگ فضای خالی میخواهد و برای شتاب گرافیکی کارت ۶ گیگ؛ مک اینتل پشتیبانی نمیشود
- ✗رابط برنامه فارسی ندارد
- ✗برای بعضی مدلها باگ باز هست؛ مثلاً بارگذاری Gemma 4 12B با خطا گزارش شده
- ✗برای استفادهٔ یکنفره روی دسکتاپ طراحی شده، نه سرور چندکاربرهٔ شرکت
پرسشهای پرتکرار
Jan واقعاً بدون اینترنت کار میکند؟
بله؛ مدلهای محلی حالت پیشفرضاند و بعد از دانلود بدون اینترنت و بدون حساب کاربری کار میکنند. فقط دانلود مدل، جستجوی وب داخلی و مدلهای ابری (با کلید API) اینترنت میخواهند. آمار استفاده هم فقط با اجازهٔ شما در اولین اجرا فرستاده میشود.
چه سختافزاری لازم دارد؟
ویندوز ۱۰ به بعد یا لینوکس با پردازندهٔ AVX2، دستکم ۸ گیگ رم (۱۶ گیگ بهتر) و ۱۰ گیگ فضای خالی. برای شتاب گرافیکی کارت انویدیا، AMD یا Intel Arc با دستکم ۶ گیگ حافظه. روی مک فقط M1 به بعد با macOS 13.6 یا جدیدتر.
فارسی را پشتیبانی میکند؟
رابط برنامه فارسی ندارد، ولی پاسخهای فارسی راستبهچپ نمایش داده میشوند. کیفیت فارسی به مدل بستگی دارد؛ Qwen3.5 فارسی را رسماً پشتیبانی میکند.
برای کار تجاری و شرکت آزاد است؟
بله، مجوز Apache-2.0 استفادهٔ تجاری، تغییر و بازنشر را آزاد میگذارد. مجوز هر مدلی که اجرا میکنید را جدا بررسی کنید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه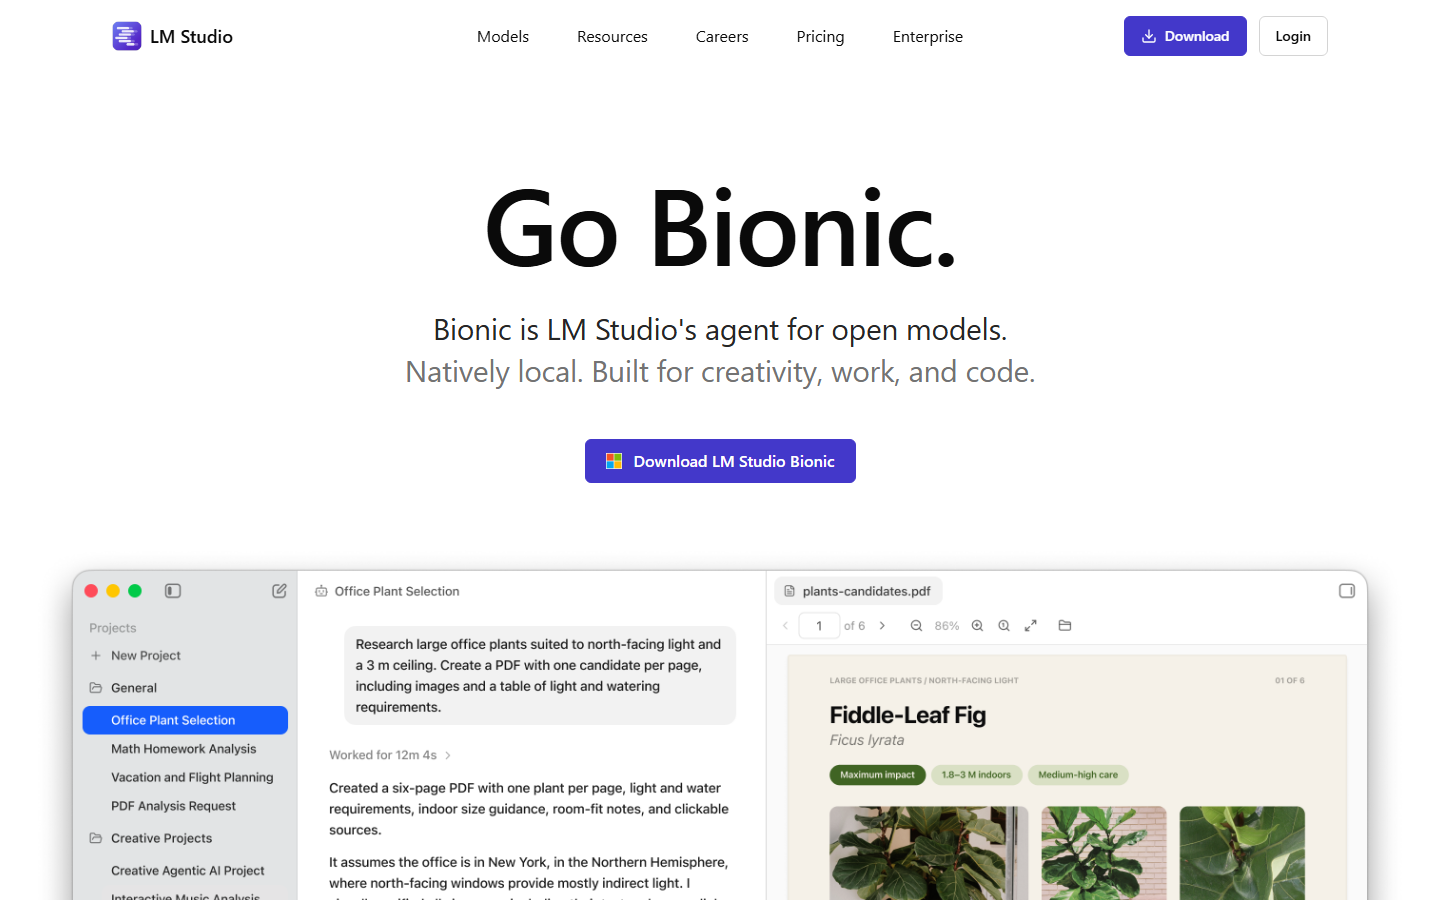
الام استودیو
LM Studio
برنامهٔ رایگان ویندوز، مک و لینوکس برای دانلود و اجرای مدلهای زبانی روی کامپیوتر خودتان: چت آفلاین، گفتوگو با اسناد، سرور API سازگار با OpenAI و ایجنت Bionic برای کار و کدنویسی.
اوپن وبیوآی
Open WebUI
رابطی شبیه ChatGPT که روی لپتاپ یا سرور خودتان نصب میشود و به Ollama یا هر API سازگار با OpenAI وصل میشود؛ با گفتوگو با اسناد، مدیریت کاربران، LDAP و ورود یکپارچه (SSO).
کوئن ۳.۵ (آفلاین)
Qwen3.5 (offline)
خانوادهٔ مدل باز علیبابا که فارسی در فهرست رسمی زبانهایش است؛ از 0.8B برای لپتاپ ضعیف تا 35B-A3B برای سیستم قوی، با فهم تصویر، حافظهٔ متنی ۲۶۲ هزار توکنی و مجوز Apache 2.0.