جیپیتی اواساس (آفلاین)
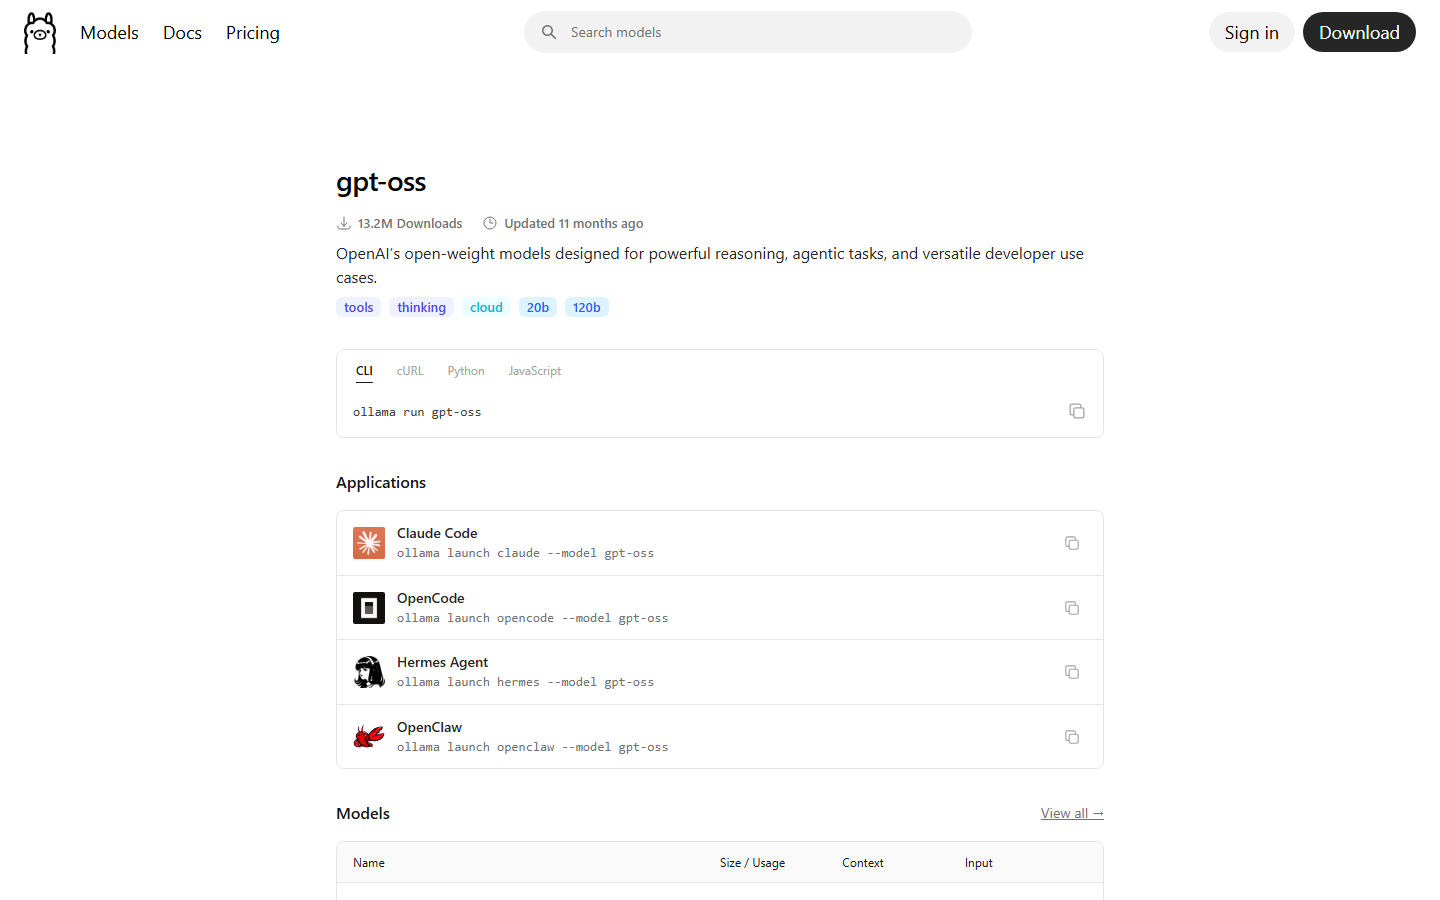
gpt-oss (offline)مدلهای وزنباز استدلالی OpenAI در دو اندازه: gpt-oss-20b برای کامپیوتری با ۱۶ گیگابایت حافظه و gpt-oss-120b برای سرور با کارت ۸۰ گیگابایتی؛ فقط متن، قوی در استدلال و کد، با مجوز Apache 2.0.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- Apache-2.0 — استفادهٔ تجاری آزاد
- فارسی: ضعیف
بعد از دانلود کاملاً آفلاین کار میکند. برچسبهای gpt-oss:20b-cloud و gpt-oss:120b-cloud و جستوجوی وب داخلی Ollama به اینترنت نیاز دارند و آفلاین نیستند.
استفادهٔ تجاری، تغییر و بازنشر آزاد است؛ اگر مدل را بازنشر میکنید، متن مجوز را همراهش بگذارید. سیاست استفادهٔ gpt-oss هم فقط رعایت قوانین را میخواهد.
نسخهها و سختافزار لازم
- 20b۲۱B (فعال ۳٫۶B)طول متن ۱۲۸ هزار توکن
- حجم دانلود:
- ۱۴ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۱۷ گیگ یا رم ۱۹ گیگ
ollama run gpt-oss:20bبرآورد. کوانتیزهٔ MXFP4 (حدود ۴٫۲۵ بیت برای وزنهای MoE) که OpenAI خودش منتشر کرده؛ Ollama نسخهٔ ۸ بیتی یا کامل محلی ندارد. OpenAI میگوید با ۱۶ گیگابایت حافظه اجرا میشود.
- 120b۱۱۷B (فعال ۵٫۱B)طول متن ۱۲۸ هزار توکن
- حجم دانلود:
- ۶۵ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۷۸ گیگ یا رم ۸۰ گیگ
ollama run gpt-oss:120bبرآورد. برای یک کارت گرافیک ۸۰ گیگابایتی (مثل H100 یا MI300X) یا سروری با رم زیاد.
نصب و اجرا
- ۱
Ollama را روی ویندوز نصب کنیدویندوز
irm https://ollama.com/install.ps1 | iexاین دستور را در PowerShell بزنید (ویندوز ۱۰ به بعد). فایل نصبی OllamaSetup.exe هم در صفحهٔ دانلود Ollama و بخش Releases گیتهاب آن هست.
- ۲
Ollama را روی لینوکس یا مک نصب کنیدلینوکس
curl -fsSL https://ollama.com/install.sh | shهمین دستور روی مک (macOS 14 به بعد) هم کار میکند؛ روی مک میتوانید فایل نصبی را هم از سایت Ollama بگیرید.
- ۳
مدل را دانلود و اجرا کنید
ollama run gpt-oss:20bحدود ۱۴ گیگابایت دانلود میشود و بعد آفلاین کار میکند. برای سرور با کارت ۸۰ گیگابایتی gpt-oss:120b (۶۵ گیگابایت) را بزنید؛ برچسبهای 20b-cloud و 120b-cloud آفلاین نیستند.
- ۴
یا با LM Studio و Jan
lms get openai/gpt-oss-20bهمان دستوری که OpenAI در راهنمای gpt-oss آورده؛ اول LM Studio را از lmstudio.ai نصب و یکبار باز کنید. در Jan هم از تب Hub نام gpt-oss را جستوجو کنید.
- ۵
نصب کاملاً آفلاین با انتقال پوشهٔ مدلها
ollama pull gpt-oss:20bاین دستور را روی سیستم متصل بزنید و بعد پوشهٔ مدلها را منتقل کنید. پوشهٔ مدلهای Ollama در ویندوز و مک داخل .ollama/models در پوشهٔ کاربری است و در لینوکس /usr/share/ollama/.ollama/models؛ همین پوشه را به همان مسیر سیستم آفلاین کپی کنید یا مسیرش را با متغیر OLLAMA_MODELS بدهید. OpenAI فایل GGUF رسمی نداده و برای فایلهای GGUF دیگران در Ollama مشکل بارگذاری گزارش شده؛ برای همین این راه را به ساخت دستی با Modelfile ترجیح میدهیم.
- ۶
یا فایل GGUF را در LM Studio وارد کنید
lms import ./gpt-oss-20b-MXFP4.gguf --copyفایل ۱۲٫۱ گیگابایتی gpt-oss-20b-MXFP4.gguf را از مخزن ggml-org/gpt-oss-20b-GGUF (سازمان سازندگان llama.cpp، نه OpenAI) یکبار بگیرید و منتقل کنید. در Jan هم میتوانید همین فایل را از تنظیمات Llama.cpp با گزینهٔ Import وارد کنید.
دانلود
- Ollama ↗رسمی
20b و 120b؛ OpenAI در راهنمای رسمی به Ollama ارجاع داده. برچسبهای cloud آفلاین نیستند.
- Hugging Face (OpenAI) ↗رسمی
وزنهای اصلی با کوانتیزهٔ MXFP4؛ فرم دسترسی ندارد.
- LM Studio ↗رسمی
OpenAI در راهنمای gpt-oss دستور lms get را آورده است.
- GGUF (ggml-org) ↗غیررسمی
تبدیل GGUF از سازمان سازندگان llama.cpp؛ ساخت OpenAI نیست.
نکات امنیتی
- پورت 11434 را روی اینترنت باز نکنید: Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و API آن رمز ندارد؛ اگر روی شبکهٔ داخلی لازمش دارید، پشت پروکسی با احراز هویت یا فایروال بگذارید.
- فایل مدل را فقط از منبع رسمی بگیرید، GGUF یا safetensors را به فایلهای pickle (.bin یا .pt) ترجیح دهید و هش SHA256 فایل را با صفحهٔ دانلود مقایسه کنید.
- اگر به مدل اجازهٔ اجرای دستور، دسترسی به فایل یا ابزار میدهید (حالت ایجنت)، کارهای برگشتناپذیر مثل پاککردن و ارسال را فقط با تأیید دستی انجام دهید.
- زنجیرهٔ فکر خام مدل را به کاربر نهایی نشان ندهید؛ OpenAI میگوید برای نمایش به کاربر ساخته نشده است.
برای شرکتها و سازمانها
برای سرور شرکت، 120b روی یک کارت ۸۰ گیگابایتی جا میشود و OpenAI سرو با vLLM را در راهنمایش آورده است. 20b برای سرورهای کوچکتر و تیمهای کمتعداد مناسبتر است. هر دو با API سازگار با OpenAI (در Ollama، LM Studio یا vLLM) به ابزارهای موجود وصل میشوند.
برنامههایی که این مدل را اجرا میکنند
 اولاما
 الام استودیو
 اوپن وبیوآی
 دیفای
 لاما سیپیپی
 انیتینگالالام
 Jan
 ویالالام
 چری استودیو
 لوکالایآی
 کوبولد سیپیپی
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۴ مرداد ۱۴۰۴
معرفی: جیپیتی اواساس (آفلاین)
gpt-oss نام دو مدل وزنباز OpenAI است که اوت ۲۰۲۵ منتشر شدند: gpt-oss-20b با ۲۱ میلیارد پارامتر (۳٫۶ میلیارد فعال در هر توکن) و gpt-oss-120b با ۱۱۷ میلیارد پارامتر (۵٫۱ میلیارد فعال). هر دو فقط متن میگیرند و میدهند و سطح استدلالشان (کم، متوسط، زیاد) قابل تنظیم است.
برای برنامهنویسها و تیمهایی مناسب است که استدلال، ریاضی، کدنویسی و فراخوانی ابزار را بهصورت محلی میخواهند. OpenAI میگوید 20b در آزمونهای رایج نزدیک o3-mini و 120b در استدلال تقریباً همسطح o4-mini است.
سختافزار: 20b با کوانتیزهٔ MXFP4 در Ollama ۱۴ گیگابایت است و OpenAI میگوید با ۱۶ گیگابایت حافظه اجرا میشود؛ برآورد محتاطانهٔ ما ۱۹ گیگابایت رم یا ۱۷ گیگابایت حافظهٔ کارت گرافیک است. 120b با ۶۵ گیگابایت حجم برای یک کارت ۸۰ گیگابایتی (مثل H100) یا سروری با رم زیاد است.
شروع: ollama run gpt-oss:20b یا در LM Studio دستور lms get openai/gpt-oss-20b که OpenAI خودش در راهنمایش آورده است.
محدودیتها: به گفتهٔ OpenAI دادههای آموزشی عمدتاً انگلیسی بوده و فارسی در ارزیابی چندزبانهٔ رسمی نیست؛ برای نوشتن فارسی انتخاب خوبی نیست. دانش مدل تا ژوئن ۲۰۲۴ است و از اوت ۲۰۲۵ بهجز نسخههای ایمنی gpt-oss-safeguard نسخهٔ عمومی تازهای نیامده. برچسبهای cloud و جستوجوی وب Ollama آفلاین نیستند.
بهترین کاربردها
- •یه دستیار برنامهنویسی آفلاین روی کامپیوتر ۳۲ گیگ رم داشته باشم
- •مسئلهٔ ریاضی یا منطقی رو بدون اینترنت قدمبهقدم حل کنم
- •روی سرور شرکت یه مدل استدلالی داخلی بهجای API خارجی راه بندازم
- •یه ایجنت محلی بسازم که ابزار صدا بزنه و خروجی JSON بده
- •ابزار کدنویسی مثل Codex رو به یه مدل آفلاین وصل کنم
- •متنهای فنی انگلیسی رو آفلاین خلاصه کنم
برای این کارها سراغش نروید
- –نوشتن متن فارسی
- –فهم تصویر یا اسکن سند
- –ساخت تصویر
- –تبدیل گفتار به متن
تصاویر محیط ابزار
نقاط قوت
- ✓مجوز Apache 2.0 بههمراه سیاست استفادهٔ کوتاهی که فقط رعایت قانون را میخواهد
- ✓سطح استدلال قابل تنظیم (کم، متوسط، زیاد) و دسترسی کامل به زنجیرهٔ فکر برای اشکالیابی
- ✓MoE کممصرف: 20b در هر توکن فقط ۳٫۶ میلیارد پارامتر فعال دارد و روی سیستم ۱۶ گیگابایتی اجرا میشود
- ✓آموزشدیده برای فراخوانی ابزار، خروجی ساختاریافته و کار ایجنتی
- ✓پشتیبانی رسمی در Ollama و LM Studio که OpenAI خودش در راهنما آورده
نقاط ضعف
- ✗20b دستکم ۱۶ گیگابایت حافظه میخواهد (برآورد محتاطانهٔ ما ۱۹ گیگابایت رم) و 120b به کارت گرافیک ۸۰ گیگابایتی یا سرور قوی نیاز دارد
- ✗فقط متن؛ تصویر و صدا نمیفهمد
- ✗دادههای آموزشی عمدتاً انگلیسی؛ فارسی ضعیف و ارزیابینشده
- ✗دانش تا ژوئن ۲۰۲۴ و بدون نسخهٔ عمومی تازه از اوت ۲۰۲۵
- ✗OpenAI فایل GGUF رسمی منتشر نکرده و برای فایلهای GGUF دیگران در Ollama مشکل بارگذاری گزارش شده است
پرسشهای پرتکرار
gpt-oss-20b روی لپتاپ من اجرا میشود؟
OpenAI میگوید 20b با ۱۶ گیگابایت حافظه اجرا میشود. فایلش در Ollama ۱۴ گیگابایت است و برآورد محتاطانهٔ ما ۱۹ گیگابایت رم یا ۱۷ گیگابایت حافظهٔ کارت گرافیک است. روی لپتاپ ۱۶ گیگابایتی جای کمی برای برنامههای دیگر میماند؛ با ۳۲ گیگابایت رم خیالتان راحت است.
فارسی را خوب مینویسد؟
نه چندان. OpenAI میگوید دادههای آموزشی عمدتاً انگلیسی بوده و فارسی در ارزیابی چندزبانهٔ رسمی (MMMLU با ۱۴ زبان) نیست. برای سؤال فنی و کد به انگلیسی خوب است؛ برای متن فارسی سراغ کوئن ۳.۵ یا جما ۴ بروید.
فرق 20b و 120b چیست؟
20b برای اجرای محلی و کارهای سبکتر است و OpenAI آن را نزدیک o3-mini میداند. 120b برای سرور و کارهای سنگین است، در استدلال تقریباً همسطح o4-mini، و روی یک کارت ۸۰ گیگابایتی جا میشود. هر دو فقط متناند و حافظهٔ متنی ۱۲۸ هزار توکنی دارند.
بدون اینترنت چطور نصبش کنم؟
مطمئنترین راه: روی سیستم متصل ollama pull gpt-oss:20b بزنید و پوشهٔ مدلهای Ollama را به سیستم آفلاین کپی کنید. اگر LM Studio دارید، فایل gpt-oss-20b-MXFP4.gguf (از مخزن ggml-org، سازمان سازندگان llama.cpp) را با lms import وارد کنید.
استفادهٔ تجاری مجاز است و به حساب OpenAI نیاز دارد؟
مجوز Apache 2.0 است و سیاست استفادهٔ OpenAI برای این مدل فقط رعایت قوانین را میخواهد؛ استفادهٔ تجاری آزاد است. مدل را یکبار دانلود میکنید و برای اجرا به حساب یا سرور OpenAI نیازی ندارد.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
کوئن ۳.۸ 27B (آفلاین)
Qwen3.8-27B (offline)
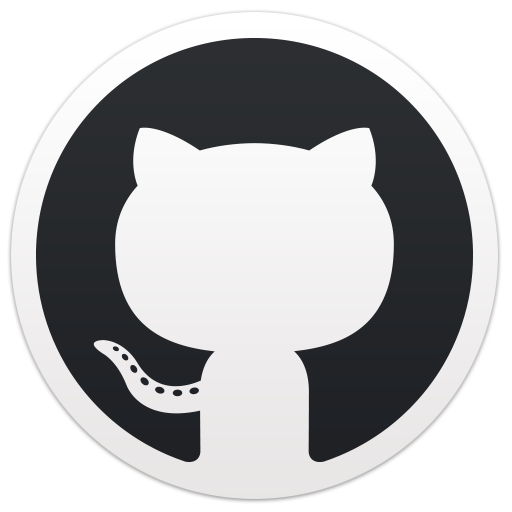
قویترین مدل ۲۷ میلیاردی Qwen (اوت ۲۰۲۶) برای کارت گرافیک ۲۴ گیگابایتی: کدنویسی ایجنتی، کار با سند و تصویر و استدلال، طبق جدول Qwen نزدیک به Qwen3.7-Plus آنلاین، با مجوز Apache 2.0.
کدکس
Codex
ایجنت کدنویسی OpenAI: در ترمینال (CLI)، IDE، وب و حتی موبایل کار میکند؛ کد مینویسد، تست میگیرد، PR میسازد و از ژوئیه ۲۰۲۶ با خانواده GPT-5.6 اجرا میشود.
هاگینگ فیس
Hugging Face
گیتهابِ دنیای هوش مصنوعی؛ بزرگترین مرجع مدلهای متنباز، دیتاستها و دموهای آنلاین (Spaces) که هر توسعهدهنده هوش مصنوعی دیر یا زود سر و کارش به آن میافتد.