اومنیویس (آفلاین)
OmniVoice (offline)مدل تبدیل متن به گفتار تیم k2-fsa با پشتیبانی رسمی فارسی: کلون صدا از یک نمونهٔ کوتاه، ساخت صدای تازه با توصیف جنسیت، سن و لهجه، و ۶۴۶ زبان. فایلش ۲٫۴۵ گیگابایت است و روی کارت ۴ گیگابایتی آزموده شده. خطای حروف گفتار فارسیاش ۱٫۹۰٪ است در برابر ۱٫۵۷٪ صدای واقعی؛ وزنها فقط برای کار غیرتجاری آزادند.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- CC-BY-NC (weights), Apache-2.0 (code) — فقط غیرتجاری
- فارسی: خوب
بعد از نصب و دانلود وزنها بدون اینترنت کار میکند. اگر متن نمونهٔ مرجع (ref_text) را ندهید، بسته برای رونویسی آن یک مدل Whisper دانلود و اجرا میکند؛ روی سیستم آفلاین متن نمونه را خودتان وارد کنید.
کد با Apache-2.0 آزاد است، ولی وزنهای آموزشدیده به خاطر محدودیت دادهٔ آموزشی (مثل Emilia) مجوز CC-BY-NC دارند و استفادهٔ تجاری از آنها مجاز نیست. برای کار پولی مدلی با مجوز تجاری انتخاب کنید.
نسخهها و سختافزار لازم
- OmniVoice (فایل رسمی)۸۰۰M
- حافظهٔ لازم:
- کارت گرافیک ۴ گیگ یا رم ۸ گیگ
یک فایل model.safetensors به حجم ۲٫۴۵ گیگابایت: هستهٔ ۰٫۶ میلیاردی (بر پایهٔ Qwen3-0.6B) بهعلاوهٔ توکنایزر و vocoder. خروجی ۲۴ کیلوهرتز.
- GGUF برای audio.cpp (جامعه)۸۰۰M
- حافظهٔ لازم:
- کارت گرافیک ۱ گیگ یا رم ۳ گیگ
تبدیل جامعه در دقتهای BF16، F16 و Q8 برای audio.cpp (نسخهٔ ۰٫۹)؛ فقط با پردازنده یا روی کارت کوچکتر اجرا میشود. حجم هر فایل و حداقل حافظه اعلام نشده. نسخهٔ جامعهٔ دیگر: Serveurperso/OmniVoice-GGUF.
نصب و اجرا
- ۱
PyTorch را نصب کنید
pip install torch==2.8.0+cu128 torchaudio==2.8.0+cu128 --extra-index-url https://download.pytorch.org/whl/cu128این دستور برای کارت انویدیاست؛ روی مک یا Intel Arc نسخهٔ مناسب PyTorch را نصب کنید.
- ۲
بستهٔ OmniVoice را نصب کنید
pip install omnivoiceآخرین نسخه 0.2.1 (۱۶ ژوئیهٔ ۲۰۲۶) است.
- ۳
رابط وب محلی را اجرا کنید
omnivoice-demo --ip 127.0.0.1 --port 8001بعد http://127.0.0.1:8001 را در مرورگر باز کنید. مثال راهنمای رسمی --ip 0.0.0.0 است که رابط را روی شبکه باز میکند؛ روی کامپیوتر شخصی 127.0.0.1 امنتر است. اگر متن نمونهٔ مرجع را ندهید، برنامه برای رونویسی آن Whisper دانلود میکند.
- ۴
اختیاری: اجرا در ComfyUI
نود جامعهٔ TTS-Audio-Suite (نسخهٔ ۵٫۶) OmniVoice را با دانلود حدود ۳٫۷ گیگابایت به ComfyUI اضافه میکند. این نود کار سازندگان OmniVoice نیست.
دانلود
- k2-fsa/OmniVoice (Hugging Face) ↗رسمی
وزنها، کارت مدل و مجوز.
- k2-fsa/OmniVoice (GitHub) ↗رسمی
کد، راهنمای نصب و برنامههای جامعه.
- فهرست زبانهای OmniVoice ↗رسمی
۶۴۶ زبان با ساعت دادهٔ هر زبان؛ فارسی ۳۶۶ ساعت.
- مقالهٔ OmniVoice (arXiv) ↗رسمی
جدول ارزیابی هر زبان، از جمله فارسی.
- TTS-Audio-Suite (GitHub) ↗غیررسمی
نود جامعه برای اجرای OmniVoice و مدلهای صوتی دیگر در ComfyUI.
- audio.cpp (GitHub) ↗غیررسمی
اجرای C++ بدون پایتون؛ با پردازنده هم کار میکند.
- audio-cpp/audio.cpp-gguf (Hugging Face) ↗غیررسمی
فایلهای GGUF جامعه (BF16، F16 و Q8) برای audio.cpp.
نکات امنیتی
- وزنها از نوع .safetensors هستند؛ فقط از مخزن k2-fsa دانلود کنید.
- اگر متن نمونهٔ مرجع (ref_text) را ندهید، بسته یک مدل Whisper را دانلود و اجرا میکند.
- در راهنما نشانی از واترمارک صوتی نیست؛ صدای کسی را بدون اجازهاش کلون نکنید. سلب مسئولیت سازندگان جعل هویت و کلاهبرداری را ممنوع میکند.
- رابط وب را با --ip 0.0.0.0 روی شبکه باز نکنید مگر پشت رمز عبور؛ 127.0.0.1 فقط روی همان کامپیوتر در دسترس است.
- اجرا در ComfyUI به نود شخص ثالث وابسته است؛ فقط نسخهٔ اصلی TTS-Audio-Suite را نصب کنید.
برای شرکتها و سازمانها
برای کار تجاری شرکت مناسب نیست، چون وزنها مجوز غیرتجاری CC-BY-NC دارند. برای ساخت محتوای پولی، Higgs TTS 3 را ببینید که با Creator Use Grant کسب درآمد از پادکست و ویدیو را با ذکر نام آزاد گذاشته است؛ محصول یا API بر پایهٔ آن هم مجوز تجاری جدا میخواهد.
برنامههایی که این مدل را اجرا میکنند
 کامفییوآی
همسطح ابری
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۴ اسفند ۱۴۰۴
معرفی: اومنیویس (آفلاین)
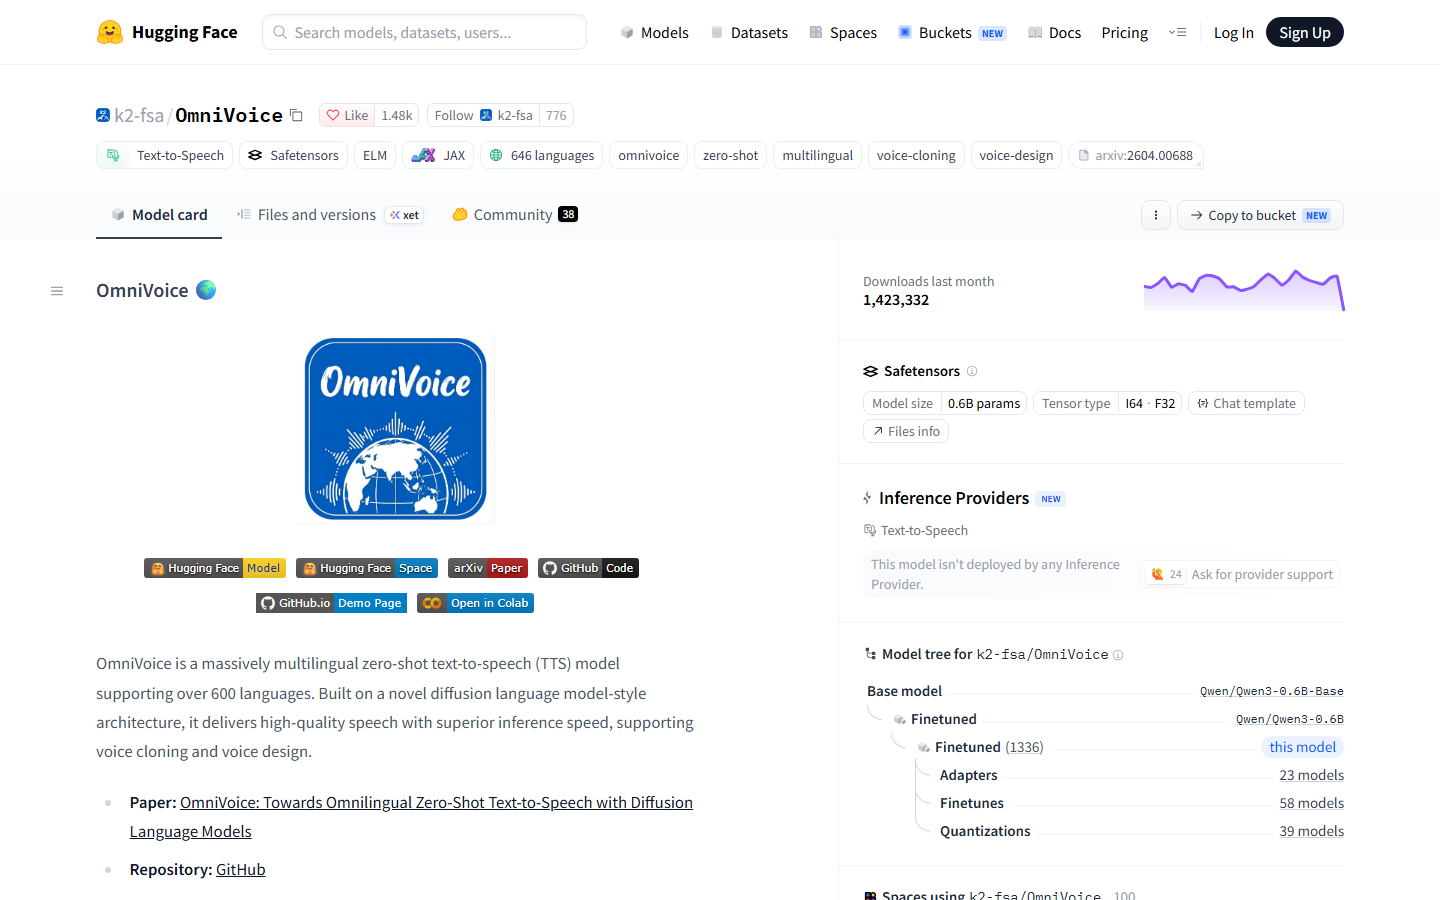
OmniVoice مدل تبدیل متن به گفتار تیم k2-fsa (Next-gen Kaldi) است؛ دنیل پووی از نویسندگان مقالهٔ آن است. وزنها ۳۰ مارس ۲۰۲۶ روی Hugging Face منتشر شدند و آخرین بستهٔ پایتون، omnivoice 0.2.1، ۱۶ ژوئیهٔ ۲۰۲۶ آمد (نسخهٔ 0.2.0 پشتیبانی کارتهای Intel Arc را اضافه کرد). مدل تازه نیست، ولی در اکتبر ۲۰۲۶ سومین مدل پرطرفدار تبدیل متن به گفتار در Hugging Face است و ۱٫۴۲ میلیون بار دانلود شده.
کارها: کلون صدا بدون آموزش از یک نمونهٔ کوتاه، ساخت صدای تازه با توصیف (جنسیت، سن، زیر و بمی، لهجه، نجوا)، برچسبهای غیرکلامی مثل [laughter] و اصلاح تلفظ. خروجی ۲۴ کیلوهرتز است و سرعتش در بهترین حالت تا ۴۰ برابر سریعتر از زمان واقعی است (RTF برابر ۰٫۰۲۵). با ۵۸۱ هزار ساعت داده برای ۶۴۶ زبان آموزش دیده که ۳۶۶ ساعتش فارسی است.
فارسی: در ارزیابی مقالهٔ سازندگان روی FLEURS، نرخ خطای حروف (CER) گفتار فارسی ساختهشده ۱٫۹۰٪ بود، در برابر ۱٫۵۷٪ برای صدای واقعی؛ یعنی خروجی فارسی تقریباً به اندازهٔ صدای واقعی قابلفهم است. طبیعی بودن لحن اندازهگیری نشده است.
سختافزار: هستهٔ مدل حدود ۰٫۶ میلیارد پارامتر است (بر پایهٔ Qwen3-0.6B؛ با توکنایزر و vocoder حدود ۰٫۸ میلیارد) و فایل model.safetensors آن ۲٫۴۵ گیگابایت. روی Intel Arc A310 با ۴ گیگابایت حافظه آزموده شده و روی کارت انویدیا، مک اپل سیلیکون و Intel Arc اجرا میشود. راههای اجرا: بستهٔ پایتون omnivoice با رابط وب محلی، ComfyUI با نود جامعهٔ TTS-Audio-Suite، و audio.cpp با نسخههای GGUF که فقط با پردازنده هم اجرا میشوند.
محدودیت مهم: کد Apache-2.0 است ولی وزنها به خاطر دادهٔ آموزشی (مثل Emilia) مجوز غیرتجاری CC-BY-NC دارند. سلب مسئولیت سازندگان کلون صدای دیگران بدون اجازه، جعل هویت و کلاهبرداری را ممنوع میکند.
بهترین کاربردها
- •متن فارسی را آفلاین روی کامپیوتر خودم به گفتار تبدیل کنم
- •صدای خودم را بدون آپلود در اینترنت کلون کنم و با آن متن فارسی بخوانم
- •بدون اینترنت برای کتاب صوتی یا پادکست شخصی گویندهٔ فارسی بسازم
- •با کارت گرافیک ۴ گیگابایتی تبدیل متن به گفتار را روی سیستم خودم اجرا کنم
- •روی لپتاپ خودم صدای تازه با توصیف جنسیت، سن و لهجه بسازم (آفلاین)
- •جایگزین آفلاین و رایگان ElevenLabs برای کار غیرتجاری روی کامپیوتر خودم
برای این کارها سراغش نروید
- –تبدیل گفتار به متن و تایپ فایل صوتی
- –فروش یا استفادهٔ تجاری از صدای ساختهشده
- –دوبلهٔ خودکار ویدیو
- –ساخت آهنگ و موسیقی
تصاویر محیط ابزار
نقاط قوت
- ✓پشتیبانی رسمی فارسی با ۳۶۶ ساعت دادهٔ آموزشی؛ خطای حروف ۱٫۹۰٪ در برابر ۱٫۵۷٪ صدای واقعی
- ✓کلون صدا از یک نمونهٔ کوتاه و ساخت صدای تازه با توصیف
- ✓سبک: فایل ۲٫۴۵ گیگابایتی که روی کارت ۴ گیگابایتی آزموده شده
- ✓روی کارت انویدیا، مک اپل سیلیکون و Intel Arc اجرا میشود
- ✓رابط وب محلی، برچسبهای غیرکلامی مثل [laughter] و اصلاح تلفظ
- ✓۶۴۶ زبان در یک مدل
نقاط ضعف
- ✗نصب با پایتون و خط فرمان است (PyTorch و بستهٔ omnivoice) و برای سرعت کارت گرافیک دستکم ۴ گیگابایتی لازم است؛ اجرای فقط با پردازنده از راه audio.cpp است
- ✗وزنها مجوز غیرتجاری CC-BY-NC دارند و برای کار پولی مناسب نیستند
- ✗طبیعی بودن لحن فارسی اندازهگیری نشده؛ فقط قابلفهم بودن سنجیده شده
- ✗ComfyUI آن را فقط با نود جامعهٔ TTS-Audio-Suite اجرا میکند
قیمتگذاری
رایگان (وزن باز)
Free (open weights)رایگان
- • کد Apache-2.0
- • وزنها فقط برای استفادهٔ غیرتجاری (CC-BY-NC)
قیمتها تقریبی و بر اساس آخرین بازبینی است؛ برای قیمت دقیق به سایت رسمی مراجعه کنید.
پرسشهای پرتکرار
فارسی را خوب میخواند؟
فارسی جزو زبانهای رسمی است و ۳۶۶ ساعت دادهٔ فارسی دیده. در ارزیابی مقالهٔ سازندگان، خطای حروف گفتار فارسی ساختهشده ۱٫۹۰٪ بود در برابر ۱٫۵۷٪ صدای واقعی، یعنی خروجی بسیار قابلفهم است. طبیعی بودن لحن سنجیده نشده؛ با یک نمونهٔ مرجع فارسی تمیز امتحان کنید.
با چه کارت گرافیکی اجرا میشود؟
روی Intel Arc A310 با ۴ گیگابایت حافظه آزموده شده و روی کارت انویدیا و مک اپل سیلیکون هم اجرا میشود. فایل مدل ۲٫۴۵ گیگابایت است. بدون کارت گرافیک هم میشود نسخههای GGUF را در audio.cpp فقط با پردازنده اجرا کرد.
برای کار تجاری آزاد است؟
نه. کد Apache-2.0 است ولی وزنها مجوز غیرتجاری CC-BY-NC دارند. برای کتاب صوتی فروشی، تبلیغ یا محصول، مدلی با مجوز تجاری انتخاب کنید.
چطور نصب کنم؟
اول PyTorch را نصب کنید، بعد pip install omnivoice و در آخر omnivoice-demo را اجرا کنید تا رابط وب در مرورگر باز شود. اگر ComfyUI دارید، نود جامعهٔ TTS-Audio-Suite هم آن را اجرا میکند.
کلون کردن صدای دیگران مجاز است؟
فقط با اجازهٔ صاحب صدا. سلب مسئولیت سازندگان کلون بدون اجازه، جعل هویت و کلاهبرداری را ممنوع میکند و در راهنما واترمارکی ذکر نشده، پس مسئولیت استفاده با خود شماست.
بدون اینترنت کار میکند؟
بله، بعد از نصب و دانلود وزنها. فقط اگر متن نمونهٔ مرجع را ندهید، بسته برای رونویسی آن یک مدل Whisper دانلود و اجرا میکند؛ روی سیستم آفلاین متن نمونه را خودتان وارد کنید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
ویساستودیو
VoiceStudio
استودیوی صدای رایگان، متنباز و کاملاً آفلاین (نام قبلی OmniVoice Studio): کلون صدا از چند ثانیه نمونه، ساخت صدای جدید با توصیف، دوبلهٔ ویدئو و تبدیل گفتار به متن در ۶۴۶ زبان — از جمله فارسی — روی کامپیوتر خودتان.

مینیمکس صدا
MiniMax Audio
بخش صدا و موسیقی MiniMax (minimax.io/audio): تبدیل متن به گفتار طبیعی با Speech 2.8 در ۴۰ زبان از جمله فارسی، طراحی صدا از روی توصیف، کلون از نمونهٔ کوتاه، جداسازی صدا و ساخت آهنگ کامل با Music 3.0.
مورف
Murf AI
استودیوی ساخت صدای گوینده با هوش مصنوعی؛ متن را تایپ میکنید و با صدها صدای طبیعی برای ویدئو، دورهٔ آموزشی و تبلیغ نریشن میگیرید.