کوئن ۳ کدر (آفلاین)
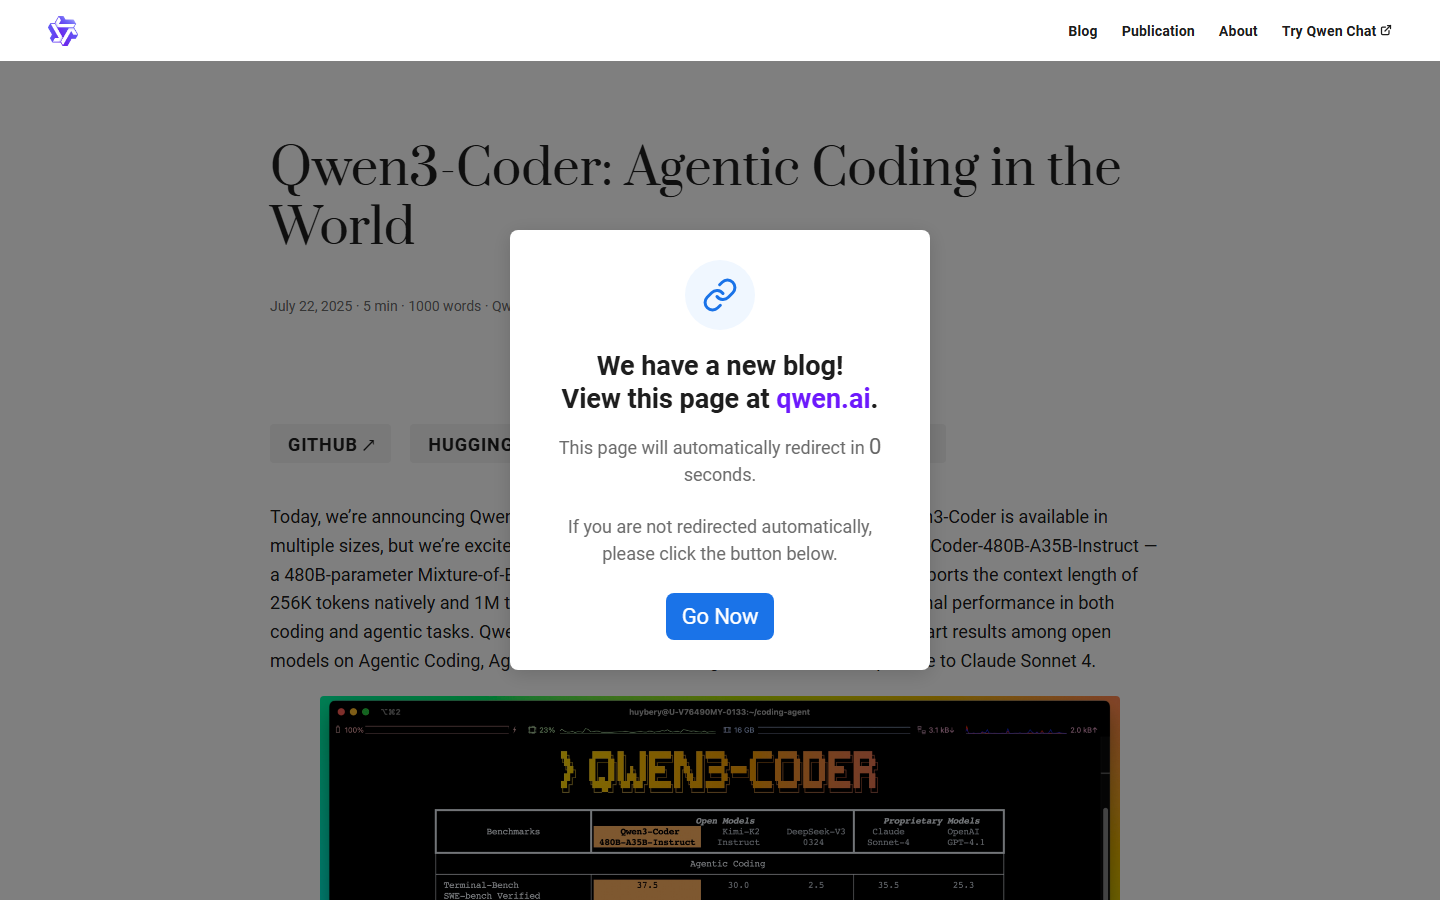
Qwen3-Coder (offline)مدل برنامهنویسی متنباز علیبابا در سه اندازه (30B، Next با ۸۰ میلیارد و 480B)؛ دو نسخهٔ کوچکتر فقط ۳ میلیارد پارامتر فعال دارند و ایجنت کدنویسی و تکمیل کد را بدون اینترنت اجرا میکنند. مجوز Apache 2.0.
اجرا روی سیستم خودتان
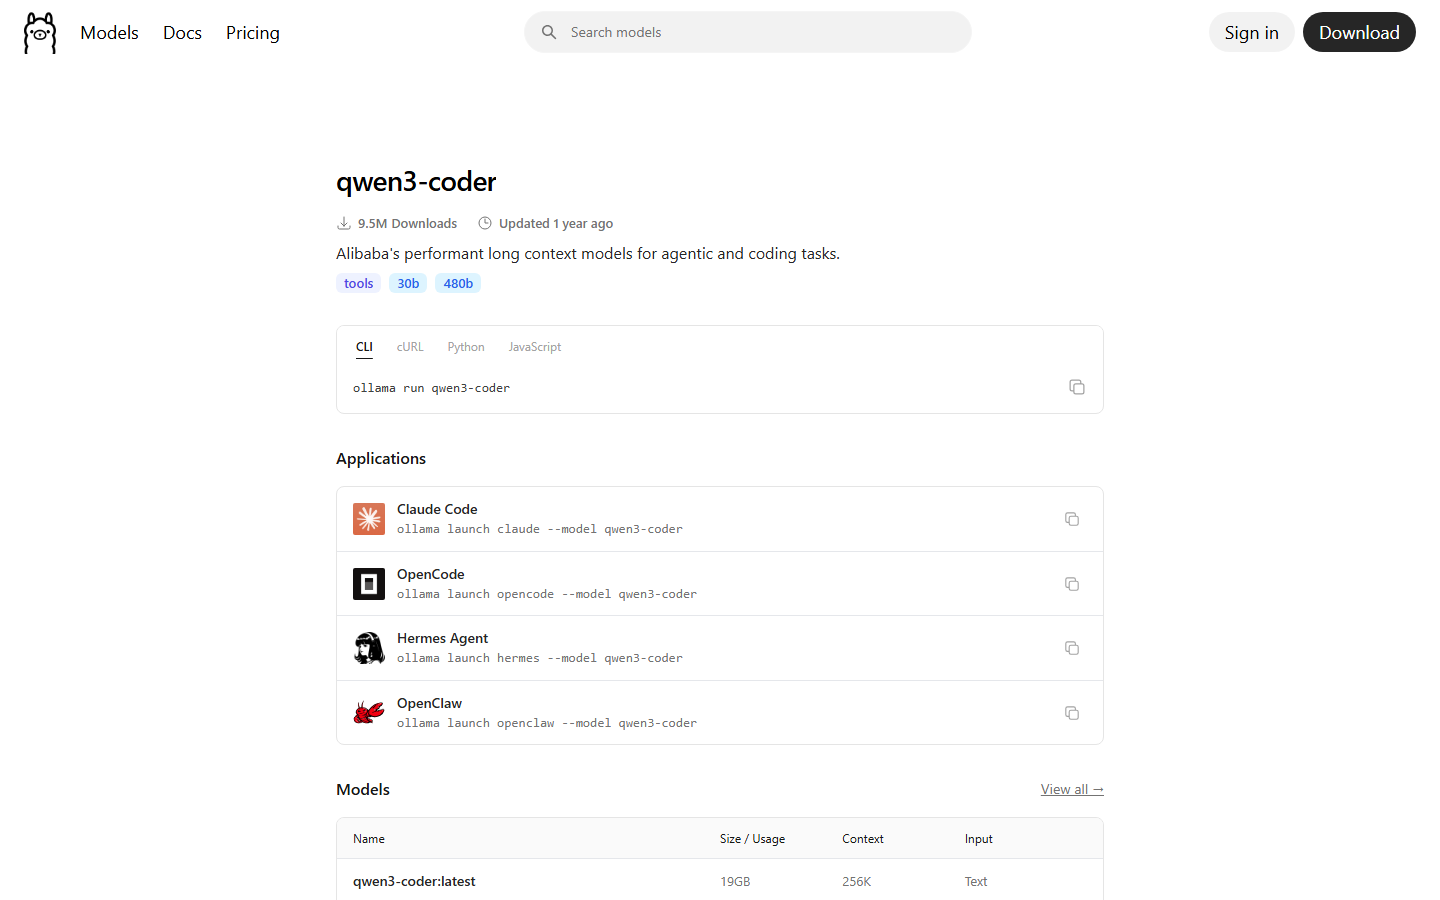
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- Apache-2.0 — استفادهٔ تجاری آزاد
- فارسی: نامعلوم
- برنامهٔ گرافیکی
- خط فرمان
- API
فقط دانلود اول اینترنت میخواهد؛ بعد از آن Ollama یا LM Studio کاملاً آفلاین اجرا میشوند.
استفادهٔ تجاری، تغییر و بازتوزیع آزاد است؛ فقط متن مجوز و اعلانها را همراه نسخهای که پخش میکنید نگه دارید.
نسخهها و سختافزار لازم
- 30B-A3B۳۰٫۵B (فعال ۳٫۳B)طول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۱۹ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۲۳ گیگ یا رم ۲۵ گیگ
ollama run qwen3-coder:30bبرای کارت ۲۴ گیگابایتی (مثل RTX 3090 یا 4090) یا کامپیوتر و مک ۳۲ گیگابایتی. حجمها از Ollama است (نسخهٔ ۱۶ بیتی را برچسب fp16 نوشته) و حداقل حافظه برآوردی است.
- Next (80B-A3B)۸۰B (فعال ۳B)طول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۵۲ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۶۳ گیگ یا رم ۶۵ گیگ
ollama run qwen3-coder-nextجدیدترین و قویترین نسخه (فوریهٔ ۲۰۲۶). حجم ۴ و ۸ بیتی از Ollama و حجم ۱۶ بیتی از مخزن رسمی است؛ Qwen نسخهٔ FP8 (حدود ۸۰ گیگابایت) را هم برای سرور منتشر کرده. حداقل حافظه برآوردی است.
- 480B-A35B۴۸۰B (فعال ۳۵B)طول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۲۹۰ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۳۴۸ گیگ یا رم ۳۵۰ گیگ
ollama run qwen3-coder:480bفقط برای سرور. Ollama دستکم ۲۵۰ گیگابایت حافظه را لازم میداند؛ برآورد ما با حاشیهٔ اطمینان حدود ۳۵۰ گیگابایت است.
نصب و اجرا
- ۱
Ollama را نصب کنیدلینوکس
curl -fsSL https://ollama.com/install.sh | shدر ویندوز و مک، برنامهٔ نصب را از ollama.com/download بگیرید.
- ۲
نسخهٔ 30B را بگیرید و اجرا کنید
ollama run qwen3-coder:30bحدود ۱۹ گیگابایت دانلود. برای نسخهٔ قویتر: ollama run qwen3-coder-next (حدود ۵۲ گیگابایت).
- ۳
یا با LM Studio
lms get qwen/qwen3-coder-30bبرای نسخهٔ Next شناسهٔ qwen/qwen3-coder-next را بگیرید.
- ۴
ابزار خط فرمان Qwen Code را نصب کنید
npm install -g @qwen-code/qwen-code@latestNode.js نسخهٔ ۲۲ به بالا لازم است. در پوشهٔ پروژه فرمان qwen را بزنید و با /auth آدرس Ollama (http://localhost:11434/v1) را بدهید. در VS Code هم میتوانید Cline یا Kilo Code را به همین آدرس وصل کنید.
- ۵
روی سرور چندکارته با vLLMلینوکس
vllm serve Qwen/Qwen3-Coder-Next --port 8000 --tensor-parallel-size 2 --enable-auto-tool-choice --tool-call-parser qwen3_coderدستور رسمی Qwen؛ vLLM نسخهٔ 0.15.0 یا جدیدتر لازم است. اگر سرویس بالا نیامد، طول متن را با --max-model-len 32768 کم کنید.
دانلود
- Ollama — qwen3-coder ↗رسمی
نسخههای 30B و 480B.
- Ollama — qwen3-coder-next ↗رسمی
نسخهٔ Next (حدود ۵۲ گیگابایت).
- Hugging Face (مخزن رسمی Qwen) ↗رسمی
وزن کامل Next؛ نسخههای 30B و 480B هم در همین حساب هستند.
- Hugging Face — GGUF رسمی Next ↗رسمی
Q4_K_M حدود ۴۸ گیگابایت؛ برای وارد کردن دستی در Ollama یا llama.cpp.
- ModelScope (حساب رسمی Qwen) ↗رسمی
همان وزنها روی ModelScope؛ گیتهاب رسمی Qwen به آن لینک داده است.
- LM Studio ↗رسمی
نسخههای 30B و 480B برای LM Studio.
نکات امنیتی
- ایجنت برنامهنویسی میتواند فایل پاک کند و دستور اجرا کند؛ در پوشهٔ پروژهٔ تحت گیت کار کنید، هر تغییر را پیش از تأیید ببینید و فایلهای .env و کلیدها را از دسترسش دور نگه دارید.
- پورت ۱۱۴۳۴ Ollama را به اینترنت باز نکنید؛ Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و بهتر است همینطور بماند.
- وزنها را فقط از مخزن رسمی سازنده یا کتابخانههای شناختهشده (Ollama، LM Studio) بگیرید؛ قالب safetensors و GGUF کد اجرایی ندارند.
برای شرکتها و سازمانها
برای تیم برنامهنویسی: نسخهٔ 30B روی کامپیوتر هر برنامهنویس جا میشود. برای سرویس مشترک، نسخهٔ Next را با vLLM یا SGLang روی سرور چندکارته بالا بیاورید (دستور رسمی روی ۲ کارت) تا چند برنامهنویس همزمان از آن استفاده کنند؛ تعداد دقیق کاربر همزمان به طول متنها بستگی دارد.
برنامههایی که این مدل را اجرا میکنند
 اولاما
 الام استودیو
 لاما سیپیپی
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۴ تیر ۱۴۰۴
معرفی: کوئن ۳ کدر (آفلاین)
Qwen3-Coder خانوادهٔ مدلهای برنامهنویسی تیم Qwen در علیبابا است. نسخهٔ 30B-A3B در ژوئیهٔ ۲۰۲۵ آمد و Qwen3-Coder-Next با ۸۰ میلیارد پارامتر در ۳ فوریهٔ ۲۰۲۶. هر دو در هر توکن فقط حدود ۳ میلیارد پارامتر را به کار میگیرند و برای همین روی سختافزار خانگی سریعاند. نسخهٔ بزرگ 480B هم برای سرور هست.
برای برنامهنویسهایی است که نمیخواهند کدشان به سرور خارجی برود: نوشتن و ویرایش کد، کار ایجنتی با ابزار، فهم کل مخزن (تا ۲۵۶ هزار توکن) و تکمیل وسط کد (FIM). با ابزارهایی مثل Qwen Code، Cline و Kilo کار میکند.
سختافزار: نسخهٔ 30B در Ollama حدود ۱۹ گیگابایت است و روی کارت ۲۴ گیگابایتی یا کامپیوتر و مک ۳۲ گیگابایتی اجرا میشود. Qwen3-Coder-Next حدود ۵۲ گیگابایت است و دستگاهی با دستکم حدود ۶۵ گیگابایت حافظه میخواهد (برآورد)؛ LM Studio نسخهٔ سبکتری از آن با حداقل ۴۲ گیگابایت دارد.
برای شروع، Ollama را نصب کنید و ollama run qwen3-coder:30b را بزنید، یا همین مدل را در LM Studio بگیرید. بعد افزونهٔ برنامهنویسی را به API محلی (http://localhost:11434/v1) وصل کنید.
محدودیتها: فقط حالت بدون فکر (non-thinking) دارد و استدلال مرحلهبهمرحله نمینویسد، عکس و اسکرینشات نمیفهمد و دربارهٔ فارسیاش چیزی اعلام نشده است.
بهترین کاربردها
- •یک دستیار برنامهنویسی آفلاین شبیه Copilot روی لپتاپ خودم داشته باشم
- •بدون فرستادن کد شرکت به سرور خارجی با هوش مصنوعی کد بنویسم
- •روی کامپیوتر با کارت گرافیک ۲۴ گیگابایتی یک مدل کدنویسی قوی اجرا کنم
- •ایجنت برنامهنویسی مثل Cline یا Qwen Code را به مدل محلی وصل کنم
- •تکمیل خودکار کد را آفلاین در ویرایشگر داشته باشم
- •باگ پروژه را بدون اینترنت پیدا و رفع کنم
- •برای تیم برنامهنویسی یک مدل کدنویسی روی سرور داخلی راه بیندازم
- •کل مخزن کد را (تا ۲۵۶ هزار توکن) به مدل آفلاین بدهم و سؤال بپرسم
برای این کارها سراغش نروید
- –چت عمومی و نوشتن متن فارسی (مدلهای عمومی برای این کار بهترند)
- –خواندن عکس یا اسکرینشات
- –ساخت تصویر یا طراحی گرافیک
- –استدلال ریاضی مرحلهبهمرحله (حالت فکر کردن ندارد)
تصاویر محیط ابزار
نقاط قوت
- ✓مجوز Apache 2.0؛ استفادهٔ تجاری آزاد
- ✓سه اندازه: 30B برای کامپیوتر قوی خانگی، Next برای مک یا سرور کوچک، 480B برای سرور بزرگ
- ✓فقط ۳ میلیارد پارامتر فعال در نسخههای 30B و Next؛ روی سختافزار خانگی سریع است
- ✓پنجرهٔ متن ۲۵۶ هزار توکنی برای خواندن کل مخزن
- ✓ابزارخوانی (tool calling) و تکمیل وسط کد (FIM) دارد
- ✓در Ollama و LM Studio با یک فرمان نصب میشود
نقاط ضعف
- ✗نسخهٔ 30B دستکم حدود ۲۳ گیگابایت حافظهٔ کارت گرافیک یا ۲۵ گیگابایت رم (برآورد) میخواهد و نسخهٔ Next حدود ۶۵ گیگابایت
- ✗فقط حالت بدون فکر (non-thinking) دارد و استدلال مرحلهبهمرحله نمینویسد
- ✗عکس و اسکرینشات نمیفهمد
- ✗کیفیت فارسیاش رسماً سنجیده نشده
- ✗نسخهٔ 480B فقط روی سرور بزرگ اجرا میشود (Ollama دستکم ۲۵۰ گیگابایت حافظه را لازم میداند)
پرسشهای پرتکرار
کدام نسخه را نصب کنم؟
کارت گرافیک ۲۴ گیگابایتی یا کامپیوتر و مک ۳۲ گیگابایتی: qwen3-coder:30b. مک یا کامپیوتر با دستکم حدود ۶۵ گیگابایت حافظهٔ آزاد: qwen3-coder-next که جدیدتر و قویتر است. نسخهٔ 480B فقط برای سرور است.
کارت گرافیک ندارم؛ اجرا میشود؟
بله، با رم کافی (حدود ۲۵ گیگابایت برای 30B) روی پردازنده هم اجرا میشود و کندتر است. چون فقط ۳ میلیارد پارامتر فعال دارد، از مدلهای متراکم هماندازه سریعتر است.
فارسی میفهمد؟
کارت مدل چیزی دربارهٔ فارسی نمیگوید. خانوادهٔ Qwen3 فارسی را در فهرست ۱۱۹ زبانش دارد، ولی این مدل برای کد تنظیم شده؛ برای توضیح و کامنت فارسی اول امتحان کنید.
به VS Code وصل میشود؟
بله. افزونههایی مثل Cline یا Kilo Code را روی ارائهدهندهٔ Ollama یا OpenAI Compatible با آدرس http://localhost:11434/v1 بگذارید. ابزار خط فرمان Qwen Code هم به Ollama وصل میشود.
استفادهٔ تجاری آزاد است؟
بله؛ مجوز Apache 2.0 است. فقط متن مجوز را همراه نسخه نگه دارید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
آنتیگرویتی
Google Antigravity
پلتفرم توسعه ایجنتمحور گوگل: IDE دسکتاپ + CLI + SDK؛ نسخه 2.0 (I/O 2026) با ایجنتهای موازی، سندباکس ابری و پلن رایگان واقعی.
کرسر
Cursor
ادیتور کدنویسی مبتنی بر هوش مصنوعی؛ ویرایش چندفایله، درک کل پروژه و ایجنتهایی که خودشان کد میزنند و تست میکنند.
گیتهاب کوپایلوت
GitHub Copilot
دستیار کدنویسی گیتهاب داخل VS Code و IDEهای دیگر؛ تکمیل خودکار، چت و ایجنت با پلن رایگان برای شروع.