لاما سیپیپی
llama.cppمحصول هاگینگ فیس
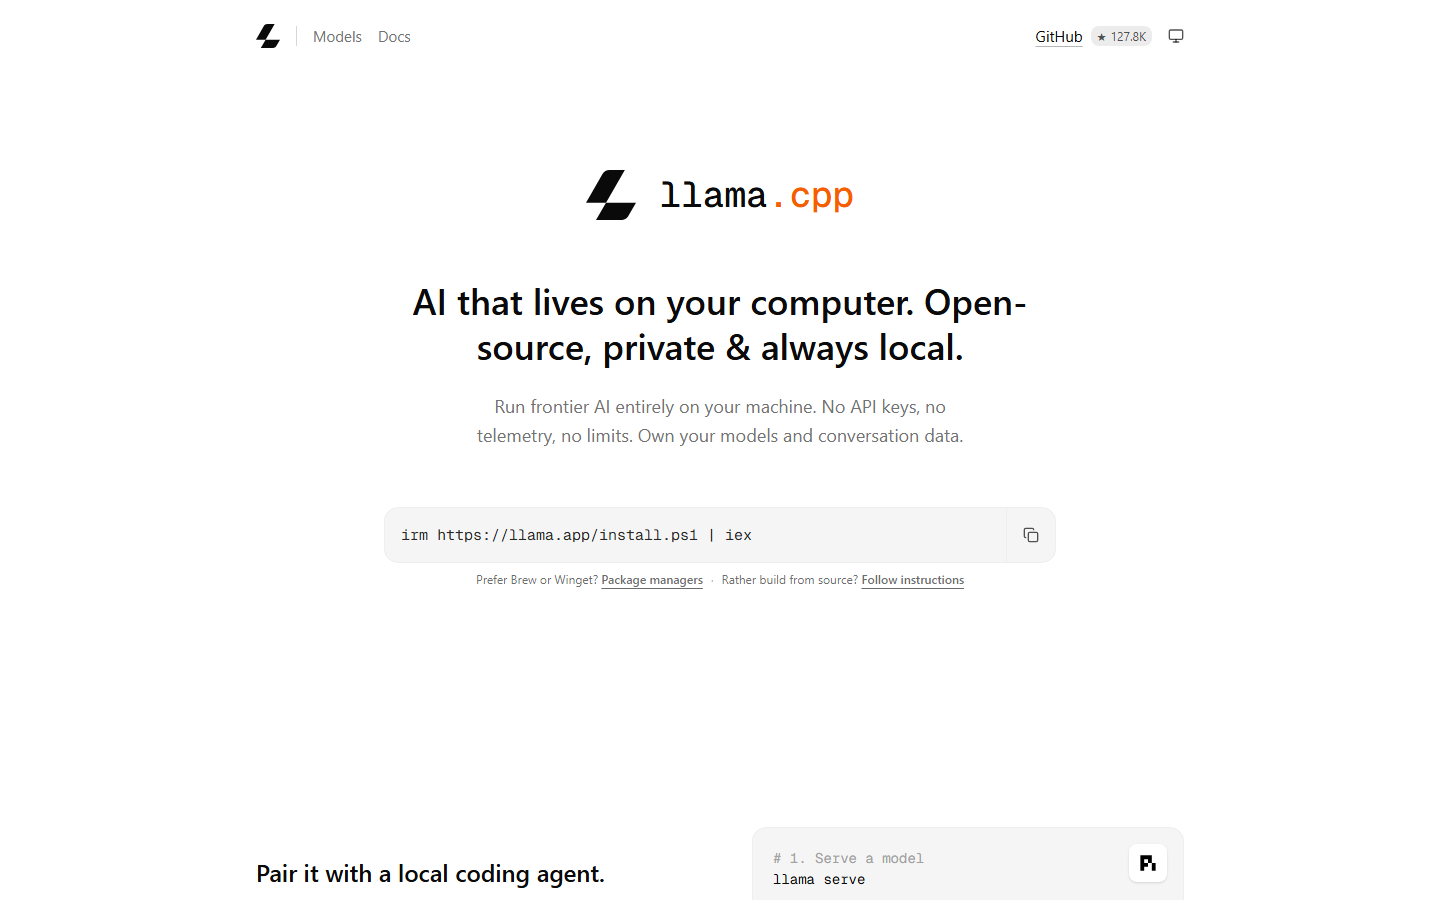
موتور متنباز (MIT) اجرای مدلهای GGUF که خیلی از برنامههای محلی رویش ساخته شدهاند؛ llama serve یک سرور سازگار با OpenAI همراه رابط وب چت، روی هر سختافزاری از لپتاپ تا سرور، راه میاندازد.
معرفی: لاما سیپیپی
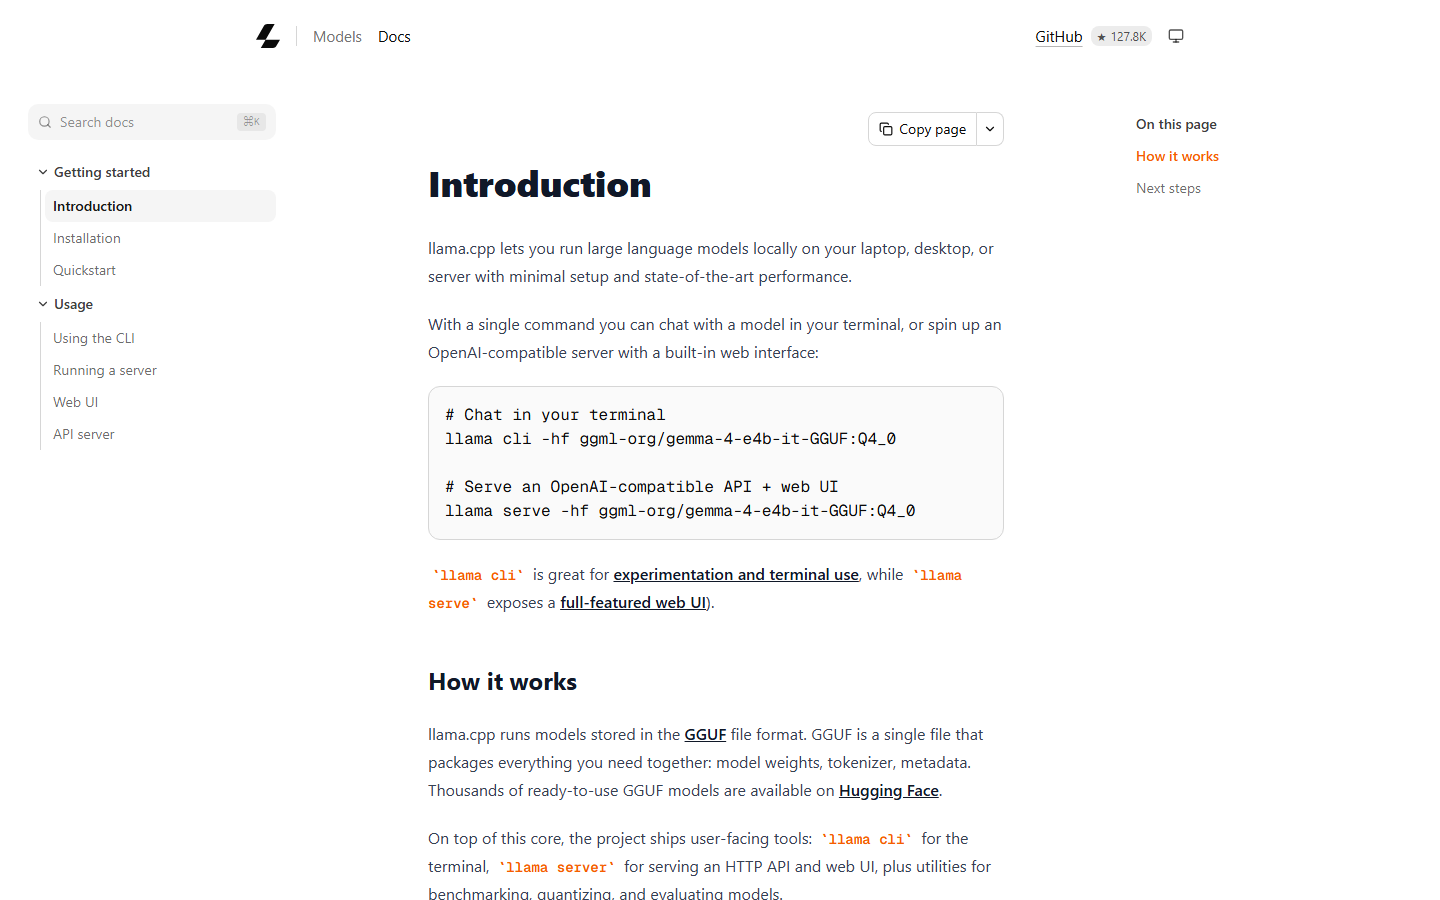
llama.cpp موتور متنباز (مجوز MIT) اجرای مدلهای زبانی به زبان C/C++ است که گئورگی گرگانف ساخت و فرمت GGUF از دل آن بیرون آمد. Jan، KoboldCpp و PocketPal روی آن ساخته شدهاند و LM Studio و Ollama هم از آن استفاده میکنند. تیم ggml.ai در فوریهٔ ۲۰۲۶ به Hugging Face پیوست، ولی پروژه با همان مجوز MIT و مدیریت فنی خود تیم ادامه دارد.
برای برنامهنویسها و مدیران سرور است: دستور llama serve یک سرور HTTP با API سازگار با OpenAI، رابط وب چت، پاسخ همزمان به چند کاربر، بردارسازی (embedding)، رتبهبندی مجدد و ورودی تصویر و صدا برای مدلهای چندوجهی میدهد. حالت router چند مدل را بهنوبت بار و خالی میکند و llama cli هم چت را در ترمینال باز میکند.
روی تقریباً هر سختافزاری کار میکند: CPUهای x86 و ARM، کارتهای انویدیا (CUDA)، AMD (HIP و Vulkan)، Intel و مکهای اپل (Metal)؛ حتی مدل بزرگتر از حافظهٔ کارت گرافیک را بین CPU و GPU تقسیم میکند. حافظه را مدل تعیین میکند؛ مثلاً طبق راهنمای رسمی Gemma 4 E4B با کوانتیزیشن ۴ بیتی و زمینهٔ ۱۶ هزار توکنی حدود ۶ گیگابایت حافظه میگیرد.
شروع: سادهترین راه دانلود فایل zip آماده از بخش Releases گیتهاب است (نسخهٔ CPU، CUDA یا Vulkan). بعد llama-server -m model.gguf را بزنید و http://127.0.0.1:8080 را در مرورگر باز کنید. روی ویندوز winget install llama.cpp و روی مک brew install llama.cpp هم هست.
نکته: خود llama.cpp برنامهٔ گرافیکی ندارد و کار با خط فرمان است؛ برای مبتدیها LM Studio یا Jan راحتترند. تیم llama.cpp و Hugging Face برنامههای دسکتاپ Llama را جدا منتشر میکنند: Llama برای مک (نسخهٔ 0.43.0، ۲ اکتبر ۲۰۲۶) و Llama برای ویندوز (v0.11.0، ۲۴ اوت ۲۰۲۶). برنامهٔ مک و صفحهٔ llama.app، API را روی localhost:9931 میدهند، ولی خود llama-server هنوز بهطور پیشفرض روی پورت ۸۰۸۰ کار میکند. نصب یکخطی سایت llama.app و گزینهٔ -hf فایلها را از Hugging Face میگیرند؛ میتوانید فایل GGUF را جدا دانلود کنید و با -m بدهید.
نسخهٔ 0.6.0 (۵ اکتبر ۲۰۲۶): رابط وب از نو ساخته شده و حالا میشود مدل را از داخل همان صفحه از Hugging Face پیدا و دانلود کرد؛ برنامه پیش از دانلود تخمین میزند مدل در حافظهٔ سیستم شما جا میشود یا نه. Qwen3.8-Flash-Next (مدل ۱۲۵ میلیاردی Qwen که هر بار فقط ۶ میلیارد پارامترش کار میکند) که از نسخهٔ 0.4.0 پشتیبانی اولیه داشت، حالا پشتیبانی کامل گرفته و با پیشبینی چندتوکنی (MTP) تا حدود ۱٫۵ برابر سریعتر مینویسد؛ ولی حتی کوچکترین نسخهاش حدود ۷۵ گیگابایت حافظه میخواهد. GLM-5.3-Flash هم اضافه شده و برنامهنویسها مسیر /v1/systemone را برای مدلهای تصمیمگیر دارند.
بهترین کاربردها
- •مدل GGUF رو بدون نصب برنامه و بدون اینترنت روی لپتاپ اجرا کنم
- •روی سرور لینوکس شرکت یه API سازگار با OpenAI برای مدل محلی راه بندازم
- •روی کامپیوتر بدون کارت گرافیک یه مدل زبانی کوچک اجرا کنم
- •برای جستجوی معنایی اسناد فارسی یه سرور embedding محلی داشته باشم
- •یه رابط وب ساده برای چت با مدل محلی داشته باشم
- •مدلهای تازه مثل Qwen3.8 رو با آخرین نسخهٔ موتور امتحان کنم
- •مدلی بزرگتر از حافظهٔ کارت گرافیکم رو با تقسیم بین CPU و GPU اجرا کنم
برای این کارها سراغش نروید
- –کسی که برنامهٔ نصبی با رابط گرافیکی و بدون خط فرمان میخواهد
- –ساخت تصویر یا ویدئو
- –اجرا روی گوشی بدون دانش فنی
اجرا روی سیستم خودتان
این برنامه را روی سیستم خودتان نصب میکنید و هوش مصنوعی روی همان دستگاه اجرا میشود؛ متن و فایلهایتان از آن بیرون نمیرود.
- کاملاً آفلاین
- متنباز
- MIT — استفادهٔ تجاری آزاد
- خط فرمان
- رابط وب
- API
حساب کاربری، تلهمتری و سرویس ابری ندارد. اگر فایل zip برنامه و فایل GGUF را با فلش بیاورید، از همان ابتدا کاملاً آفلاین کار میکند. فقط گزینهٔ -hf و اسکریپت نصب یکخطی اینترنت میخواهند.
استفادهٔ تجاری، تغییر و بازنشر آزاد است؛ متن مجوز را همراه برنامه نگه دارید. مجوز هر مدل جداست.
سختافزار لازم
- حداقل رم: ۴ گیگابایت — پیشنهادی: ۱۶ گیگابایت
- کارت گرافیک اختیاری است
- حداقل رسمی ندارد و روی CPU معمولی هم اجرا میشود. عدد حداقل برآورد برای Qwen3.5 0.8B است (حدود ۱ گیگ × ۱٫۲ + ۲ گیگ سیستمعامل). برای مدلهای ۸ تا ۹ میلیاردی ۱۶ گیگ رم یا کارت گرافیک ۸ گیگ مناسب است (برآورد). پشتیبانی از CUDA، Vulkan، HIP، SYCL، Metal و CPUهای x86 و ARM.
نصب و اجرا
- ۱
فایل zip را از گیتهاب بگیرید
https://github.com/ggml-org/llama.cpp/releasesویندوز: بستههای cpu، cuda یا vulkan؛ لینوکس: ubuntu-x64 یا ubuntu-vulkan؛ مک: macos-arm64. فقط از حالت فشرده خارج کنید.
- ۲
یا با مدیر بسته نصب کنیدویندوز
winget install llama.cppروی مک و لینوکس: brew install llama.cpp
- ۳
سرور و رابط وب را با فایل GGUF اجرا کنید
llama-server -m Qwen3.5-9B-Q4_K_M.gguf -c 16384بعد http://127.0.0.1:8080 را در مرورگر باز کنید. در نسخههای جدید llama serve -m هم همین کار را میکند.
- ۴
دانلود مستقیم مدل
llama serve -hf ggml-org/gemma-4-e4b-it-GGUF:Q4_0مدل را از Hugging Face دانلود و در کش ذخیره میکند.
- ۵
برای شبکهٔ داخلی کلید بگذاریدلینوکس
llama-server -m model.gguf --host 0.0.0.0 --port 8080 --api-key YOUR_KEY -np 4بدون --api-key سرور را روی شبکه باز نکنید؛ -np تعداد درخواستهای همزمان است.
دانلود
- GitHub Releases (v0.6.0 و نسخههای شبانه) ↗رسمی
فایلهای آماده برای ویندوز، لینوکس، مک و اندروید
- llama.app ↗رسمی
خانهٔ رسمی پروژه، مستندات و نصب یکخطی (دانلود از Hugging Face)
- Docker: ghcr.io/ggml-org/llama.cpp ↗رسمی
ایمیج رسمی روی GHCR، نه Docker Hub
- Llama for macOS (GitHub Releases) ↗رسمی
برنامهٔ دسکتاپ رسمی برای مک؛ نسخهٔ 0.43.0 (۲ اکتبر ۲۰۲۶)، API روی localhost:9931.
- Llama for Windows (GitHub Releases) ↗رسمی
برنامهٔ دسکتاپ رسمی برای ویندوز؛ نسخهٔ v0.11.0 (۲۴ اوت ۲۰۲۶).
نکات امنیتی
- سرور بهطور پیشفرض روی 127.0.0.1:8080 است؛ اگر --host 0.0.0.0 میگذارید، حتماً --api-key بدهید و پورت را روی اینترنت باز نکنید.
- فایل zip را فقط از گیتهاب رسمی ggml-org بگیرید.
- فایل GGUF را از منبع معتبر (مثل ggml-org یا سازندهٔ مدل) بگیرید و آن را به فایلهای pickle ترجیح دهید.
- برنامهٔ Llama برای مک دسترسی از شبکهٔ محلی یا Tailscale دارد که بهطور پیشفرض خاموش است؛ فقط در شبکهٔ مطمئن روشنش کنید.
برای شرکتها و سازمانها
برای سرور شرکت مناسب است: llama-server درخواستهای همزمان را با continuous batching جواب میدهد، کش پرامپت دارد، با حالت router چند مدل را بار و خالی میکند و embedding و rerank هم سرو میکند. فقط یک کلید API ساده دارد؛ مدیریت کاربر و گزارش مصرف را با Open WebUI یا پروکسی جلوی آن اضافه کنید.
مدلهایی که با این برنامه اجرا میشوند
 کوئن ۳.۵ (آفلاین)
 جما ۴ (آفلاین)
 کوئن ۳ کدر (آفلاین)
 کوئن ۳ ویال (آفلاین)
 کوئن ۳.۸ 27B (آفلاین)
 دیپسیک ۴ فلش (آفلاین)
 میمو ۲.۶ (آفلاین)
 اورنیث ۱.۵ (آفلاین)
 جیپیتی اواساس (آفلاین)
 میوز گلیمر (آفلاین)
 جیالام اوسیآر (آفلاین)
 میسترال اسمال ۴ (آفلاین)
آخرین بررسی: ۱۷ مهر ۱۴۰۵
تصاویر محیط ابزار
نقاط قوت
- ✓کاملاً متنباز (MIT)، سبک و بدون وابستگی؛ روی CPU، انویدیا، AMD، Intel و مک اجرا میشود
- ✓تیم پروژه نسخهٔ GGUF مدلهای مهم مثل Qwen3.8 و Gemma 4 را خودش منتشر میکند
- ✓سرور سازگار با OpenAI با رابط وب، کلید API، چند کاربر همزمان و حالت router برای چند مدل
- ✓بردارسازی، رتبهبندی مجدد و ورودی تصویر و صدا برای مدلهای چندوجهی
- ✓فایل zip آماده در گیتهاب (نسخهٔ CPU ویندوز حدود ۱۹ مگابایت)؛ بدون نصب و بدون اینترنت بعد از دانلود
- ✓از آوریل ۲۰۲۶ رابط وب متن راستبهچپ مثل فارسی را درست نمایش میدهد
نقاط ضعف
- ✗کار با خط فرمان است و انتخاب نسخهٔ درست (CPU، CUDA یا Vulkan) و کوانتیزیشن برای مبتدی سخت است؛ مثلاً Qwen3.5 9B در Q4 حدود ۵٫۶ گیگ فایل است و حدود ۷ گیگ حافظهٔ گرافیک یا ۹ گیگ رم میخواهد (برآورد)
- ✗خود موتور برنامهٔ گرافیکی ندارد (برنامههای دسکتاپ Llama برای مک و ویندوز جدا منتشر میشوند) و رابط وب llama-server فقط وقتی سرور روشن است در دسترس است
- ✗نسخههای شبانه هر روز چند بار منتشر میشوند؛ برای سرور کاری بهتر است نسخهٔ پایدار (مثل 0.6.0) را بگیرید
- ✗مدیریت کاربر و پنل مدیریتی ندارد؛ فقط یک کلید API ساده
پرسشهای پرتکرار
llama.cpp با Ollama و LM Studio چه فرقی دارد؟
llama.cpp خود موتور است؛ Ollama و LM Studio برنامههای راحتتریاند که از آن هم استفاده میکنند. با llama.cpp همیشه آخرین نسخهٔ موتور و کنترل کامل تنظیمات را دارید، ولی کار با خط فرمان است.
چه سختافزاری لازم است؟
هر لپتاپ یا سروری با ویندوز، لینوکس یا مک. کارت گرافیک اجباری نیست؛ اگر دارید، نسخهٔ CUDA (انویدیا) یا Vulkan (بیشتر کارتها) را بگیرید. برای Qwen3.5 9B با کوانتیزیشن Q4 حدود ۷ گیگ حافظهٔ گرافیک یا ۹ گیگ رم کافی است (برآورد).
رابط فارسی و راستبهچپ دارد؟
رابط وب فارسی ندارد، اما از آوریل ۲۰۲۶ جهت متن را خودکار تشخیص میدهد و پاسخ فارسی را راستبهچپ نشان میدهد. کیفیت فارسی به مدل بستگی دارد؛ Qwen3.5 فارسی را رسماً پشتیبانی میکند.
برای سرور شرکت مناسب است؟
بله. llama-server چند درخواست را همزمان جواب میدهد، کلید API (--api-key) میگیرد و با حالت router چند مدل را مدیریت میکند. مدیریت کاربر ندارد؛ برای چند کاربر آن را پشت Open WebUI یا پروکسی با احراز هویت بگذارید.
استفادهٔ تجاری آزاد است؟
بله، مجوز MIT هر نوع استفاده، تغییر و بازنشر را آزاد میگذارد. مجوز خود مدل را جدا بررسی کنید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
اولاما
Ollama
ابزار متنباز و رایگان برای اجرای مدلهای باز مثل Qwen3.5 و Gemma 4 روی ویندوز، مک و لینوکس: با یک دستور مدل را میگیرد و اجرا میکند، برنامهٔ چت دارد و API محلی روی پورت ۱۱۴۳۴ میدهد.
ویالالام
vLLM
موتور سرویسدهی سریع مدلهای زبانی روی سرور لینوکس با کارت گرافیک؛ یک API سازگار با OpenAI میسازد تا چندین کاربر و برنامه همزمان از مدل محلی استفاده کنند. رایگان و متنباز (Apache-2.0).
لوکالایآی
LocalAI
جایگزین خودمیزبان API اوپنایآی: متن، تصویر، گفتار و بردارسازی را با یک API روی سرور یا کامپیوتر خودتان اجرا میکند، حتی بدون کارت گرافیک. رایگان و متنباز (MIT).