رگفلو (پرسش و پاسخ از اسناد)
RAGFlowسرور متنباز (Apache-2.0) برای ساخت سامانهٔ پرسش و پاسخ از اسناد شرکت روی سرور خودتان: PDF، Word، اسلاید، اکسل و اسکن را با تحلیل چیدمان، OCR و جدول میخواند و جواب را با ارجاع به منبع میدهد؛ با مدلهای Ollama کاملاً بدون اینترنت کار میکند.
معرفی: رگفلو (پرسش و پاسخ از اسناد)
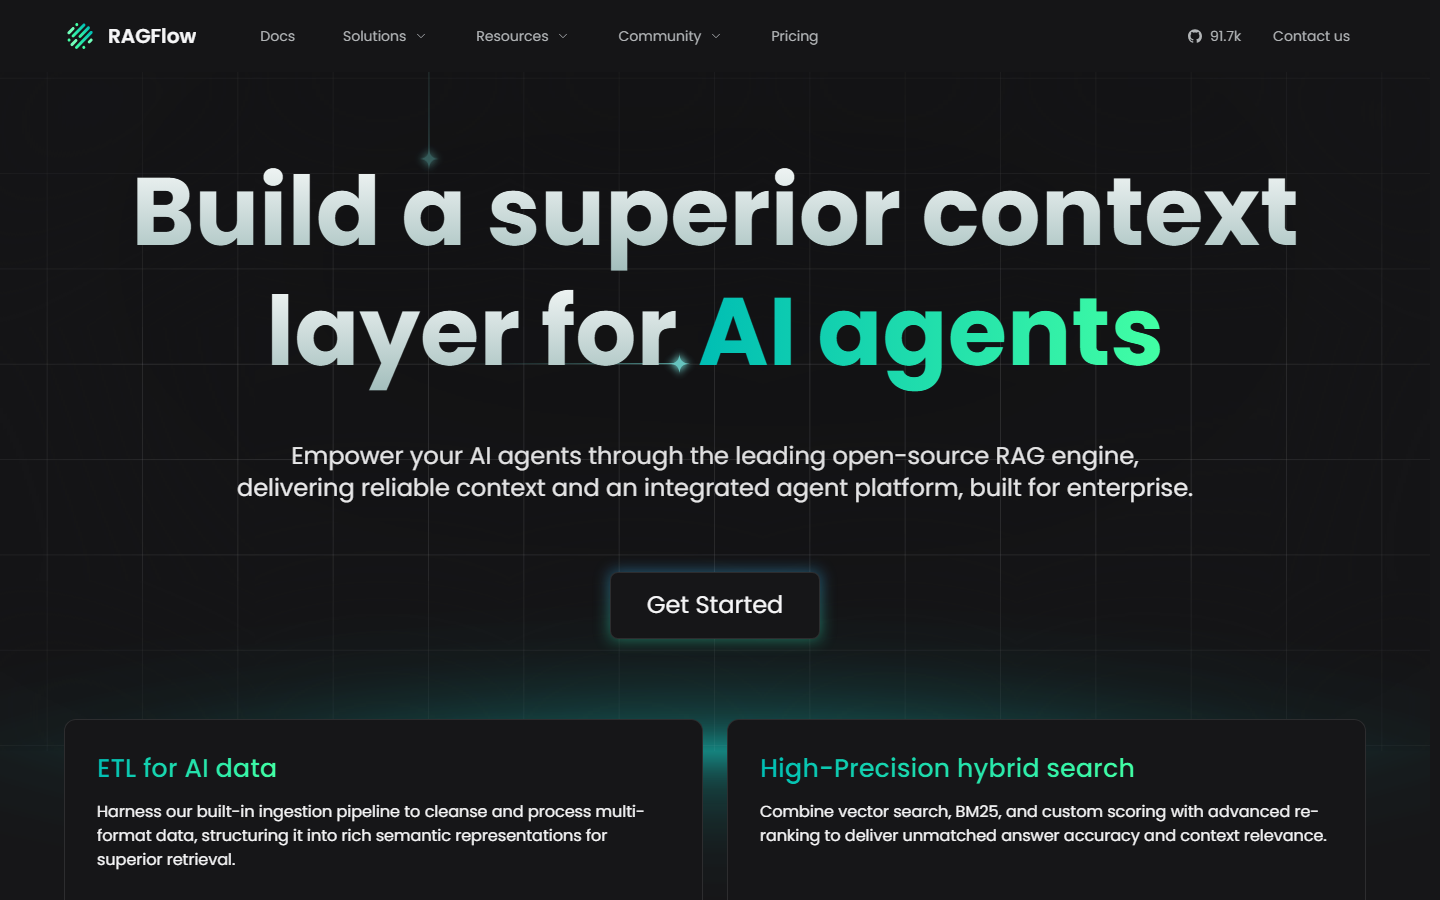
RAGFlow موتوری برای بازیابی و تولید (RAG) است که روی سرور خود سازمان نصب میشود. اسناد را بارگذاری میکنید، برنامه با بخش DeepDoc چیدمان صفحه، جدولها و متن اسکنشده (OCR) را میخواند و تکهتکه میکند، و بعد کارمندان از طریق رابط وب یا API سؤال میپرسند و جواب را با ارجاع به همان بخش سند میگیرند. Word، اسلاید، اکسل، PDF، تصویر و اسکن، دادههای ساختیافته و صفحههای وب را میپذیرد و جریانکار عاملها هم دارد. سازندهاش InfiniFlow است و پروژه در گیتهاب نزدیک ۹۲ هزار ستاره دارد.
مدل زبانی، مدل بردارسازی و مدل رتبهبندی را خودتان انتخاب میکنید: میتواند به Ollama و موتورهای محلی دیگر وصل شود و کاملاً آفلاین کار کند، یا به API سرویسهای ابری. این مدلها را بعد از ورود، در صفحهٔ ارائهدهندهٔ مدل اضافه میکنید.
نصب با Docker Compose است (Docker 24.0.0 و Compose 2.26.1 به بعد). پیکربندی پیشنهادی شروع ۴ هستهٔ پردازنده، ۱۶ گیگابایت رم و ۵۰ گیگابایت دیسک است و خود RAGFlow کارت گرافیک نمیخواهد؛ اما مدل زبانی محلی سختافزار جدا لازم دارد. ایمیجهای Docker نسخهٔ 0.27.2 فقط برای x86 ساخته شدهاند و روی ARM64 باید ایمیج را خودتان بسازید.
نسخهٔ پایدار v0.27.2 است (۱۰ سپتامبر ۲۰۲۶). v1.0.0-rc1 (۲۹ سپتامبر ۲۰۲۶) پیشنمایش یک بازنویسی کامل با زبان Go است که سبکتر است و از NATS و Kvrocks استفاده میکند؛ اما ارتقا از 0.27.2 به آن برگشتناپذیر است و جعبهٔ شنی (sandbox) محلی در آن حذف شده. برای سرور واقعی فعلاً روی 0.27.2 بمانید.
رابط فارسی ندارد (عربی، آذری و ازبکی دارد) و کیفیت کار با اسناد فارسی به مدل بردارسازی و OCR بستگی دارد و آزموده نشده است. پیش از راهاندازی، رمزهای پیشفرض فایل docker/.env را عوض کنید.
بهترین کاربردها
- •روی سرور شرکت از اسناد داخلی بدون اینترنت سؤال بپرسیم
- •سامانهٔ پرسش و پاسخ از PDF و اسکنهای سازمان را روی سرور خودمان راه بیندازم
- •چتبات داخلی شرکت با ارجاع به منبع را روی سرور خودمان بسازم
- •اسناد اسکنشده و جدولدار را روی سرور شرکت با OCR جستوجوپذیر کنم
- •جایگزین آفلاین NotebookLM برای تیم روی سرور داخلی نصب کنم
- •با مدلهای Ollama روی سرور خودم RAG برای پشتیبانی مشتری بسازم
برای این کارها سراغش نروید
- –چت شخصی با PDF روی لپتاپ (AnythingLLM سادهتر است)
- –اجرای خود مدل زبانی
- –فقط تبدیل اسکن به متن قابل ویرایش
- –ساخت تصویر یا ویدیو
اجرا روی سیستم خودتان
این برنامه را روی سیستم خودتان نصب میکنید و هوش مصنوعی روی همان دستگاه اجرا میشود؛ متن و فایلهایتان از آن بیرون نمیرود.
- بعد از نصب، بدون اینترنت
- متنباز
- Apache-2.0 — استفادهٔ تجاری آزاد
- رابط وب
- API
- خط فرمان
بعد از دریافت ایمیجهای Docker و مدلها، با مدل زبانی و مدل بردارسازی محلی (مثلاً از طریق Ollama) کاملاً بدون اینترنت کار میکند. اگر در صفحهٔ ارائهدهندهٔ مدل یک API ابری بگذارید، تکههای اسناد و سؤالها برای آن سرویس فرستاده میشوند.
آزاد برای استفادهٔ تجاری، تغییر و توزیع. مجوز هر مدل زبانی یا بردارسازی که کنارش اجرا میکنید جداست.
سختافزار لازم
- حداقل رم: ۱۶ گیگابایت
- کارت گرافیک اختیاری است
- پیکربندی پیشنهادی شروع: ۴ هستهٔ پردازنده، ۱۶ گیگابایت رم و ۵۰ گیگابایت دیسک؛ نیاز واقعی به حجم اسناد، موتور اسناد، پردازشها و تعداد کاربران همزمان بستگی دارد. خود RAGFlow کارت گرافیک نمیخواهد (در 0.27.2 میشود DeepDoc را با DEVICE=gpu روی کارت برد و در 1.0 فقط CPU است). مدل زبانی محلی سختافزار جدا میخواهد. ایمیجهای 0.27.2 فقط x86 هستند.
نصب و اجرا
- ۱
Docker و تنظیم حافظهٔ مجازی را آماده کنیدلینوکس
sysctl vm.max_map_count sudo sysctl -w vm.max_map_count=262144Docker 24.0.0 و Compose 2.26.1 به بالا لازم است. vm.max_map_count باید دستکم 262144 باشد؛ برای ماندگاری بعد از راهاندازی دوباره، vm.max_map_count=262144 را در /etc/sysctl.conf بنویسید.
- ۲
کد را بگیرید و نسخهٔ پایدار را انتخاب کنید
git clone https://github.com/infiniflow/ragflow.git cd ragflow/docker git checkout v0.27.2v0.27.2 نسخهٔ پایدار است. شاخهٔ اصلی و v1.0.0-rc1 پیشنمایشاند و ارتقا به آنها برگشتناپذیر است.
- ۳
رمزهای پیشفرض را عوض کنید
در فایل docker/.env رمزهایی مثل ELASTIC_PASSWORD و MYSQL_PASSWORD مقدار پیشفرض دارند (مثلاً infini_rag_flow). پیش از هر نصبی غیر از آزمایش روی سیستم خودتان همه را عوض کنید. پورت وب (۸۰) را در docker-compose.yml تغییر میدهید.
- ۴
سرور را بالا بیاورید
docker compose -f docker-compose.yml up -d docker logs -f docker-ragflow-cpu-1اجرای اول ایمیجها را دانلود میکند. وقتی در لاگ Running on all addresses را دیدید، آماده است. برای بردن DeepDoc روی کارت گرافیک، پیش از اجرا خط DEVICE=gpu را به اول فایل .env اضافه کنید.
- ۵
مدلهای محلی را با Ollama آماده کنید
ollama pull qwen3.5:9b ollama pull bge-m3یک مدل زبانی و یک مدل بردارسازی چندزبانه بگیرید. Ollama میتواند روی همین سرور یا سرور دیگری باشد؛ در RAGFlow نشانی سرویس آن را وارد میکنید.
- ۶
وارد شوید و مدلها را اضافه کنید
در مرورگر نشانی IP سرور را بدون شماره پورت باز کنید (http://IP_OF_YOUR_MACHINE) و وارد شوید. در صفحهٔ ارائهدهندهٔ مدل، Ollama را با نام مدل و نشانی سرویس اضافه کنید؛ بعد یک پایگاه دانش بسازید و اسناد را بارگذاری کنید.
دانلود
- GitHub: infiniflow/ragflow ↗رسمی
v0.27.2 پایدار و v1.0.0-rc1 پیشنمایش
- Docker Hub: infiniflow/ragflow ↗رسمی
- مستندات رسمی ↗رسمی
نصب، تنظیمات و راهنمای کاربر
- Ollama ↗رسمی
برای اجرای مدل زبانی و بردارسازی محلی
نکات امنیتی
- رابط وب بهطور پیشفرض روی پورت ۸۰ و روی همهٔ کارتهای شبکه باز است؛ سرور را پشت فایروال یا پراکسی معکوس با HTTPS بگذارید و مستقیم روی اینترنت باز نکنید.
- فایل docker/.env رمزهای پیشفرض دارد (مثل ELASTIC_PASSWORD=infini_rag_flow) و خود فایل هشدار میدهد که پیش از هر استقرار غیرمحلی باید عوض شوند.
- ارتقا از 0.27.2 به v1.0.0-rc1 برگشتناپذیر است و جعبهٔ شنی محلی در آن حذف شده؛ پیش از آزمایش از دادهها نسخهٔ پشتیبان بگیرید یا روی سرور جدا امتحان کنید.
- اگر برای مدلها API ابری بگذارید، تکههای اسناد و سؤالها به آن سرویس فرستاده میشوند؛ برای اسناد محرمانه فقط مدل محلی بگذارید.
برای شرکتها و سازمانها
برای سازمان ساخته شده: یک سرور با Docker، رابط وب برای کارمندان و API برای اتصال به سامانههای داخلی. با مدل زبانی و بردارسازی محلی (مثلاً Ollama روی سرور جدا)، اسناد از شبکهٔ سازمان بیرون نمیروند. جایگزینهای سادهتر AnythingLLM و Open WebUI هستند و برای ساخت جریانکار و چتبات، Dify.
مدلهایی که با این برنامه اجرا میشوند
 کوئن ۳ امبدینگ (آفلاین)
 بیجیای ام۳ (آفلاین)
همسطح ابری
آخرین بررسی: ۱۲ مهر ۱۴۰۵
تصاویر محیط ابزار
نقاط قوت
- ✓خواندن عمیق اسناد: چیدمان صفحه، جدول و OCR برای PDF، اسکن، Word، اسلاید و اکسل
- ✓جواب با ارجاع قابلردیابی به منبع و نمایش تکههای سند برای اصلاح دستی
- ✓با مدلهای محلی (مثل Ollama) کاملاً آفلاین روی سرور سازمان
- ✓رابط وب، API HTTP، کیت Python و خط فرمان برای اتصال به سامانههای دیگر
- ✓عاملها و جریانکار آماده
- ✓Apache-2.0، آزاد برای کار تجاری، با بیش از ۹۱ هزار ستاره در گیتهاب
نقاط ضعف
- ✗سرور است، نه برنامهٔ دسکتاپ: Docker، دستکم ۴ هسته، ۱۶ گیگابایت رم و ۵۰ گیگابایت دیسک، بهعلاوهٔ سختافزار جدا برای مدل زبانی محلی؛ ایمیجهای 0.27.2 فقط x86 هستند
- ✗رابط فارسی ندارد و کیفیت اسناد فارسی آزموده نشده است
- ✗رمزهای پیشفرض و باز بودن پورت ۸۰ روی همهٔ شبکهها پیش از هر نصب غیرمحلی باید تنظیم شود
- ✗نسخهٔ 1.0 هنوز پیشنمایش است و ارتقا به آن برگشتناپذیر است
- ✗برای یک نفر روی لپتاپ سنگین است؛ AnythingLLM سادهتر است
قیمتگذاری
خودمیزبان (رایگان)
Self-hostedرایگان
- • همهٔ امکانات روی سرور خودتان
- • رابط وب، API و کیت Python
- • متنباز (Apache-2.0)
قیمتها تقریبی و بر اساس آخرین بازبینی است؛ برای قیمت دقیق به سایت رسمی مراجعه کنید.
پرسشهای پرتکرار
چه سروری لازم دارد؟
پیکربندی پیشنهادی شروع ۴ هستهٔ پردازنده، ۱۶ گیگابایت رم و ۵۰ گیگابایت دیسک است، با Docker 24.0.0 و Compose 2.26.1 به بعد. خود RAGFlow کارت گرافیک نمیخواهد (در 0.27.2 میشود DeepDoc را با DEVICE=gpu روی کارت برد). مدل زبانی محلی سختافزار جدا میخواهد. ایمیجهای 0.27.2 فقط x86 هستند.
چطور نصبش کنم؟
مخزن را با git clone بگیرید، در پوشهٔ ragflow/docker با git checkout v0.27.2 نسخهٔ پایدار را انتخاب کنید، رمزهای docker/.env را عوض کنید و docker compose -f docker-compose.yml up -d را اجرا کنید. بعد نشانی IP سرور را بدون شماره پورت در مرورگر باز کنید، وارد شوید و در صفحهٔ ارائهدهندهٔ مدل، Ollama را اضافه کنید.
کاملاً بدون اینترنت کار میکند؟
بله، بعد از دریافت ایمیجهای Docker و مدلها، اگر مدل زبانی و مدل بردارسازی را از Ollama یا موتور محلی دیگری بدهید. اگر API ابری بگذارید، تکههای اسناد و سؤالها برای آن سرویس فرستاده میشوند.
اسناد فارسی را میفهمد؟
آزموده نشده است. رابط فارسی ندارد و کیفیت به مدل بردارسازی و OCR بستگی دارد. یک مدل بردارسازی چندزبانه مثل bge-m3 و یک مدل زبانی که فارسی بلد است (مثل Qwen3.5) بگذارید و پیش از استفادهٔ جدی با چند سند نمونهٔ خودتان امتحان کنید.
به نسخهٔ 1.0 ارتقا بدهم؟
فعلاً روی سرور واقعی نه. v1.0.0-rc1 پیشنمایش یک بازنویسی کامل با Go است، ارتقا از 0.27.2 به آن برگشتناپذیر است و جعبهٔ شنی محلی در آن حذف شده. اگر میخواهید امتحانش کنید، روی سرور جدا یا بعد از پشتیبانگیری کامل.
برای کار تجاری آزاد است؟
بله، مجوز Apache-2.0 دارد و استفاده، تغییر و توزیع تجاری آزاد است. مجوز مدلهایی را که کنارش اجرا میکنید جدا بررسی کنید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
کوئن ۳.۵ (آفلاین)
Qwen3.5 (offline)
خانوادهٔ مدل باز علیبابا که فارسی در فهرست رسمی زبانهایش است؛ از 0.8B برای لپتاپ ضعیف تا 35B-A3B برای سیستم قوی، با فهم تصویر، حافظهٔ متنی ۲۶۲ هزار توکنی و مجوز Apache 2.0.
جما ۴ (آفلاین)
Gemma 4 (offline)
خانوادهٔ مدل باز گوگل که روی لپتاپ یا کامپیوتر خودتان و بدون اینترنت اجرا میشود: چت، خلاصهنویسی، کدنویسی و فهم تصویر در پنج اندازه از E2B تا 31B، با مجوز آزاد Apache 2.0.
اوپن وبیوآی
Open WebUI
رابطی شبیه ChatGPT که روی لپتاپ یا سرور خودتان نصب میشود و به Ollama یا هر API سازگار با OpenAI وصل میشود؛ با گفتوگو با اسناد، مدیریت کاربران، LDAP و ورود یکپارچه (SSO).