بیجیای ام۳ (آفلاین)
BGE-M3 (offline)مدل بردارساز سبک و پرکاربرد BAAI با ۵۶۸ میلیون پارامتر برای جستوجوی معنایی و «از اسنادت بپرس» خصوصی؛ در سنجههای فارسی نتیجهٔ خوبی دارد، بدون کارت گرافیک اجرا میشود و مجوز MIT دارد.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- MIT — استفادهٔ تجاری آزاد
- فارسی: خوب
- API
فقط دانلود اول اینترنت میخواهد؛ بردارسازی و جستوجو کاملاً روی دستگاه خودتان انجام میشود.
استفادهٔ تجاری، تغییر و بازتوزیع آزاد است؛ فقط متن مجوز MIT و نام صاحب حق را همراه نسخه نگه دارید.
نسخهها و سختافزار لازم
- 568M۵۶۸Mطول متن ۸ هزار توکن
- حافظهٔ لازم:
- کارت گرافیک ۲ گیگ یا رم ۴ گیگ
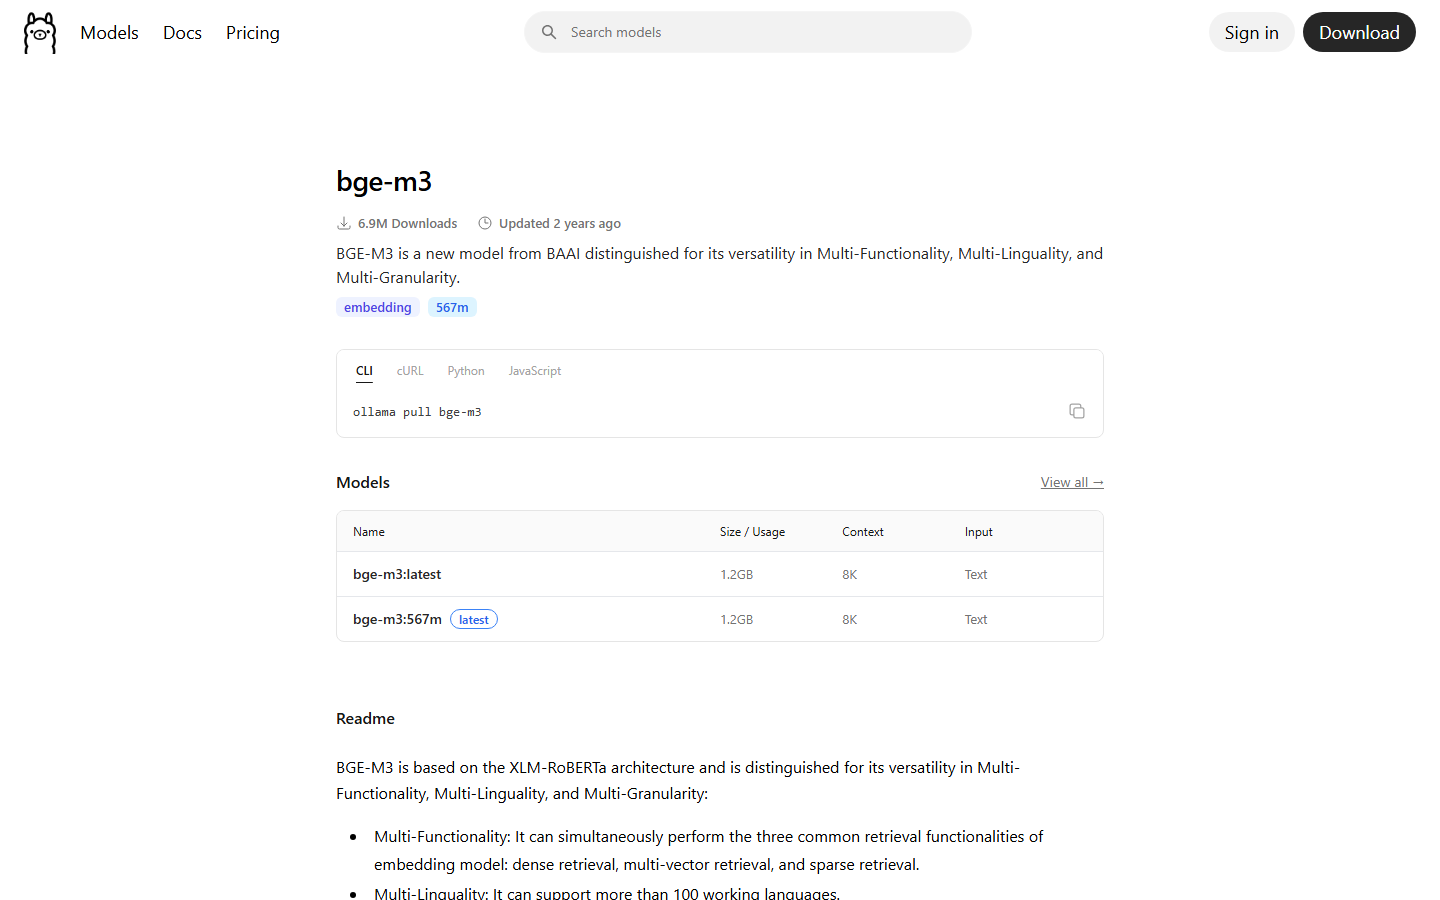
ollama run bge-m3نسخهٔ Ollama با دقت fp16 حدود ۱٫۲ گیگابایت است؛ فایل اصلی هاگینگفیس (fp32) حدود ۲٫۳ گیگابایت. بردار ۱۰۲۴ بعدی. روی هر لپتاپی، بدون کارت گرافیک، اجرا میشود. حداقل حافظه برآوردی است.
نصب و اجرا
- ۱
Ollama را نصب کنیدلینوکس
curl -fsSL https://ollama.com/install.sh | shدر ویندوز و مک، برنامهٔ نصب را از ollama.com/download بگیرید.
- ۲
مدل را بگیرید
ollama pull bge-m3حدود ۱٫۲ گیگابایت.
- ۳
آزمایش کنید که بردار برمیگرداند
curl http://localhost:11434/api/embed -d '{"model": "bge-m3", "input": "What is the capital of Iran?"}'خروجی یک بردار ۱۰۲۴ عددی است. در Open WebUI همین مدل را بهعنوان موتور بردارسازی انتخاب کنید.
- ۴
برای جستوجوی ترکیبی، FlagEmbedding را نصب کنید
pip install -U FlagEmbeddingOllama فقط بردار معنایی میدهد؛ وزن کلمهها و بردارهای چندگانه با این کتابخانهٔ رسمی BAAI به دست میآیند.
دانلود
- Ollama ↗رسمی
نسخهٔ fp16، حدود ۱٫۲ گیگابایت.
- Hugging Face (مخزن رسمی BAAI) ↗رسمی
وزن اصلی (pytorch_model.bin، حدود ۲٫۳ گیگابایت) و نسخهٔ ONNX.
- GitHub — FlagEmbedding ↗رسمی
کتابخانهٔ رسمی BAAI برای هر سه حالت خروجی.
- Hugging Face — bge-reranker-v2-m3 ↗رسمی
مدل بازرتبهبندی چندزبانهٔ همخانواده برای دقت بیشتر در RAG.
نکات امنیتی
- فایل اصلی مدل در هاگینگفیس به قالب pytorch_model.bin (pickle) است که میتواند کد اجرایی داشته باشد؛ فقط از مخزن رسمی BAAI بگیرید یا نسخهٔ Ollama را به کار ببرید.
- پایگاه برداری را مثل خود اسناد محافظت کنید؛ از روی بردارها میشود بخشی از متن اصلی را بازسازی کرد.
- در سیستم RAG سطح دسترسی را رعایت کنید: کسی که به سندی دسترسی ندارد، نباید از راه جستوجو به محتوای آن برسد.
- پورت ۱۱۴۳۴ Ollama را به اینترنت باز نکنید؛ Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و بهتر است همینطور بماند.
برای شرکتها و سازمانها
برای جستوجوی اسناد شرکت، سبکترین گزینهٔ جدی است: روی سرور بدون کارت گرافیک هم کار میکند و مجوز MIT دارد. برای دقت بیشتر، bge-reranker-v2-m3 را کنارش بگذارید تا نتایج را دوباره مرتب کند. اگر بعداً به مدل دیگری کوچ کنید، همهٔ اسناد باید دوباره بردارسازی شوند.
برنامههایی که این مدل را اجرا میکنند
 الام استودیو
 اوپن وبیوآی
 دیفای
 انیتینگالالام
 لاما سیپیپی
 ویالالام
 رگفلو (پرسش و پاسخ از اسناد)
 لوکالایآی
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۵ دی ۱۴۰۲
معرفی: بیجیای ام۳ (آفلاین)
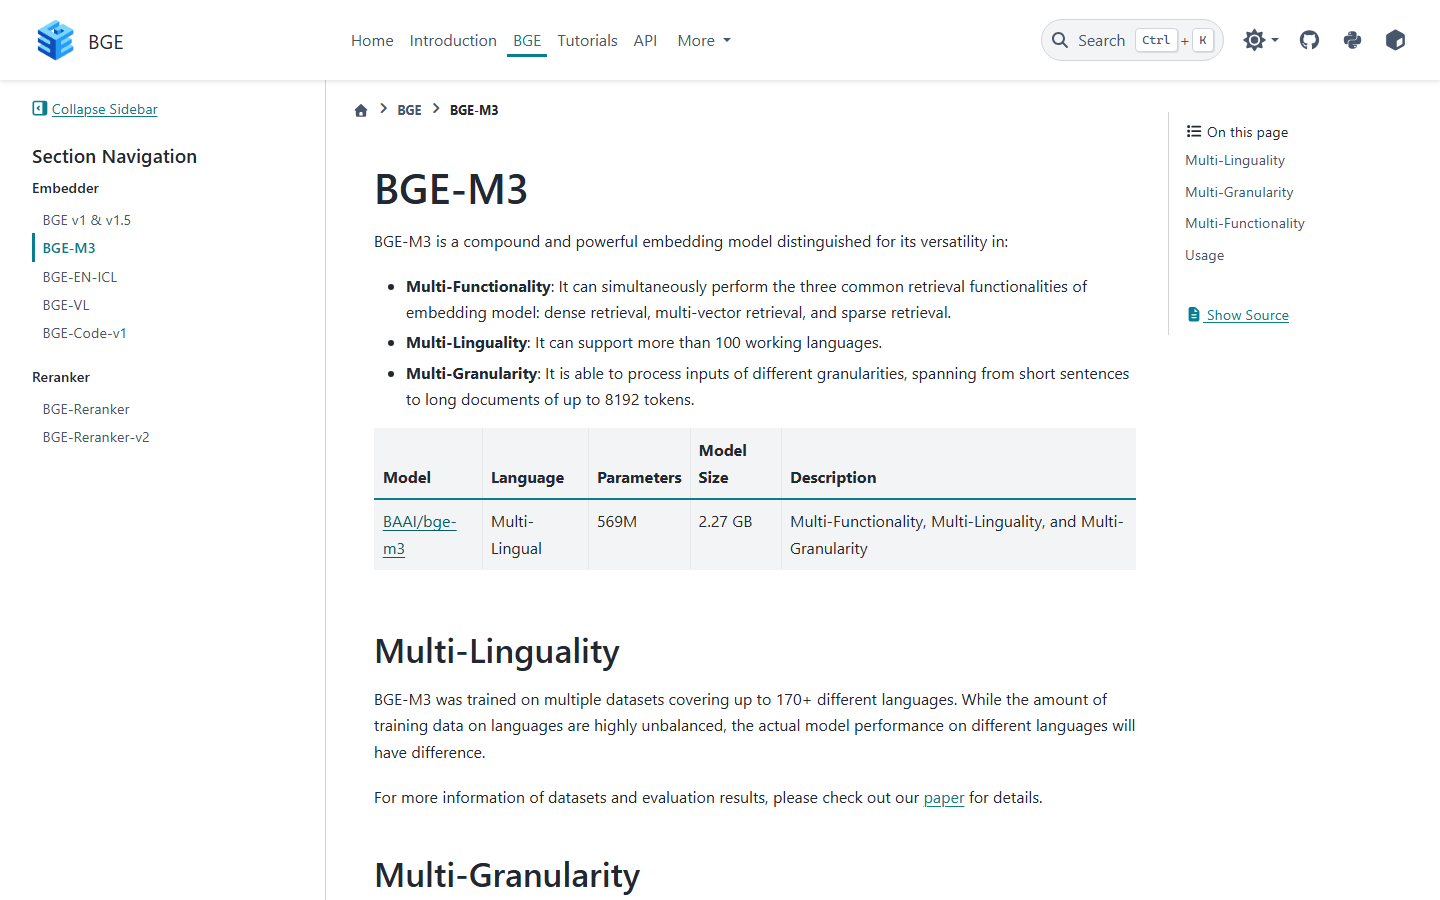
BGE-M3 مدل بردارساز (embedding) آکادمی هوش مصنوعی پکن (BAAI) است که ۳۰ ژانویهٔ ۲۰۲۴ منتشر شد. متن را به بردار عددی تبدیل میکند تا متنهای هممعنی کنار هم قرار بگیرند. بیش از ۱۰۰ زبان را پشتیبانی میکند و متن تا ۸۱۹۲ توکن را یکجا میگیرد.
ویژگی خاصش این است که سه نوع خروجی را با هم میدهد: بردار معنایی، وزن کلمهها (شبیه جستوجوی کلمهای کلاسیک) و بردارهای چندگانه. برای همین برای جستوجوی ترکیبی مناسب است. کاربرد اصلیاش ساختن سیستم «از اسنادت بپرس» خصوصی (RAG) و جستوجوی معنایی در اسناد است: اسناد بردارسازی میشوند، مرتبطترین تکهها پیدا و به یک مدل چت آفلاین داده میشوند تا جواب بنویسد.
در فارسی شواهد خوبی دارد: در مقالهٔ BAAI امتیاز بازیابی فارسی آن در MIRACL بین ۶۰٫۹ و ۶۳٫۴ است و در سنجهٔ فارسی FaMTEB بین ۱۵ مدل دوم شد. سختافزار زیادی نمیخواهد: نسخهٔ Ollama حدود ۱٫۲ گیگابایت است و روی لپتاپ بدون کارت گرافیک اجرا میشود.
برای شروع، ollama pull bge-m3 را بزنید و در Open WebUI موتور بردارسازی را روی Ollama بگذارید و bge-m3 را انتخاب کنید. برای حالت کلمهای و چندبرداری، کتابخانهٔ پایتونی FlagEmbedding را نصب کنید.
محدودیتها: مدل سال ۲۰۲۴ است و مدلهای بزرگتر جدید (مثل Qwen3-Embedding-8B) در بازیابی فارسی کمی دقیقترند؛ Ollama هم فقط بردار معنایی را برمیگرداند.
بهترین کاربردها
- •روی لپتاپ بدون کارت گرافیک یک جستوجوی معنایی فارسی آفلاین بسازم
- •یک سیستم «از اسنادت بپرس» خصوصی برای اسناد فارسی شرکت راه بیندازم
- •جستوجوی ترکیبی (معنایی و کلمهای) روی اسناد طولانی داشته باشم
- •در Open WebUI یک مدل بردارساز محلی که فارسی را خوب میفهمد بگذارم
- •سؤالهای مشتری را آفلاین به پاسخهای آمادهٔ مرتبط وصل کنم
- •متنهای تکراری یا مشابه را در یک آرشیو بزرگ پیدا کنم
- •اسناد تا ۸ هزار توکن را بدون تکهتکه کردن زیاد بردارسازی کنم
برای این کارها سراغش نروید
- –نوشتن جواب یا چت (فقط بردار میسازد؛ برای جواب یک مدل چت لازم است)
- –خلاصهنویسی یا ترجمه
- –خواندن عکس و اسکن (اول با OCR متن را دربیاورید)
تصاویر محیط ابزار
نقاط قوت
- ✓مجوز MIT
- ✓در سنجهٔ فارسی FaMTEB دوم شد و در بازرتبهبندی اول
- ✓سبک: حدود ۱٫۲ گیگابایت در Ollama؛ بدون کارت گرافیک هم کار میکند
- ✓سه نوع بازیابی در یک مدل: معنایی، کلمهای و چندبرداری (ColBERT)
- ✓متن تا ۸۱۹۲ توکن
- ✓بسیار پرکاربرد؛ پشتیبانی آماده در Milvus و Vespa برای جستوجوی ترکیبی
نقاط ضعف
- ✗کمهزینه است (حدود ۱٫۲ گیگابایت؛ برآورد ۲ گیگابایت حافظهٔ کارت یا ۴ گیگابایت رم)، اما بردارسازی هزاران سند روی پردازنده زمان میبرد
- ✗مدل سال ۲۰۲۴ است؛ در آزمون فارسی MIRACL نسخههای 4B و 8B مدل Qwen3-Embedding کمی از آن بهترند
- ✗Ollama فقط بردار معنایی میدهد؛ برای حالت کلمهای و چندبرداری باید پایتون و FlagEmbedding نصب کنید
- ✗فایل رسمی هاگینگفیس به قالب قدیمی pytorch_model.bin است، نه safetensors
- ✗بهتنهایی جواب نمیدهد؛ کنار مدل چت و پایگاه برداری کار میکند
پرسشهای پرتکرار
مدل بردارساز (embedding) چیست؟
مدل بردارساز (embedding) متن نمینویسد؛ هر جمله یا پاراگراف را به یک فهرست عدد (بردار) تبدیل میکند، طوری که متنهای هممعنی بردارهای نزدیک به هم داشته باشند. با آن یک «از اسنادت بپرس» خصوصی میسازید: اسناد را تکهتکه و بردارسازی میکنید و در یک پایگاه برداری نگه میدارید؛ وقتی کسی سؤال میپرسد، مرتبطترین تکهها پیدا و به یک مدل چت آفلاین داده میشوند تا جواب بنویسد. به این روش RAG میگویند.
BGE-M3 بهتر است یا Qwen3-Embedding؟
در آزمون فارسی MIRACL در نتایج رسمی MTEB: BGE-M3 ۶۱٫۴، Qwen3-Embedding-0.6B ۵۴٫۳ و Qwen3-Embedding-8B ۶۲٫۶. اگر سختافزار کم دارید BGE-M3 انتخاب خوبی است؛ اگر کارت گرافیک دارید، Qwen3-Embedding-8B کمی دقیقتر است.
کارت گرافیک لازم دارد؟
نه؛ حدود ۴ گیگابایت رم کافی است (برآورد). کارت گرافیک فقط بردارسازی اولیهٔ حجم زیاد را سریعتر میکند.
در Open WebUI چطور استفاده کنم؟
ollama pull bge-m3 را بزنید، بعد در تنظیمات مدیر بخش Documents موتور بردارسازی را Ollama بگذارید و bge-m3 را انتخاب کنید. اگر قبلاً سند بارگذاری کردهاید، آنها را دوباره بردارسازی (Reindex) کنید.
جستوجوی ترکیبی یعنی چه؟
یعنی هم بر اساس معنی و هم بر اساس کلمههای دقیق جستوجو کنید. BGE-M3 هر دو نوع خروجی را همزمان میسازد و BAAI برای RAG ترکیب بازیابی ترکیبی و بازرتبهبندی را پیشنهاد میکند.
استفادهٔ تجاری آزاد است؟
بله؛ مجوز MIT است و فقط باید متن مجوز را همراه نسخه نگه دارید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
کوئن ۳ امبدینگ (آفلاین)
Qwen3-Embedding (offline)
مدل بردارساز متن علیبابا در سه اندازه (0.6B، 4B و 8B) برای جستوجوی معنایی و ساخت «از اسنادت بپرس» خصوصی؛ در بازیابی متن فارسی نتیجهٔ خوبی دارد و مجوزش Apache 2.0 است.
امبدینگ جما ۲ (آفلاین)
EmbeddingGemma 2 (offline)
مدل بردارساز (embedding) باز و چندرسانهای گوگل دیپمایند (۶ اکتبر ۲۰۲۶): متن، کد، تصویر، صدا و ویدئو را در یک فضای برداری مشترک میگذارد تا روی گوشی یا لپتاپ و بدون اینترنت، در اسناد، عکسها و یادداشتهای صوتی بر اساس معنی جستوجو کنید؛ از ۳۷۸ مگابایت، با مجوز Apache 2.0.
اولاما
Ollama
ابزار متنباز و رایگان برای اجرای مدلهای باز مثل Qwen3.5 و Gemma 4 روی ویندوز، مک و لینوکس: با یک دستور مدل را میگیرد و اجرا میکند، برنامهٔ چت دارد و API محلی روی پورت ۱۱۴۳۴ میدهد.