استودیوی صدای رایگان، متنباز و محلی برای کلون صدا، تبدیل متن به گفتار با ۷ موتور (مثل Qwen3-TTS و Kokoro) در ۲۳ زبان، تایپ صوتی با کلید میانبر و صدا دادن به ایجنتهای هوش مصنوعی — فارسی را نمیخواند.
معرفی: ویسباکس
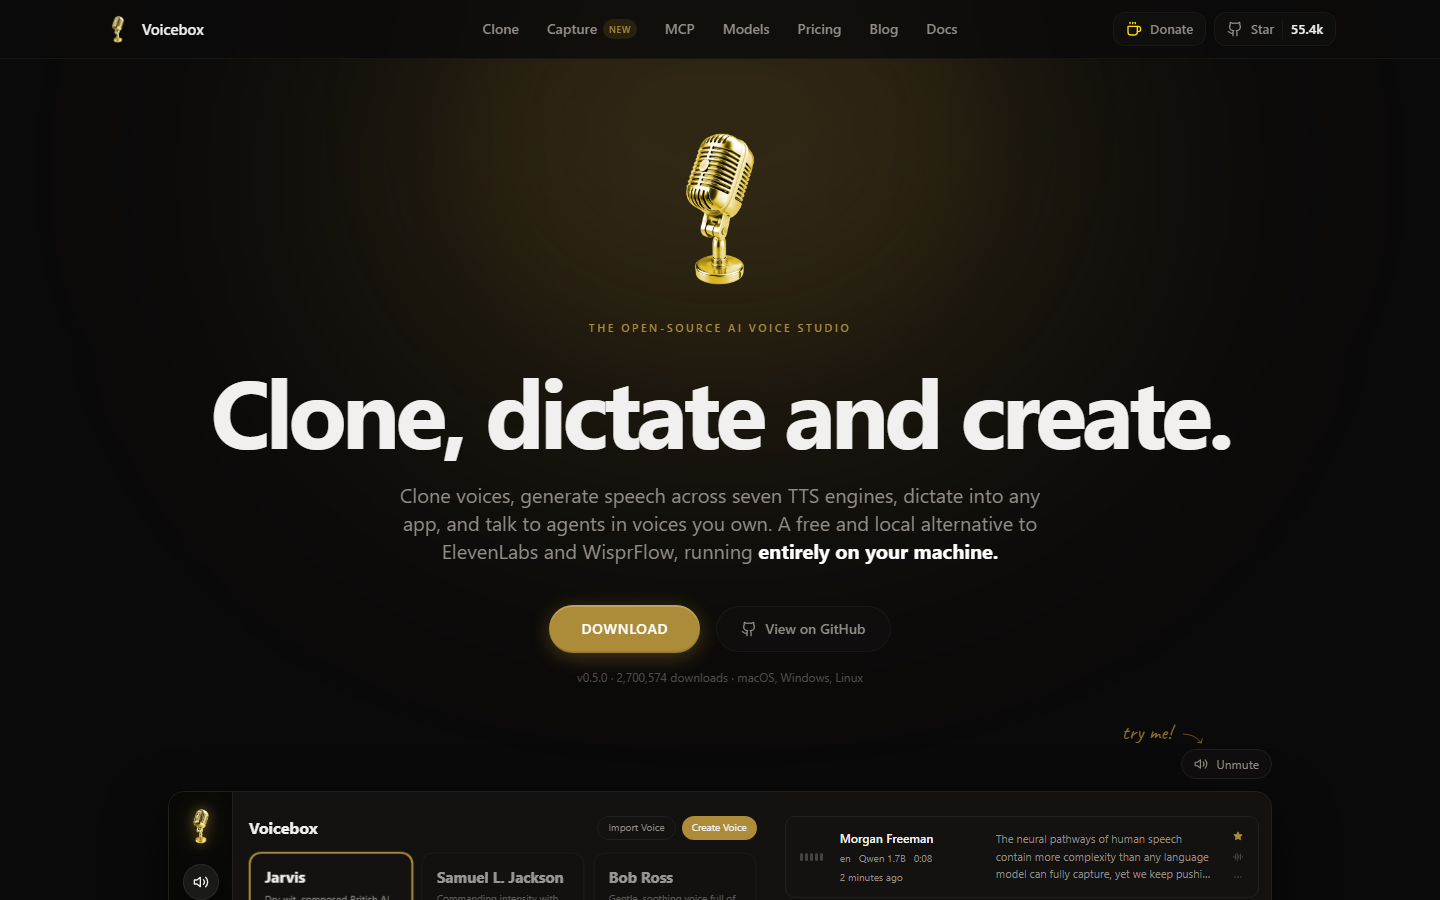
ویسباکس (voicebox.sh) اپ دسکتاپ رایگان و متنباز (MIT) جیمی پاین، سازندهٔ Spacedrive، است که خودش را جایگزین محلی ElevenLabs و Wispr Flow معرفی میکند: از ۳ تا ۳۰ ثانیه نمونهٔ صدا (فایل، میکروفون یا صدای در حال پخش سیستم) پروفایل صوتی میسازد و با هفت موتور Qwen3-TTS، Qwen CustomVoice، LuxTTS، Chatterbox چندزبانه، Chatterbox Turbo، HumeAI TADA و Kokoro متن را به گفتار تبدیل میکند؛ متن تا ۵۰ هزار کاراکتر خودکار تکهتکه و بیدرز به هم وصل میشود. ویرایشگر Stories برای گفتگو و پادکست چندصدایی روی تایملاین، افکتهایی مثل تغییر زیر و بمی، اکو و صدای رباتی، تایپ صوتی سراسری با Whisper، شخصیتدادن به صدا با یک مدل زبانی محلی (Qwen3)، سرور MCP داخلی (تا Claude Code یا Cursor با صدای دلخواه شما حرف بزنند) و REST API محلی هم دارد.
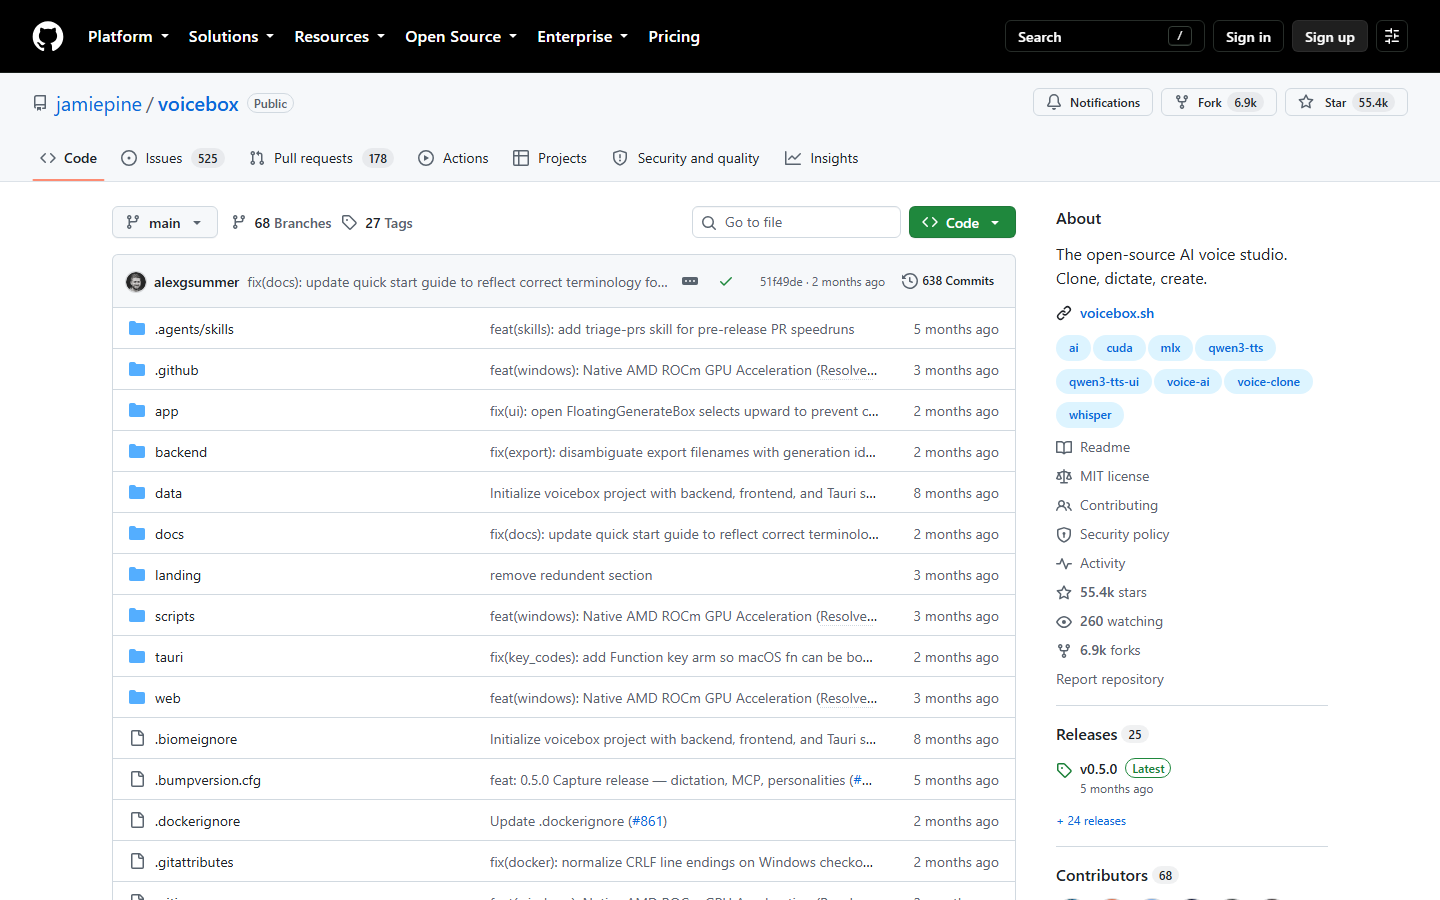
۲۳ زبان موتورها عربی، ترکی و عبری را دارد ولی فارسی ندارد، پس برای گویندگی فارسی مناسب نیست؛ تایپ صوتی با Whisper زبان را خودکار تشخیص میدهد و گفتار فارسی را هم مینویسد (برای دقت بهتر مدل Large یا Turbo). چسباندن خودکار متن دیکته در برنامههای دیگر فعلاً فقط روی مک است و روی ویندوز متن به کلیپبورد میرود. نصبکنندهٔ آماده برای مک و ویندوز هست؛ لینوکس فعلاً باید از سورس (Python 3.11+، Rust و Bun) یا Docker اجرا شود. حداقل ۸ گیگ رم (۱۶ گیگ توصیهشده) و ۵ تا ۱۰ گیگ فضا لازم است؛ روی CPU هم کار میکند ولی کارت انویدیا خیلی سریعترش میکند. آخرین نسخهٔ منتشرشده 0.5.0 (آوریل ۲۰۲۶) است و بیش از ۷۰۰ ایشوی باز دارد.
بهترین کاربردها
- •صدای یه نفر رو از چند ثانیه نمونه کلون کنم که متن انگلیسی بخونه
- •با یه کلید میانبر حرف بزنم و هر جا دارم تایپ میکنم متنش نوشته بشه
- •پادکست یا گفتگوی چندنفره با صداهای مختلف روی تایملاین بسازم
- •یه متن بلند انگلیسی رو یکجا به فایل صوتی تبدیل کنم
- •به ایجنت کدنویسی مثل Claude Code یا Cursor صدا بدم که باهام حرف بزنه
- •فایل صوتی رو روی سیستم خودم با Whisper به متن تبدیل کنم
- •روی صدای ساختهشده افکت رباتی، اکو یا تغییر زیر و بمی بذارم
- •جایگزین رایگان ElevenLabs و Wispr Flow روی کامپیوتر خودم پیدا کنم
برای این کارها سراغش نروید
- –تبدیل متن فارسی به صدا
- –دوبلهٔ ویدئو به زبان دیگر
- –ساخت صدای جدید از روی توضیح متنی
- –استفاده روی گوشی موبایل
اجرا روی سیستم خودتان
این برنامه را روی سیستم خودتان نصب میکنید و هوش مصنوعی روی همان دستگاه اجرا میشود؛ متن و فایلهایتان از آن بیرون نمیرود.
- بعد از نصب، بدون اینترنت
- متنباز
- MIT — استفادهٔ تجاری آزاد
- برنامهٔ گرافیکی
- رابط وب
- API
هر موتور صدا بار اول مدلش را دانلود میکند (از حدود ۳۵۰ مگابایت برای Kokoro تا ۸ گیگابایت برای TADA 3B؛ Qwen 1.7B حدود ۳٫۵ گیگابایت)؛ بعد از آن محلی و بدون اینترنت کار میکند.
خود برنامه MIT است و برای کار تجاری آزاد؛ اما مجوز هر موتور صدا جداست و پیش از استفادهٔ تجاری باید مجوز همان مدل را خواند.
سختافزار لازم
- حداقل رم: ۸ گیگابایت — پیشنهادی: ۱۶ گیگابایت
- کارت گرافیک پیشنهاد میشود
- طبق راهنمای نصب: حداقل ۸ گیگابایت رم و ۵ گیگابایت فضا؛ پیشنهادی ۱۶ گیگابایت رم، ۱۰ گیگابایت فضا و کارت انویدیا (CUDA). روی CPU هم کار میکند ولی خیلی کندتر است. مک اپل سیلیکون از MLX استفاده میکند و در ویندوز کارتهای غیرانویدیا با DirectML شتاب میگیرند.
نصب و اجرا
- ۱
ویندوز: نصبکننده را بگیریدویندوز
Voicebox_0.5.0_x64-setup.exe یا فایل MSI را از Releases گیتهاب بگیرید؛ برای کارت انویدیا، برنامه کتابخانههای CUDA را خودش دانلود میکند.
- ۲
مکمک
Voicebox_0.5.0_aarch64.dmg برای اپل سیلیکون و Voicebox_0.5.0_x64.dmg برای مک اینتلی.
- ۳
لینوکس یا سرور: اجرا با داکرلینوکس
git clone https://github.com/jamiepine/voicebox.git && cd voicebox && docker compose upنسخهٔ آمادهٔ لینوکس هنوز منتشر نشده. رابط وب روی http://localhost:17493 باز میشود. ساختن ایمیج، ایمیجهای پایه را از Docker Hub میگیرد.
- ۴
پروفایل صدا بسازید
در بخش Profiles یک نمونهٔ کوتاه و تمیز از صدا بدهید و موتور را انتخاب کنید؛ مدل همان موتور بار اول دانلود میشود.
دانلود
- Voicebox (GitHub Releases) ↗رسمی
ویندوز (exe و MSI) و مک (اپل سیلیکون و اینتل)
- راهنمای رسمی ↗رسمی
نکات امنیتی
- API محلی (پورت ۱۷۴۹۳) احراز هویت ندارد؛ طبق راهنمای رسمی آن را فقط در شبکهٔ مطمئن باز کنید یا پشت پراکسی با احراز هویت بگذارید.
- کلون صدای دیگران فقط با اجازهٔ خودشان مجاز است.
برای شرکتها و سازمانها
نسخهٔ داکر رابط وب و API دارد اما حساب کاربری و احراز هویت ندارد؛ برای استفادهٔ چندنفره باید پشت پراکسی با احراز هویت قرار بگیرد.
آخرین بررسی: ۱۲ مهر ۱۴۰۵
تصاویر محیط ابزار
نقاط قوت
- ✓رایگان، متنباز و کاملاً محلی؛ بدون حساب و بدون ارسال صدا به سرور
- ✓هفت موتور TTS قابل انتخاب و ویرایشگر چندصدایی برای پادکست و داستان
- ✓تایپ صوتی سراسری و صدا دادن به ایجنتها با MCP و API
- ✓نصب آسان روی مک و ویندوز با رابط تمیز
نقاط ضعف
- ✗فارسی در زبانهای تبدیل متن به گفتار نیست
- ✗نسخهٔ آمادهٔ لینوکس ندارد و چسباندن خودکار دیکته فقط روی مک است
- ✗از آوریل ۲۰۲۶ نسخهٔ جدیدی منتشر نشده و ایشوهای باز زیاد است
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه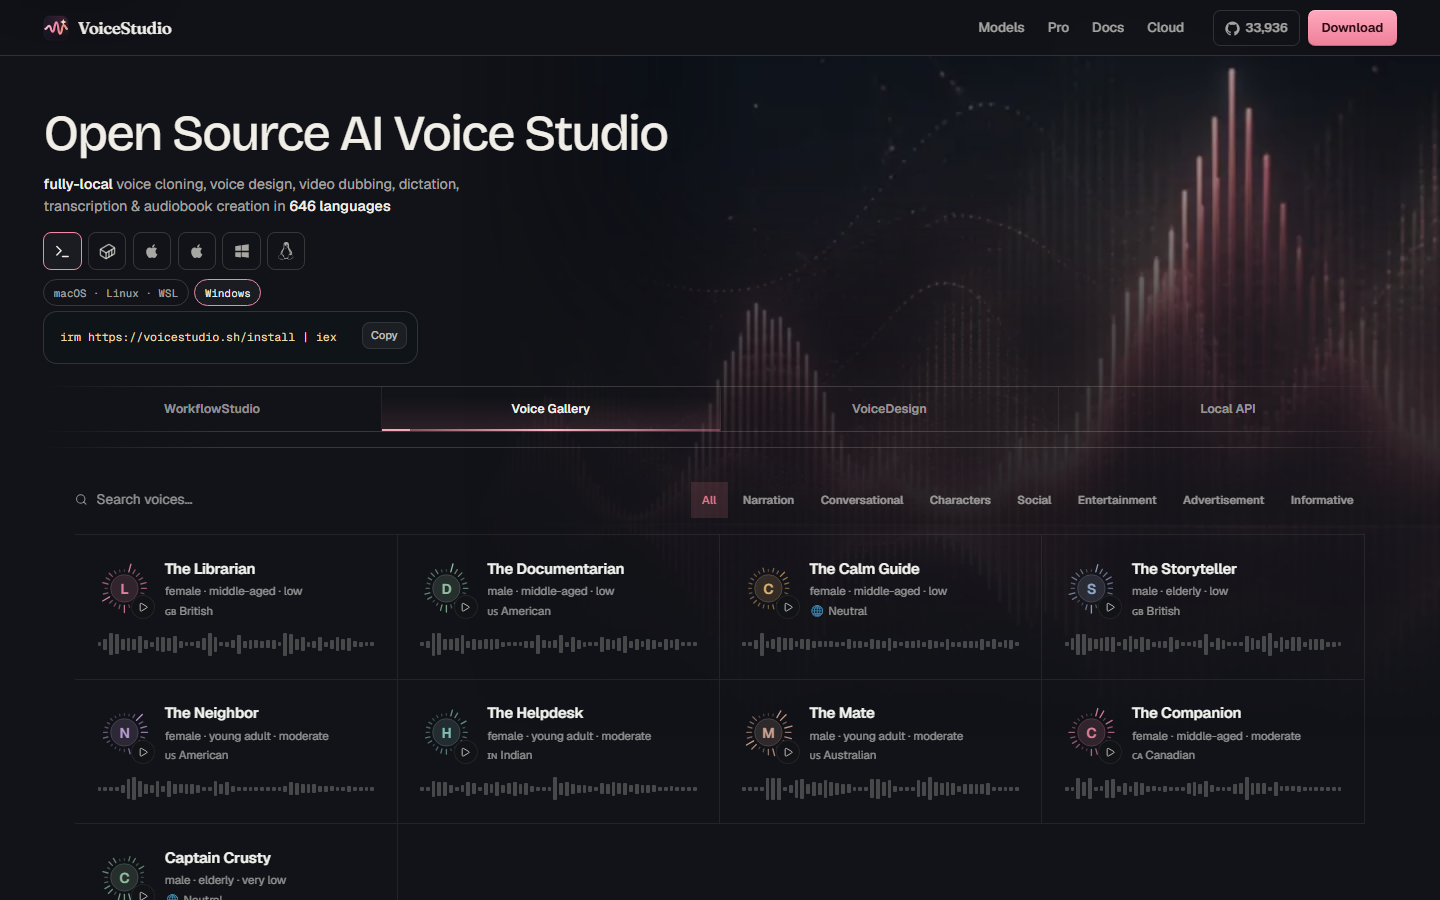
ویساستودیو
VoiceStudio
استودیوی صدای رایگان، متنباز و کاملاً آفلاین (نام قبلی OmniVoice Studio): کلون صدا از چند ثانیه نمونه، ساخت صدای جدید با توصیف، دوبلهٔ ویدئو و تبدیل گفتار به متن در ۶۴۶ زبان — از جمله فارسی — روی کامپیوتر خودتان.
مورف
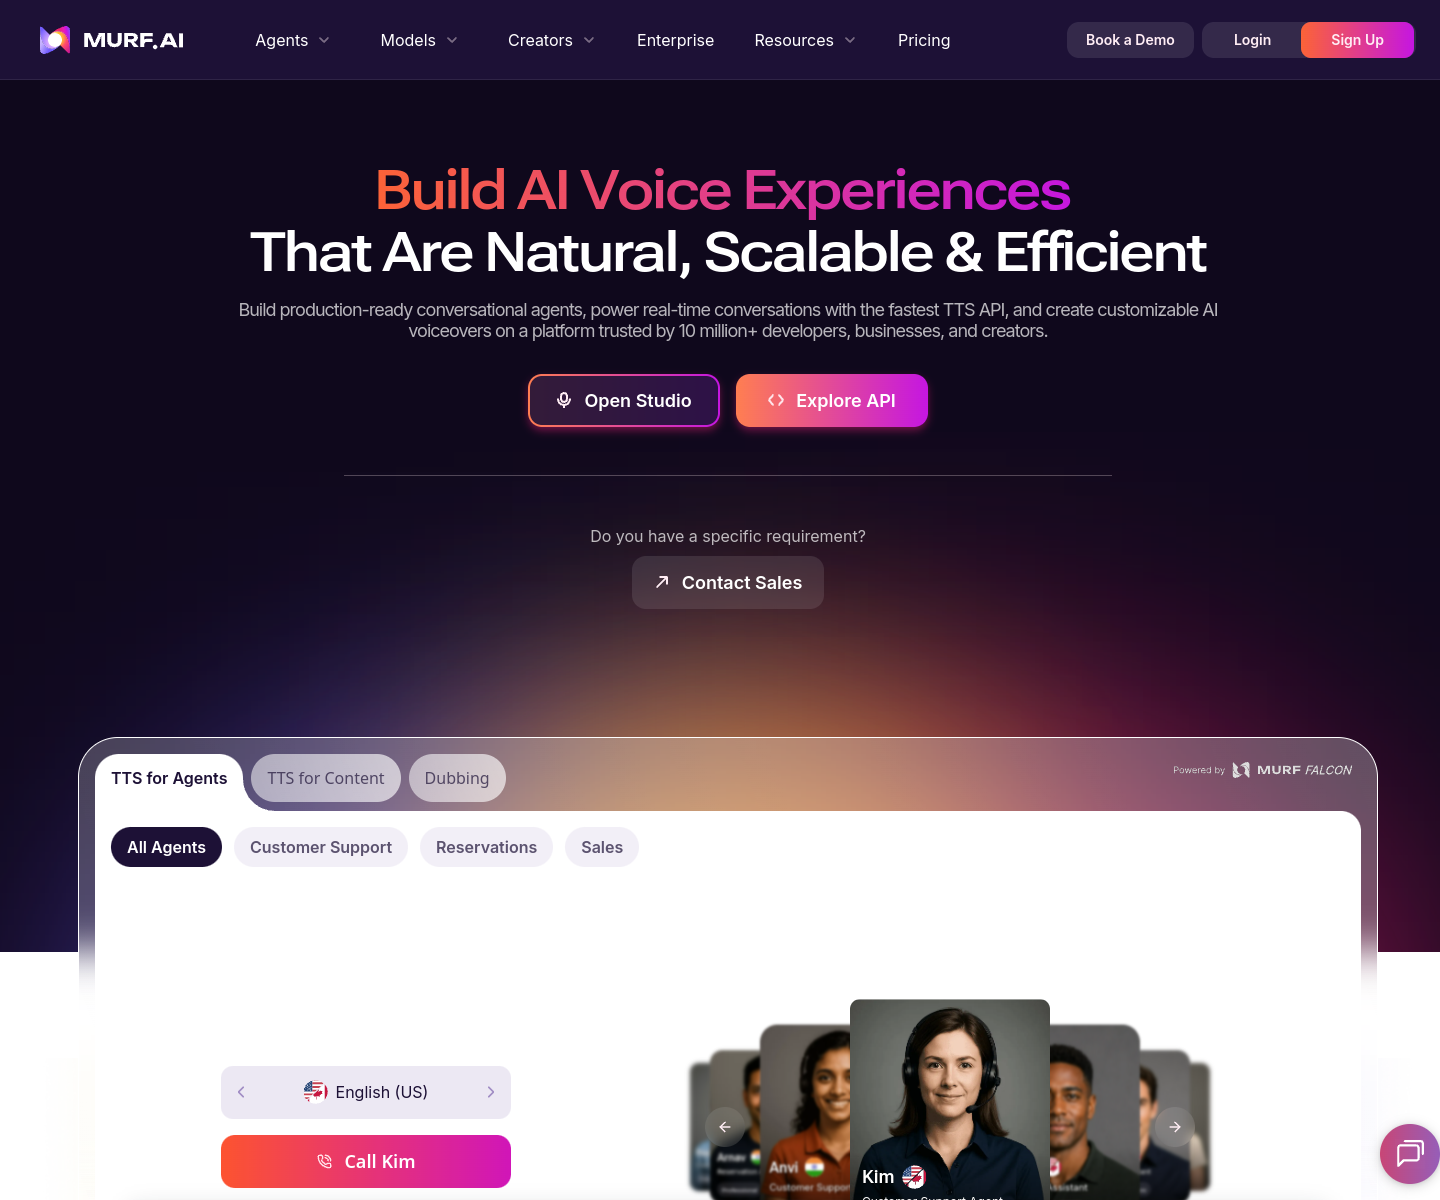
Murf AI
استودیوی ساخت صدای گوینده با هوش مصنوعی؛ متن را تایپ میکنید و با صدها صدای طبیعی برای ویدئو، دورهٔ آموزشی و تبلیغ نریشن میگیرید.
ویسمود
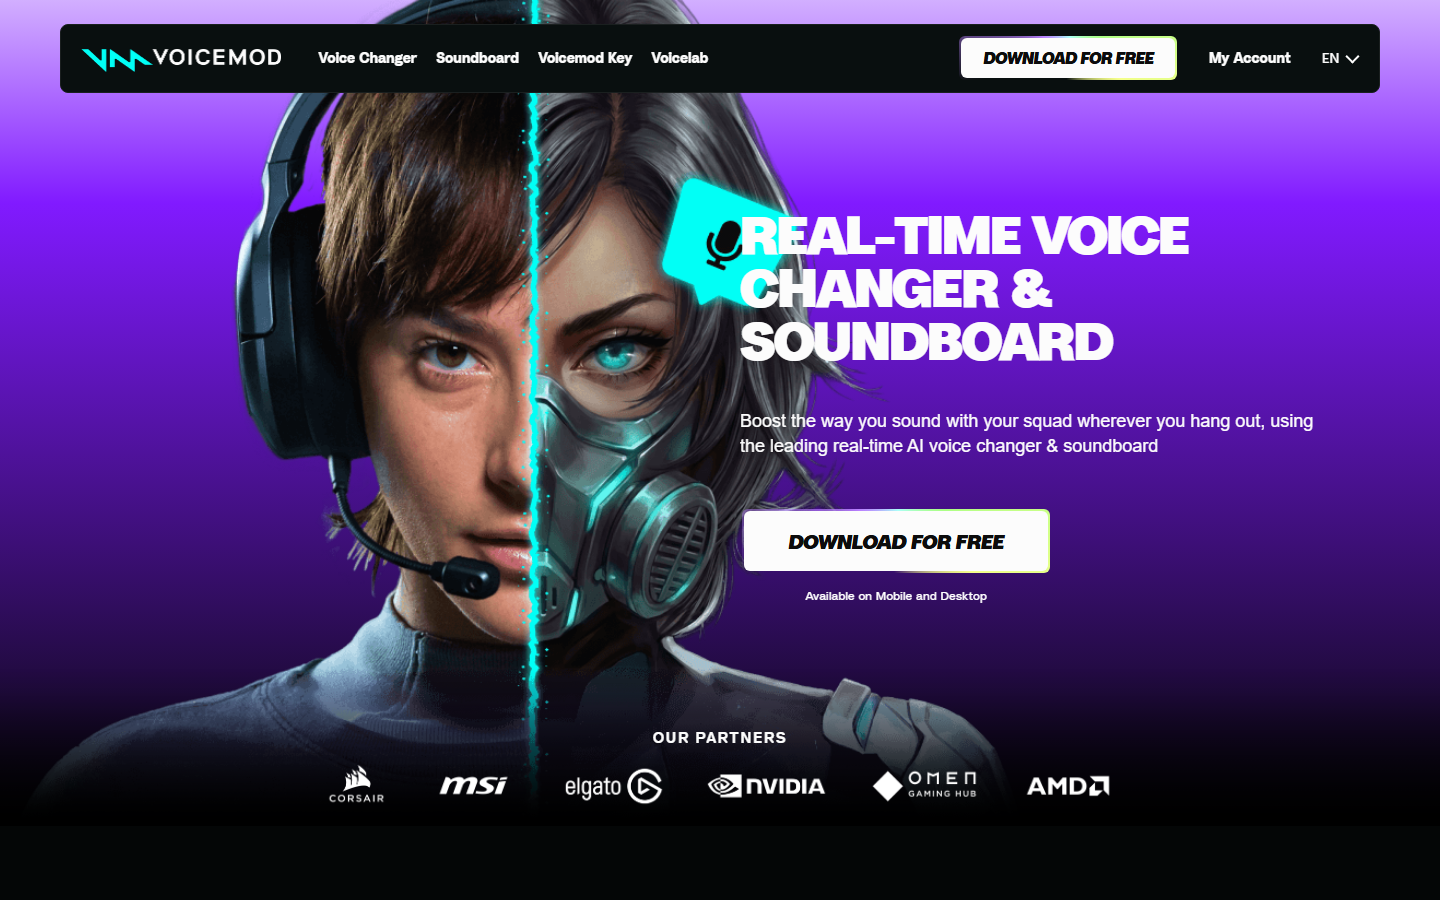
VoiceMod
تغییر صدای زنده (Real-time) برای گیم و استریم؛ صدای شما را همان لحظه در دیسکورد، بازیها و تماسها عوض میکند.