جیالام ۴.۷ فلش (آفلاین)
GLM-4.7-Flash (offline)مدل ۳۰ میلیاردی Z.ai با ۳ میلیارد پارامتر فعال برای کدنویسی، استدلال و ایجنت؛ روی کارت ۲۴ گیگابایتی یا کامپیوتر ۳۲ گیگابایتی آفلاین اجرا میشود و مجوز MIT دارد.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- MIT — استفادهٔ تجاری آزاد
- فارسی: نامعلوم
- برنامهٔ گرافیکی
- خط فرمان
- API
فقط دانلود اول اینترنت میخواهد. API رایگان Z.ai سرویس ابری جداگانهای است و آفلاین نیست.
استفادهٔ تجاری، تغییر و بازتوزیع آزاد است؛ فقط متن مجوز MIT و نام صاحب حق را همراه نسخه نگه دارید.
نسخهها و سختافزار لازم
- 30B-A3B۳۱B (فعال ۳B)طول متن ۲۰۰ هزار توکن
- حجم دانلود:
- ۱۹ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۲۳ گیگ یا رم ۲۵ گیگ
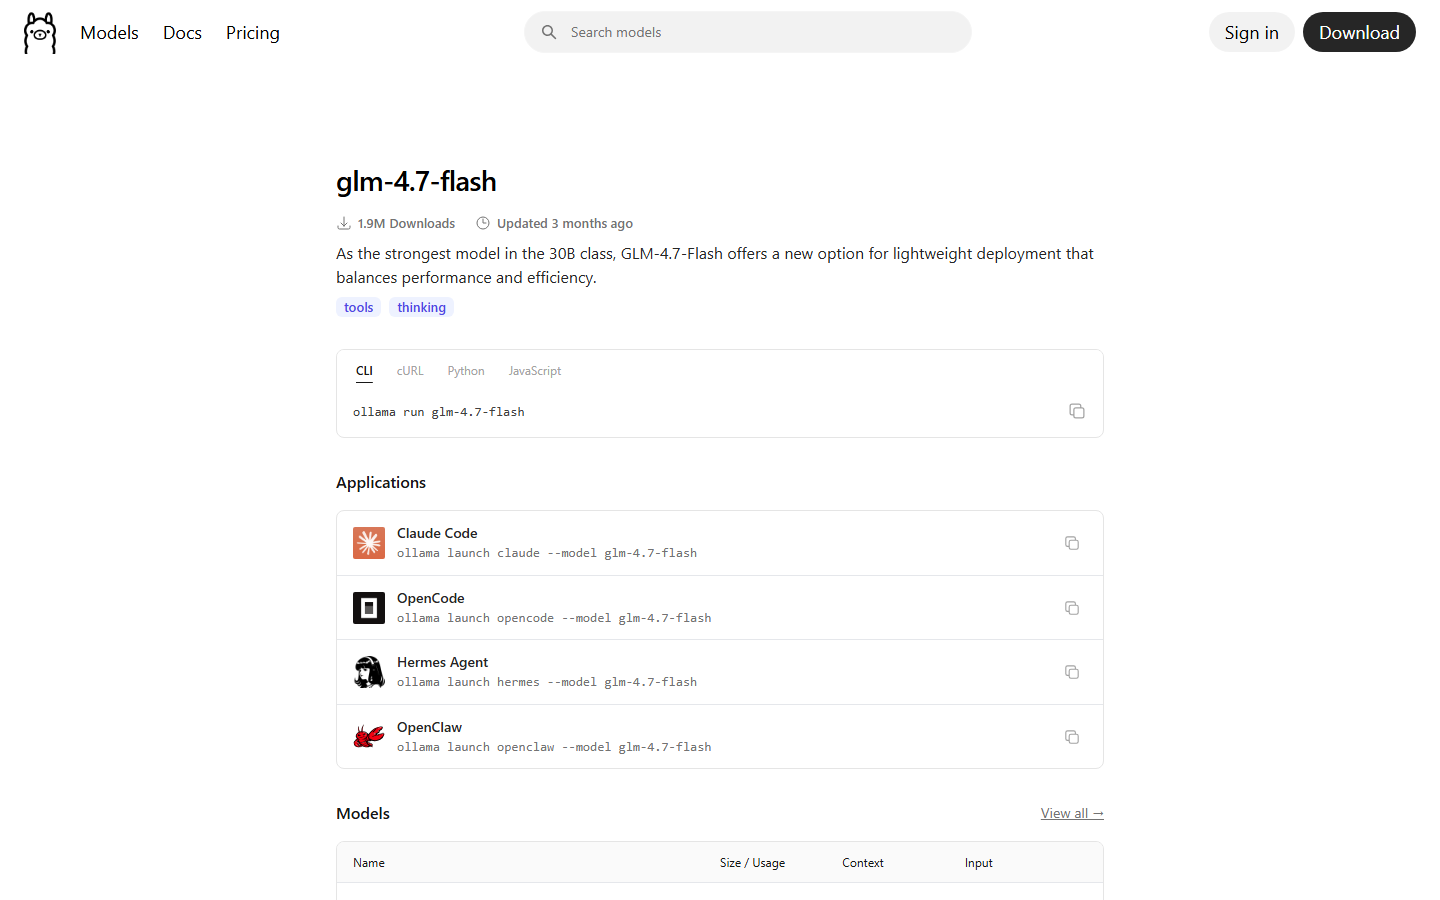
ollama run glm-4.7-flashZ.ai آن را 30B-A3B مینامد (شمارش دقیق فایل حدود ۳۱ میلیارد پارامتر). حجمها از Ollama است و Ollama نسخهٔ 0.14.3 یا جدیدتر لازم است. Ollama پنجرهٔ متن را ۱۹۸ هزار نشان میدهد و Z.ai ۲۰۰ هزار. حداقل حافظه برآوردی است.
نصب و اجرا
- ۱
Ollama را نصب کنیدلینوکس
curl -fsSL https://ollama.com/install.sh | shدر ویندوز و مک، برنامهٔ نصب را از ollama.com/download بگیرید.
- ۲
مدل را بگیرید و اجرا کنید
ollama run glm-4.7-flashحدود ۱۹ گیگابایت دانلود؛ Ollama نسخهٔ 0.14.3 یا جدیدتر لازم است.
- ۳
یا با LM Studio
lms get zai-org/glm-4.7-flashLM Studio حداقل ۱۶ گیگابایت رم را برای کوچکترین نسخه اعلام کرده است.
- ۴
روی سرور ۴ کارته با vLLMلینوکس
vllm serve zai-org/GLM-4.7-Flash --tensor-parallel-size 4 --speculative-config.method mtp --speculative-config.num_speculative_tokens 1 --tool-call-parser glm47 --reasoning-parser glm45 --enable-auto-tool-choice --served-model-name glm-4.7-flashدستور رسمی Z.ai از کارت مدل. SGLang هم پشتیبانی میکند.
دانلود
- Ollama ↗رسمی
نسخههای ۴، ۸ و ۱۶ بیتی (۱۹ تا ۶۰ گیگابایت).
- Hugging Face (مخزن رسمی Z.ai) ↗رسمی
وزن کامل BF16، حدود ۶۲ گیگابایت.
- ModelScope (حساب رسمی ZhipuAI) ↗رسمی
همان وزنها روی ModelScope.
- LM Studio ↗رسمی
نسخههای GGUF و MLX.
نکات امنیتی
- ایجنت برنامهنویسی میتواند فایل پاک کند و دستور اجرا کند؛ در پوشهٔ پروژهٔ تحت گیت کار کنید، هر تغییر را پیش از تأیید ببینید و فایلهای .env و کلیدها را از دسترسش دور نگه دارید.
- پورت ۱۱۴۳۴ Ollama را به اینترنت باز نکنید؛ Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و بهتر است همینطور بماند.
- وزنها را فقط از مخزن رسمی سازنده یا کتابخانههای شناختهشده (Ollama، LM Studio) بگیرید؛ قالب safetensors و GGUF کد اجرایی ندارند.
برای شرکتها و سازمانها
برای دادههای محرمانه، نسخهٔ محلی را روی سرور داخلی اجرا کنید، نه API رایگان Z.ai. هر برنامهنویس میتواند آن را روی کامپیوتر خودش داشته باشد؛ برای سرویس مشترک، Z.ai دستور vLLM و SGLang را برای ۴ کارت منتشر کرده است.
برنامههایی که این مدل را اجرا میکنند
 اولاما
 الام استودیو
 لاما سیپیپی
 کوبولد سیپیپی
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۵ دی ۱۴۰۴
معرفی: جیالام ۴.۷ فلش (آفلاین)
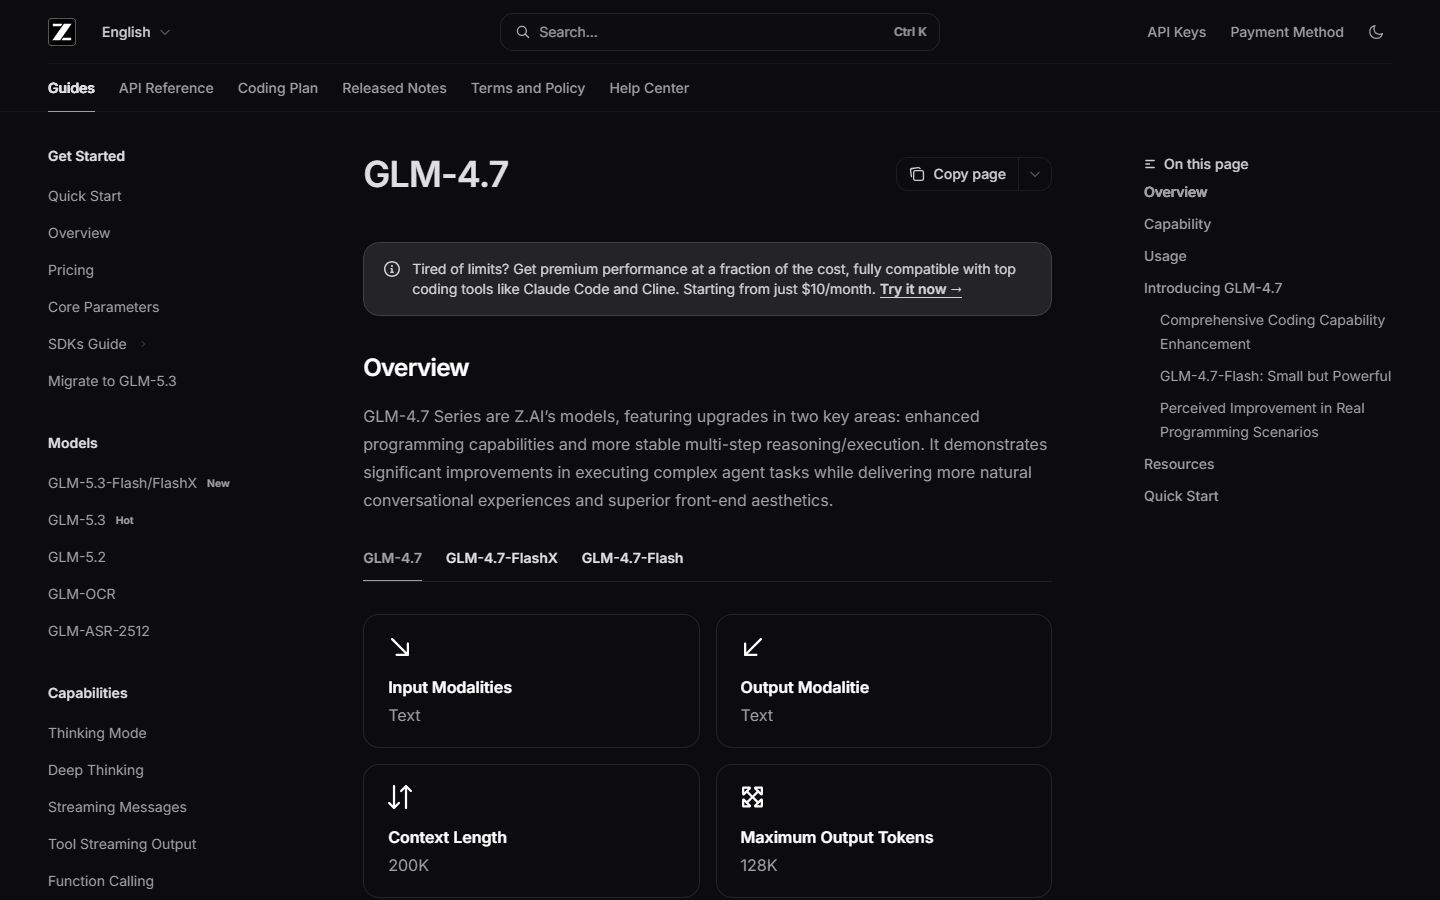
GLM-4.7-Flash نسخهٔ سبک خانوادهٔ GLM-4.7 از شرکت Z.ai است که ۱۹ ژانویهٔ ۲۰۲۶ منتشر شد. معماری MoE با حدود ۳۰ میلیارد پارامتر دارد که در هر توکن فقط ۳ میلیارد آن کار میکند. پیش از جواب «فکر» میکند، ابزار صدا میزند و پنجرهٔ متنش ۲۰۰ هزار توکن است.
Z.ai آن را قویترین مدل ردهٔ ۳۰ میلیاردی میداند؛ مثلاً در SWE-bench Verified به ۵۹٫۲ رسیده، در برابر ۲۲ برای Qwen3-30B-A3B-Thinking و ۳۴ برای GPT-OSS-20B. برای برنامهنویسها، دانشجوها و تیمهای کوچکی است که مدل کدنویسی و استدلالی آفلاین با مجوز MIT میخواهند.
سختافزار: نسخهٔ ۴ بیتی Ollama حدود ۱۹ گیگابایت است و روی کارت ۲۴ گیگابایتی یا کامپیوتر و مک ۳۲ گیگابایتی اجرا میشود. LM Studio نسخهٔ سبکتری دارد که به گفتهٔ خودش با ۱۶ گیگابایت رم کار میکند.
برای شروع، ollama run glm-4.7-flash یا lms get zai-org/glm-4.7-flash کافی است. برای سرور تیمی، Z.ai دستور vLLM و SGLang را برای ۴ کارت داده است.
محدودیتها: عکس نمیخواند، زبانهای رسمیاش انگلیسی و چینی است و چون استدلالی است، جوابها دیرتر میرسند.
بهترین کاربردها
- •روی کامپیوتر با کارت ۲۴ گیگابایتی یک مدل کدنویسی و استدلال آفلاین اجرا کنم
- •یک ایجنت برنامهنویسی آفلاین با مجوز MIT برای کار تجاری میخواهم
- •فرانتاند و بکاند یک پروژه را بدون اینترنت با هوش مصنوعی بنویسم
- •مسئلههای ریاضی و منطقی را روی لپتاپ قوی بدون اینترنت حل کنم
- •در VS Code با Cline یا Kilo Code یک مدل محلی داشته باشم
- •متنهای طولانی (تا ۲۰۰ هزار توکن) را آفلاین بررسی کنم
برای این کارها سراغش نروید
- –خواندن عکس و اسکن (فقط متن)
- –ساخت تصویر یا صدا
- –نوشتن فارسی حساس بدون آزمایش قبلی
- –گوشی یا لپتاپ ۸ گیگابایتی
تصاویر محیط ابزار
نقاط قوت
- ✓مجوز MIT
- ✓طبق Z.ai قویترین مدل ردهٔ ۳۰ میلیاردی؛ ۵۹٫۲ در SWE-bench Verified
- ✓فقط ۳ میلیارد پارامتر فعال؛ روی سختافزار خانگی سریع است
- ✓حالت فکر کردن و ابزارخوانی دارد
- ✓در Ollama و LM Studio با یک فرمان نصب میشود
- ✓پنجرهٔ متن ۲۰۰ هزار توکنی
نقاط ضعف
- ✗نسخهٔ ۴ بیتی Ollama حدود ۱۹ گیگابایت است و دستکم حدود ۲۳ گیگابایت حافظهٔ کارت گرافیک یا ۲۵ گیگابایت رم (برآورد) میخواهد
- ✗عکس نمیخواند
- ✗زبانهای رسمی فقط انگلیسی و چینی است؛ فارسی سنجیده نشده
- ✗چون مدل استدلالی است، پیش از جواب «فکر» میکند و جواب دیرتر میآید
پرسشهای پرتکرار
با چه سختافزاری اجرا میشود؟
نسخهٔ ۴ بیتی Ollama حدود ۱۹ گیگابایت است: کارت گرافیک ۲۴ گیگابایتی یا کامپیوتر و مک ۳۲ گیگابایتی. LM Studio نسخهٔ سبکتری دارد که به گفتهٔ خودش با ۱۶ گیگابایت رم اجرا میشود.
رایگان است؟
بله؛ مجوز MIT است و استفادهٔ تجاری آزاد است. API ابری Z.ai هم برای این مدل رایگان است، اما آن نسخه دیگر آفلاین نیست.
فارسی بلد است؟
زبانهای رسمی کارت مدل انگلیسی و چینی است و آزمون فارسی منتشر نشده. Z.ai آن را برای ترجمه و متن طولانی هم پیشنهاد میکند، ولی کیفیت فارسیاش را خودتان بسنجید.
چرا جوابش دیر میآید؟
مدل استدلالی است و اول فکر میکند. برای گفتوگوهای چندمرحلهای ایجنتی، Z.ai حالت Preserved Thinking را پیشنهاد میکند.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
فریباف
Freebuff
عامل کدنویسی رایگان (جایگزین Claude Code / Cursor) با CLI، دسکتاپ، وب و کلود؛ مدلهای frontier بدون اشتراک، تأمینشده با تبلیغات متنی.
کوئن ۳ کدر (آفلاین)
Qwen3-Coder (offline)
مدل برنامهنویسی متنباز علیبابا در سه اندازه (30B، Next با ۸۰ میلیارد و 480B)؛ دو نسخهٔ کوچکتر فقط ۳ میلیارد پارامتر فعال دارند و ایجنت کدنویسی و تکمیل کد را بدون اینترنت اجرا میکنند. مجوز Apache 2.0.
آنتیگرویتی
Google Antigravity
پلتفرم توسعه ایجنتمحور گوگل: IDE دسکتاپ + CLI + SDK؛ نسخه 2.0 (I/O 2026) با ایجنتهای موازی، سندباکس ابری و پلن رایگان واقعی.