میسترال اسمال ۴ (آفلاین)
Mistral Small 4 (offline)مدل متنباز ۱۱۹ میلیارد پارامتری میسترال با مجوز Apache 2.0 که چت، استدلال، برنامهنویسی و خواندن عکس را یکجا دارد و فارسی جزو زبانهای رسمیاش است؛ برای سرور شرکت یا دستگاه ۱۲۸ گیگابایتی.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- Apache-2.0 — استفادهٔ تجاری آزاد
- فارسی: خوب
- برنامهٔ گرافیکی
- API
فقط دانلود اول اینترنت میخواهد. API ابری میسترال سرویس جداگانهای است و آفلاین نیست.
استفادهٔ تجاری، تغییر و بازتوزیع آزاد است؛ فقط متن مجوز و اعلانها را همراه نسخهای که پخش میکنید نگه دارید. کارت مدل تأکید میکند که نباید با آن حقوق دیگران (مثل حق نشر) را نقض کرد.
نسخهها و سختافزار لازم
- 119B-A6.5B۱۱۹B (فعال ۶٫۵B)طول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۷۲٫۲ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۸۷ گیگ یا رم ۸۹ گیگ
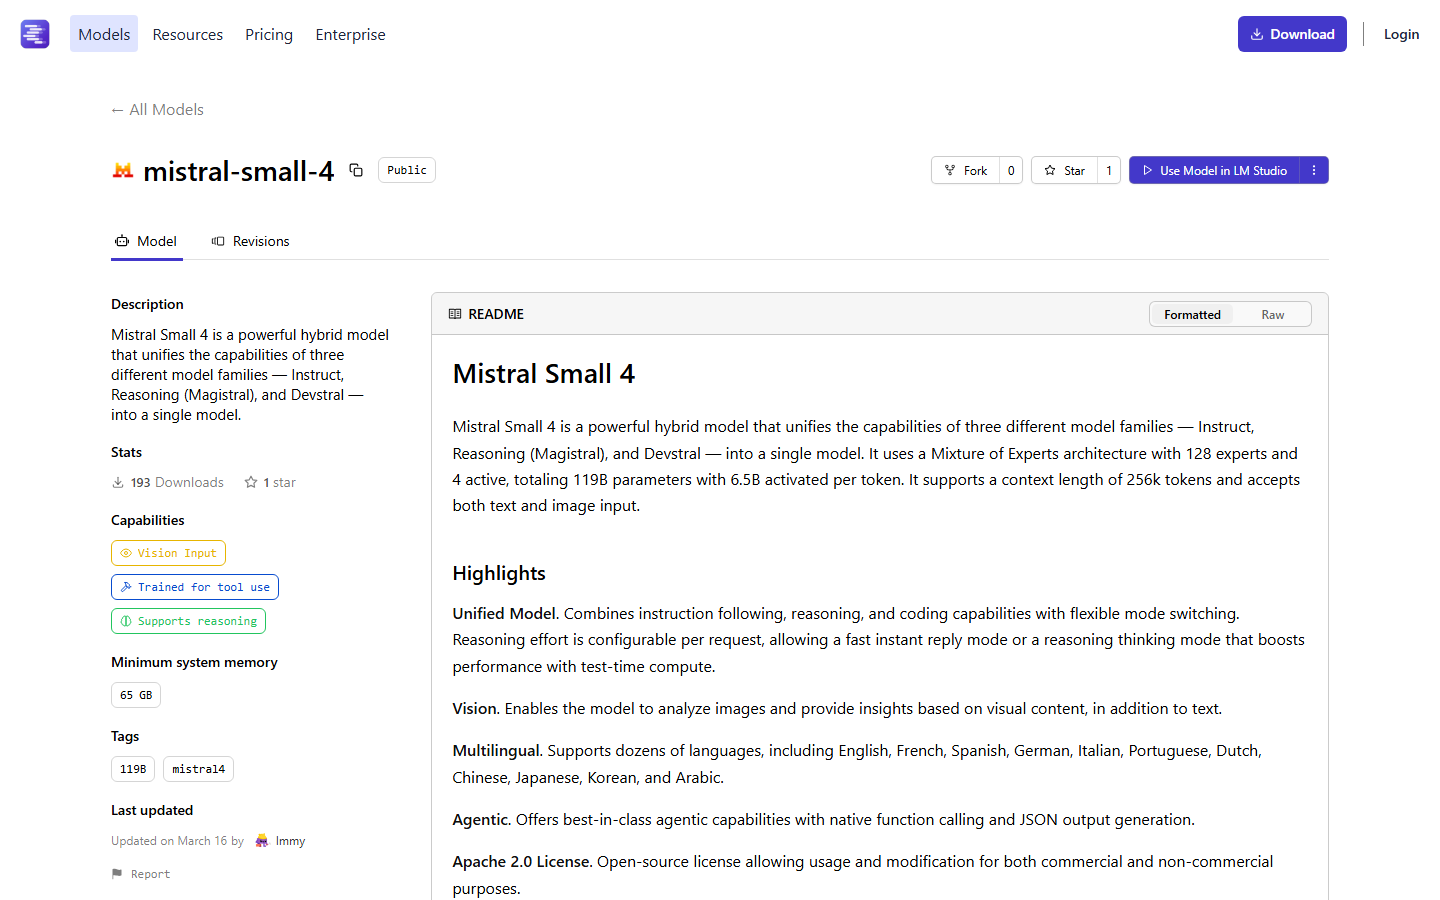
حجم ۴ بیتی از نسخهٔ GGUF در LM Studio است (بهعلاوهٔ فایل ۰٫۹ گیگابایتی برای خواندن عکس)؛ حداقل حافظه برآوردی است. وزن رسمی FP8 حدود ۱۲۱ گیگابایت است و برای vLLM دو کارت H200 یا B200 میخواهد. LM Studio خودش حداقل ۶۵ گیگابایت حافظه را اعلام کرده است.
- 119B NVFP4۱۱۹B (فعال ۶٫۵B)طول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۷۰٫۸ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۸۵ گیگ یا رم ۸۷ گیگ
نسخهٔ ۴ بیتی رسمی میسترال فقط برای کارتهای NVIDIA نسل Blackwell (مثل B200)؛ طبق دستورالعمل vLLM روی یک B200 با متن کوتاهتر و روی دو B200 با کل ۲۵۶ هزار توکن اجرا میشود. حداقل حافظه برآوردی است.
نصب و اجرا
- ۱
روی دستگاه ۱۲۸ گیگابایتی: مدل را در LM Studio بگیرید
lms get mistralai/mistral-small-4اول برنامهٔ LM Studio را از lmstudio.ai نصب کنید. نسخهٔ ۴ بیتی حدود ۷۲ گیگابایت است.
- ۲
روی سرور لینوکس، vLLM را نصب کنیدلینوکس
uv pip install -U vllmvLLM نسخهٔ 0.20.0 یا جدیدتر لازم است؛ این دستور mistral_common را هم نصب میکند.
- ۳
وزنها را یک بار دانلود کنیدلینوکس
hf download mistralai/Mistral-Small-4-119B-2603ابزار hf با pip install -U "huggingface_hub[cli]" نصب میشود. حجم کل حدود ۲۴۲ گیگابایت است. برای سرور بدون اینترنت، پوشهٔ کش هاگینگفیس را کپی کنید و HF_HUB_OFFLINE=1 بگذارید.
- ۴
سرویس را روی دو کارت بالا بیاوریدلینوکس
vllm serve mistralai/Mistral-Small-4-119B-2603 --max-model-len 262144 --tensor-parallel-size 2 --tool-call-parser mistral --enable-auto-tool-choice --reasoning-parser mistral --max-num-batched-tokens 16384 --max-num-seqs 128 --gpu-memory-utilization 0.8دستور رسمی vLLM برای ۲ کارت H200 یا B200؛ یک API سازگار با OpenAI روی پورت ۸۰۰۰ میدهد.
- ۵
برای کارتهای Blackwell، نسخهٔ NVFP4 سبکتر استلینوکس
vllm serve mistralai/Mistral-Small-4-119B-2603-NVFP4 --max-model-len 262144 --tensor-parallel-size 2 --tool-call-parser mistral --enable-auto-tool-choice --reasoning-parser mistral --max-num-batched-tokens 16384 --max-num-seqs 128 --gpu-memory-utilization 0.8روی یک B200 هم اجرا میشود، اما برای کل ۲۵۶ هزار توکن دو کارت لازم است.
دانلود
- Hugging Face (مخزن رسمی میسترال) ↗رسمی
وزن رسمی FP8؛ هر قالب حدود ۱۲۱ گیگابایت، کل مخزن حدود ۲۴۲ گیگابایت.
- Hugging Face — NVFP4 ↗رسمی
نسخهٔ ۴ بیتی رسمی برای کارتهای Blackwell؛ حدود ۷۱ گیگابایت.
- LM Studio ↗رسمی
نسخهٔ GGUF برای کامپیوتر و مک؛ کارت رسمی مدل به آن لینک داده است.
- Unsloth GGUF ↗غیررسمی
کوانتهای جامعه برای llama.cpp، از ۳۲ تا ۲۳۸ گیگابایت؛ کارت رسمی به آن لینک داده است.
نکات امنیتی
- پورت API سرور (۸۰۰۰ در vLLM) را به اینترنت باز نکنید؛ آن را پشت فایروال یا VPN داخلی بگذارید و با گزینهٔ --api-key کلید تعیین کنید.
- وزنها را فقط از مخزن رسمی سازنده یا کتابخانههای شناختهشده (Ollama، LM Studio) بگیرید؛ قالب safetensors و GGUF کد اجرایی ندارند.
- اگر مدل را به ابزار یا ایجنت وصل میکنید، دسترسیهایش را محدود کنید؛ مدل ممکن است ابزار را اشتباه صدا بزند.
- ایمیج داکر vLLM را فقط از داکرهاب یا میرورهای نامبرده بگیرید و digest آن را با صفحهٔ رسمی مقایسه کنید.
برای شرکتها و سازمانها
برای سرور شرکت: میسترال حداقل ۴ کارت H100، ۲ کارت H200 یا یک DGX B200 را اعلام کرده و دستورالعمل vLLM روی ۲ کارت H200 یا B200 با سقف ۱۲۸ درخواست همزمان تنظیم شده است. چون فقط حدود ۶٫۵ میلیارد پارامتر در هر توکن فعال است، چنین سروری میتواند به چند ده کاربر همزمان جواب بدهد (برآورد ما؛ عدد رسمی نیست). یک مک یا کامپیوتر ۱۲۸ گیگابایتی با نسخهٔ ۴ بیتی فقط برای یک یا دو کاربر مناسب است.
برنامههایی که این مدل را اجرا میکنند
 الام استودیو
 لاما سیپیپی
 ویالالام
 لوکالایآی
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۴ اسفند ۱۴۰۴
معرفی: میسترال اسمال ۴ (آفلاین)
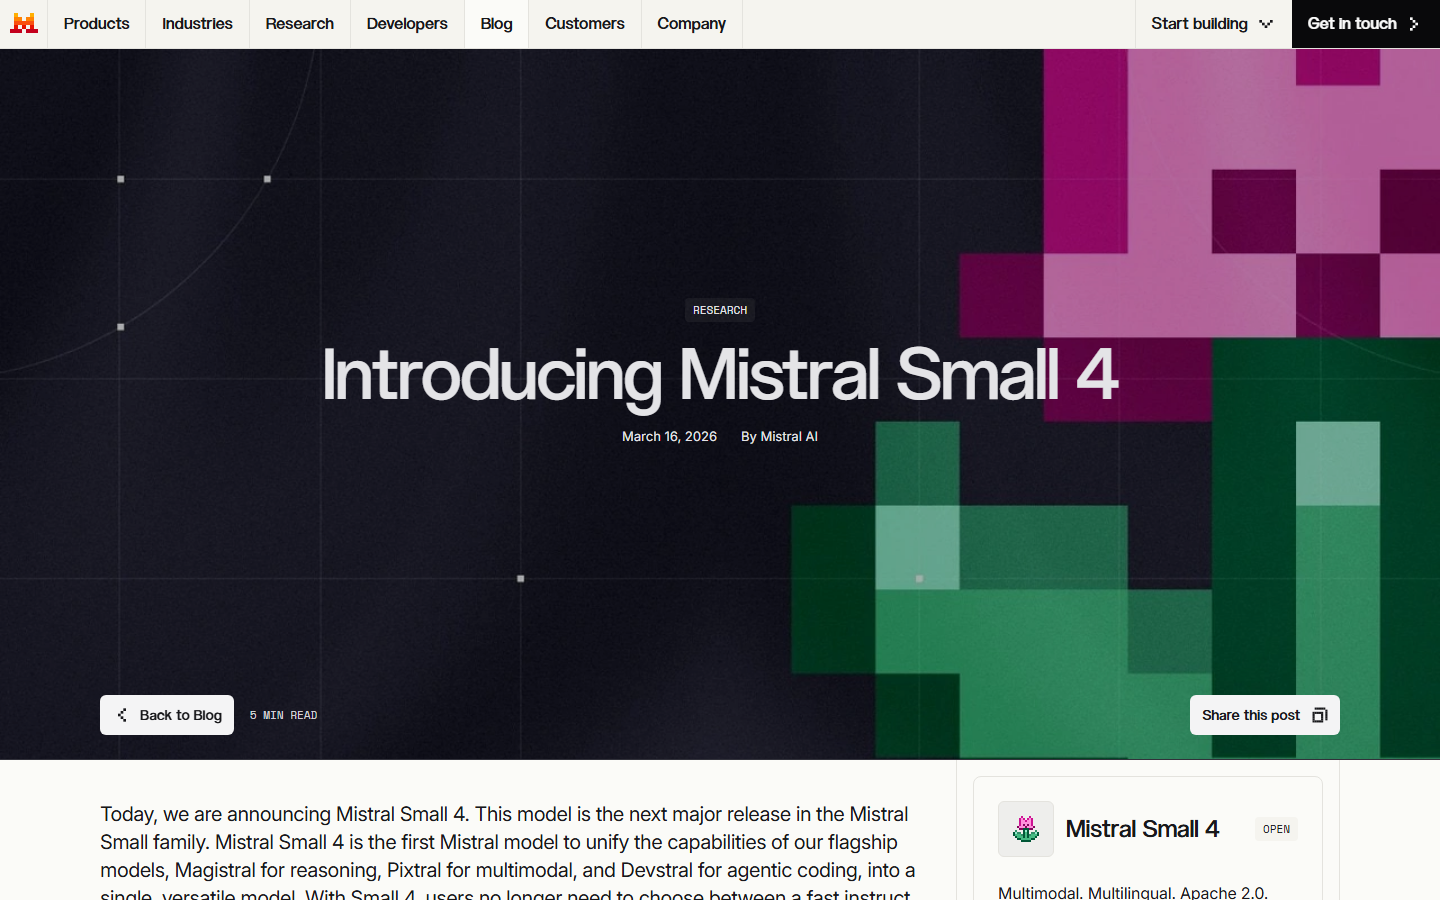
Mistral Small 4 مدل متنباز شرکت فرانسوی میسترال است که ۱۶ مارس ۲۰۲۶ منتشر شد. ۱۱۹ میلیارد پارامتر دارد، اما در هر توکن فقط حدود ۶٫۵ میلیارد پارامتر کار میکند (معماری MoE). چت معمولی، استدلال مرحلهبهمرحله، برنامهنویسی ایجنتی و خواندن عکس و سند را در یک مدل جمع کرده و پنجرهٔ متنش ۲۵۶ هزار توکن است.
برای شرکتها و تیمهایی ساخته شده که یک دستیار شبیه ChatGPT روی سرور خودشان میخواهند تا داده از شبکه بیرون نرود. مجوز Apache 2.0 استفادهٔ تجاری را کاملاً آزاد گذاشته و فارسی هم در فهرست رسمی ۲۴ زبان مدل هست. حالت استدلال با یک پارامتر (reasoning_effort) روشن و خاموش میشود: جواب سریع برای سؤال ساده، فکر مرحلهبهمرحله برای مسئلهٔ سخت.
این مدل برای لپتاپ نیست. نسخهٔ ۴ بیتی حدود ۷۲ گیگابایت است و دستکم حدود ۸۹ گیگابایت حافظهٔ آزاد میخواهد (برآورد)؛ یعنی یک مک یا کامپیوتر ۱۲۸ گیگابایتی. برای سرور چندکاربره، میسترال حداقل ۴ کارت H100، ۲ کارت H200 یا یک DGX B200 را اعلام کرده و دستورالعمل رسمی vLLM روی دو کارت H200 یا B200 اجرا میشود.
برای شروع روی یک دستگاه قوی، سادهترین راه LM Studio است. روی سرور، vLLM را نصب کنید و با دستور رسمی یک API سازگار با OpenAI بالا بیاورید تا برنامههایی مثل Open WebUI به آن وصل شوند.
ایراد اصلی حجم است: مخزن رسمی حدود ۲۴۲ گیگابایت است، چون همان وزنها را در دو قالب دارد، و مدل در کتابخانهٔ رسمی Ollama هم نیست. کیفیت فارسیاش هم با آزمون منتشرشدهای سنجیده نشده است.
بهترین کاربردها
- •روی سرور شرکت یک ChatGPT داخلی راه بیندازم که داده بیرون نرود
- •یک مدل متنباز با مجوز تجاری آزاد برای چتبات فارسی شرکت میخواهم
- •بدون اینترنت قراردادها و گزارشهای طولانی شرکت را خلاصه کنم
- •روی کامپیوتر یا مک ۱۲۸ گیگابایتی یک مدل قوی آفلاین با فهم تصویر اجرا کنم
- •از روی عکس یا اسکن فاکتور، اطلاعات را آفلاین استخراج کنم
- •یک ایجنت برنامهنویسی را به مدل محلی روی سرور داخلی وصل کنم
- •برای تیم پشتیبانی یک دستیار داخلی بسازم که به سؤالها جواب بدهد
- •در یک مدل آفلاین بین جواب سریع و استدلال عمیق جابهجا شوم
برای این کارها سراغش نروید
- –ساخت یا ویرایش تصویر (فقط عکس را میخواند)
- –اجرا روی لپتاپ یا کامپیوتر ۱۶ یا ۳۲ گیگابایتی
- –تبدیل گفتار به متن یا ساخت صدا
- –تحلیل فایل ویدیو
تصاویر محیط ابزار
نقاط قوت
- ✓مجوز Apache 2.0؛ استفادهٔ تجاری بدون شرط خاص
- ✓فارسی در فهرست رسمی زبانهای کارت مدل هست
- ✓چت، استدلال، برنامهنویسی و خواندن عکس در یک مدل؛ حالت استدلال با یک پارامتر عوض میشود
- ✓فقط حدود ۶٫۵ میلیارد پارامتر فعال در هر توکن؛ برای اندازهاش سریع است
- ✓پنجرهٔ متن ۲۵۶ هزار توکنی برای اسناد طولانی
- ✓پشتیبانی رسمی در vLLM، SGLang، llama.cpp و LM Studio
نقاط ضعف
- ✗حتی نسخهٔ ۴ بیتی حدود ۷۲ گیگابایت است و دستکم حدود ۸۹ گیگابایت حافظه (برآورد) میخواهد؛ برای سرور چندکاربره میسترال حداقل ۴ کارت H100 یا ۲ کارت H200 را اعلام کرده است
- ✗در کتابخانهٔ رسمی Ollama نیست
- ✗آزمون فارسی منتشر نشده و کیفیت فارسیاش سنجیده نیست
- ✗مخزن رسمی حدود ۲۴۲ گیگابایت است، چون همان وزنها را در دو قالب دارد
- ✗تصویر نمیسازد و صدا و ویدیو را نمیفهمد
پرسشهای پرتکرار
با چه سختافزاری اجرا میشود؟
نسخهٔ ۴ بیتی (حدود ۷۲ گیگابایت) روی دستگاهی با حدود ۹۰ گیگابایت حافظهٔ آزاد اجرا میشود؛ مثلاً مک یا کامپیوتر ۱۲۸ گیگابایتی. برای سرور چندکاربره، میسترال حداقل ۴ کارت H100، ۲ کارت H200 یا یک DGX B200 را اعلام کرده است. لپتاپ معمولی کافی نیست.
فارسی بلد است؟
فارسی در فهرست رسمی ۲۴ زبان کارت مدل آمده است. آزمون فارسی رسمی منتشر نشده، پس برای کار حساس اول با نمونههای خودتان امتحان کنید.
استفادهٔ تجاری آزاد است؟
بله. مجوز Apache 2.0 است و برای کار تجاری هم آزاد است؛ فقط متن مجوز را همراه نسخهای که پخش میکنید نگه دارید.
با Ollama اجرا میشود؟
در کتابخانهٔ رسمی Ollama نیست. روی دستگاه شخصی سادهترین راه LM Studio است و روی سرور vLLM.
واقعاً آفلاین کار میکند؟
بله. بعد از دانلود، vLLM یا LM Studio بدون اینترنت اجرا میشود و دادهای از شبکه بیرون نمیرود.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
کوئن ۳.۵ (آفلاین)
Qwen3.5 (offline)
خانوادهٔ مدل باز علیبابا که فارسی در فهرست رسمی زبانهایش است؛ از 0.8B برای لپتاپ ضعیف تا 35B-A3B برای سیستم قوی، با فهم تصویر، حافظهٔ متنی ۲۶۲ هزار توکنی و مجوز Apache 2.0.

چتجیپیتی
ChatGPT
شناختهشدهترین دستیار هوش مصنوعی؛ چت و نگارش فارسی، ساخت و ویرایش عکس با Images 2.5، پژوهش عمیق، Codex و ChatGPT Work — با چت متنی نامحدود در پلن رایگان (GPT-5.6 Luna).
جما ۴ (آفلاین)
Gemma 4 (offline)
خانوادهٔ مدل باز گوگل که روی لپتاپ یا کامپیوتر خودتان و بدون اینترنت اجرا میشود: چت، خلاصهنویسی، کدنویسی و فهم تصویر در پنج اندازه از E2B تا 31B، با مجوز آزاد Apache 2.0.