لوکالایآی
LocalAIمحصول پروژهٔ لوکالایآی
جایگزین خودمیزبان API اوپنایآی: متن، تصویر، گفتار و بردارسازی را با یک API روی سرور یا کامپیوتر خودتان اجرا میکند، حتی بدون کارت گرافیک. رایگان و متنباز (MIT).
معرفی: لوکالایآی
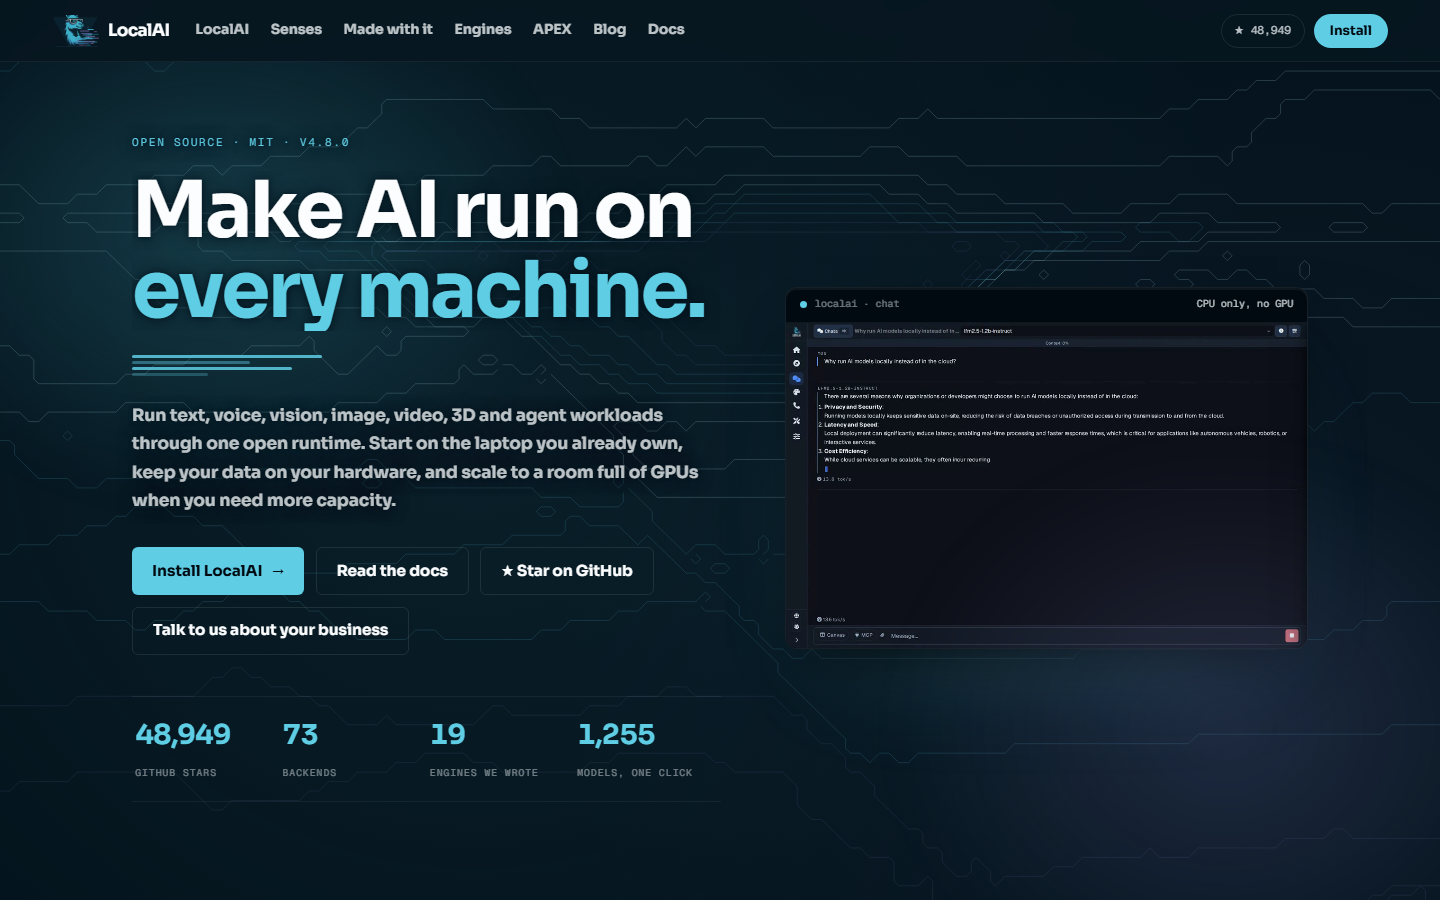
LocalAI یک سرور هوش مصنوعی همهکاره است که همان API اوپنایآی (و Anthropic و ElevenLabs) را روی دستگاه خودتان پیاده میکند؛ یعنی برنامهای که برای ChatGPT نوشته شده، با عوض کردن آدرس به مدل محلی وصل میشود. چت، دیدن تصویر، ساخت تصویر، گفتار به متن، متن به گفتار و بردارسازی را یکجا دارد.
هستهٔ کوچکی دارد و موتورهای اجرا (llama.cpp، vLLM، whisper.cpp، stable-diffusion و…) را فقط وقتی لازم شد دانلود میکند. رابط وب، گالری مدل، عاملها و مدیریت کاربر با کلید API و نقشها هم دارد. نسخهٔ 4.11.0 (۲ اکتبر ۲۰۲۶) «صحنههای صوتی» (رونویسی، تشخیص گوینده و صداهای محیط، با بهخاطرسپردن نام گویندهها)، زنجیرهٔ جایگزینی مدل (مدل محلی و راه دور پشت یک نام)، پیوست PDF در چت و ساخت انیمیشن سهبعدی از متن با Kimodo را اضافه کرد.
بدون کارت گرافیک هم کار میکند؛ برای یک مدل ۴ میلیارد پارامتری روی CPU حدود ۸ گیگابایت رم کافی است (تخمینی). با کارت انویدیا، AMD، اینتل، Vulkan یا مک اپل سیلیکون سریعتر میشود.
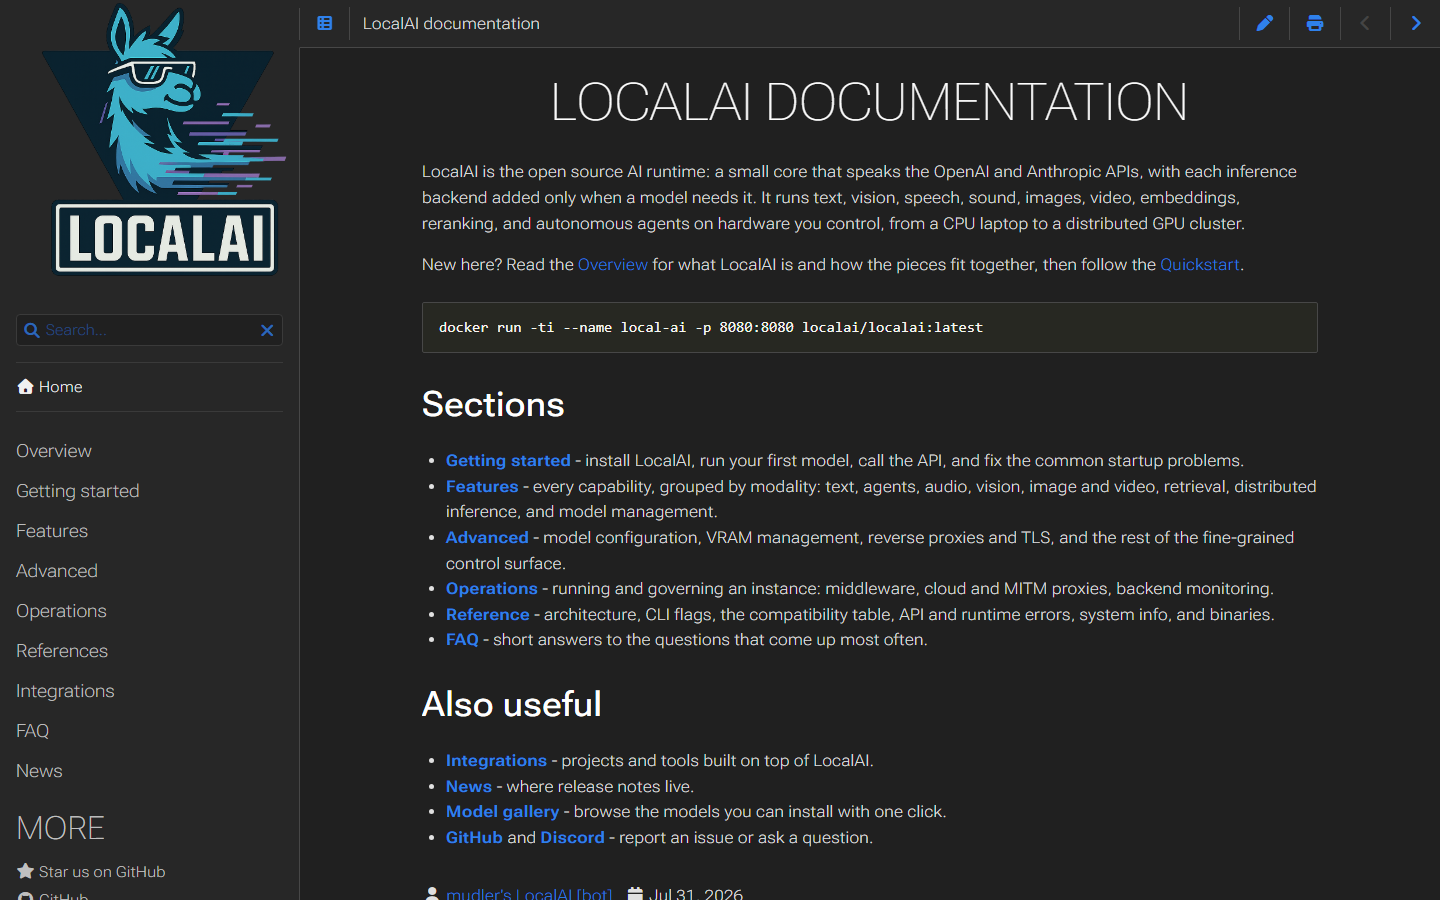
روی لینوکس فایل اجرایی را از گیتهاب بگیرید و ./local-ai run qwen3.5-9b را بزنید؛ روی مک فایل DMG هست و روی ویندوز از Docker یا WSL استفاده کنید. رابط وب روی http://localhost:8080 باز میشود.
نکته: موتورها بار اول از quay.io یا Docker Hub و مدلها از Hugging Face دانلود میشوند. رابط فارسی ندارد و اگر کلید API نگذارید، API برای همه باز است.
بهترین کاربردها
- •روی سرور خودمان بدون کارت گرافیک یک API سازگار با OpenAI راه بیندازم
- •برنامهای که با API اوپنایآی نوشته شده را به مدل محلی و آفلاین وصل کنم
- •روی سرور شرکت هم چت و هم گفتار به متن و متن به گفتار آفلاین داشته باشم
- •بدون اینترنت متن فارسی را با صدای Piper به گفتار تبدیل کنم
- •برای RAG شرکت روی سرور داخلی API بردارسازی محلی داشته باشم
- •روی سرور بدون GPU یک مدل زبانی کوچک اجرا کنم
- •برای کارمندان روی سرور داخلی کلید API جدا با سهمیهٔ مصرف تعریف کنم
برای این کارها سراغش نروید
- –کاربری که فقط یک برنامهٔ چت ساده روی لپتاپ میخواهد
- –ویرایش حرفهای تصویر با بوم نقاشی
- –کاربر ویندوزی که نمیخواهد Docker یا WSL نصب کند
اجرا روی سیستم خودتان
این برنامه را روی سیستم خودتان نصب میکنید و هوش مصنوعی روی همان دستگاه اجرا میشود؛ متن و فایلهایتان از آن بیرون نمیرود.
- بعد از نصب، بدون اینترنت
- متنباز
- MIT — استفادهٔ تجاری آزاد
- رابط وب
- API
- خط فرمان
بعد از نصب موتورها و مدلها کاملاً آفلاین است. بار اول هر موتور اجرا از quay.io (یا آینهٔ Docker Hub) و مدلهای گالری معمولاً از Hugging Face دانلود میشوند؛ برای سرور بدون اینترنت، پوشههای models و backends را از دستگاهی دیگر منتقل کنید (--models-path و --backends-path).
آزاد برای کار تجاری؛ مجوز هر مدل گالری جداست.
سختافزار لازم
- حداقل رم: ۸ گیگابایت — پیشنهادی: ۱۶ گیگابایت
- کارت گرافیک اختیاری است
- ۸ گیگابایت تخمینی برای یک مدل کوچک 4B روی CPU (فایل Qwen3.5 4B حدود ۳٫۴ گیگابایت × ۱٫۲ + سیستمعامل). با GPU انویدیا (CUDA 12/13)، AMD، اینتل، Vulkan یا اپل سیلیکون سریعتر است. هر موتور و مدل فضای دیسک جدا میگیرد.
نصب و اجرا
- ۱
فایل اجرایی را دانلود کنید (لینوکس)لینوکس
curl -Lo local-ai https://github.com/mudler/LocalAI/releases/download/v4.11.0/local-ai-v4.11.0-linux-amd64 && chmod +x local-aiبرای ARM فایل linux-arm64 را بگیرید؛ فایل checksums در همان صفحهٔ نسخه هست.
- ۲
با کلید API یک مدل اجرا کنیدلینوکس
LOCALAI_API_KEY=CHANGE_ME ./local-ai run qwen3.5-9bمدل و موتور llama.cpp بار اول دانلود میشوند؛ رابط وب روی http://localhost:8080 باز میشود.
- ۳
مک: نصب DMGمک
sudo xattr -d com.apple.quarantine /Applications/LocalAI.appLocalAI.dmg را از گیتهاب نصب کنید؛ امضای اپل ندارد و بعد از نصب این دستور لازم است.
- ۴
ویندوز یا سرور: Docker
docker run -ti --name local-ai -p 8080:8080 -e LOCALAI_API_KEY=CHANGE_ME localai/localai:latestاگر Docker Hub باز نشد، میرور آن (آروان، ایرانسرور یا لیارا) را در daemon.json تنظیم کنید و چکسام را بررسی کنید؛ برای کارت انویدیا تگ latest-gpu-nvidia-cuda-12 را بگیرید.
- ۵
انتقال به سرور آفلاینلینوکس
./local-ai run --models-path /srv/localai/models --backends-path /srv/localai/backendsپوشههای models و backends را از دستگاهی که اینترنت دارد کپی کنید.
دانلود
- GitHub Releases (لینوکس و مک) ↗رسمی
فایل اجرایی linux-amd64، linux-arm64 و LocalAI.dmg
- Docker Hub: localai/localai ↗رسمی
- گالری مدلها ↗رسمی
نکات امنیتی
- اگر نه کلید API تنظیم کنید نه سیستم کاربری، همهٔ مسیرها بدون احراز هویت باز میمانند؛ LOCALAI_API_KEY را بگذارید.
- بهطور پیشفرض روی همهٔ کارتهای شبکه (پورت 8080) گوش میدهد؛ پورت را به اینترنت باز نکنید و پشت پراکسی HTTPS بگذارید.
- کلیدهای قدیمی (legacy) دسترسی کامل مدیر میدهند؛ برای چند کاربر از سیستم کاربری با نقش استفاده کنید.
- با LOCALAI_REQUIRE_BACKEND_INTEGRITY=1 بررسی یکپارچگی موتورهای دانلودی اجباری میشود.
- نسخهٔ 4.11.0 چند اصلاح امنیتی دارد (محدود کردن مسیر فایل در گالری و API و بررسی سختگیرانهتر اعتبارنامه)؛ سرورهای قدیمیتر را بهروز کنید.
برای شرکتها و سازمانها
برای سرور سازمانی مناسب است: کاربران و نقشها، ورود OIDC، سهمیهٔ مصرف برای هر کلید و کاربر، و حالت توزیعشده روی چند گره. همهٔ کارهای متنی، صوتی و تصویری را هم پشت یک API جمع میکند.
مدلهایی که با این برنامه اجرا میشوند
 کوئن ۳.۵ (آفلاین)
 جما ۴ (آفلاین)
 زد ایمیج توربو (آفلاین)
 پایپر (آفلاین)
 جیپیتی اواساس (آفلاین)
 میسترال اسمال ۴ (آفلاین)
 کوئن ۳ امبدینگ (آفلاین)
 بیجیای ام۳ (آفلاین)
آخرین بررسی: ۱۲ مهر ۱۴۰۵
تصاویر محیط ابزار
نقاط قوت
- ✓یک API سازگار با OpenAI برای متن، تصویر، گفتار و بردارسازی
- ✓اجرا روی CPU بدون کارت گرافیک، و پشتیبانی از انویدیا، AMD، اینتل و مک
- ✓گالری بزرگ مدل با نصب یکدستوری (Qwen3.5، Gemma 4، Whisper، Piper…)
- ✓صداهای فارسی Piper برای متن به گفتار در گالری
- ✓کلید API، کاربران و نقشها، ورود OIDC، سهمیهٔ مصرف و حالت توزیعشده
- ✓مجوز MIT
نقاط ضعف
- ✗برای مدلهای بزرگتر و ساخت تصویر عملاً کارت گرافیک لازم است؛ روی CPU فقط مدلهای کوچک (حدود 4B با ۸ گیگابایت رم، تخمینی) رواناند
- ✗موتورها و مدلها بار اول از quay.io، Docker Hub و Hugging Face دانلود میشوند
- ✗رابط کاربری فارسی ندارد
- ✗نسخهٔ بومی ویندوز ندارد (Docker یا WSL)
- ✗بدون تنظیم کلید API یا سیستم کاربری، همهٔ مسیرها بدون احراز هویت باز است
پرسشهای پرتکرار
LocalAI با Ollama چه فرقی دارد؟
LocalAI همهکارهتر است: علاوه بر چت، ساخت تصویر، گفتار به متن، متن به گفتار و بردارسازی را با یک API سازگار با OpenAI میدهد و مدیریت کاربر و کلید API دارد. Ollama برای استفادهٔ شخصی سادهتر است.
بدون کارت گرافیک کار میکند؟
بله، اجرای CPU رسمی است. مدلهای کوچک مثل Qwen3.5 4B روی CPU قابل استفادهاند؛ برای مدلهای بزرگتر و ساخت تصویر کارت گرافیک لازم است.
فارسی را پشتیبانی میکند؟
رابطش فارسی ندارد، اما فارسی به مدل بستگی دارد: مدلهای چندزبانه مثل Qwen3.5 و Gemma 4 را میشود اجرا کرد و در گالری چند صدای فارسی Piper (fa_IR) برای متن به گفتار هست.
برای چند کاربر در شرکت مناسب است؟
بله. کلید API، کاربران با نقش، ورود OIDC، سهمیهٔ مصرف و حالت توزیعشده روی چند سرور دارد. حتماً احراز هویت را روشن کنید؛ بدون آن API برای هر کسی در شبکه باز است.
مجوزش برای کار تجاری آزاد است؟
بله، MIT است. مجوز هر مدلی که از گالری نصب میکنید جداست.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
اولاما
Ollama
ابزار متنباز و رایگان برای اجرای مدلهای باز مثل Qwen3.5 و Gemma 4 روی ویندوز، مک و لینوکس: با یک دستور مدل را میگیرد و اجرا میکند، برنامهٔ چت دارد و API محلی روی پورت ۱۱۴۳۴ میدهد.
الام استودیو
LM Studio
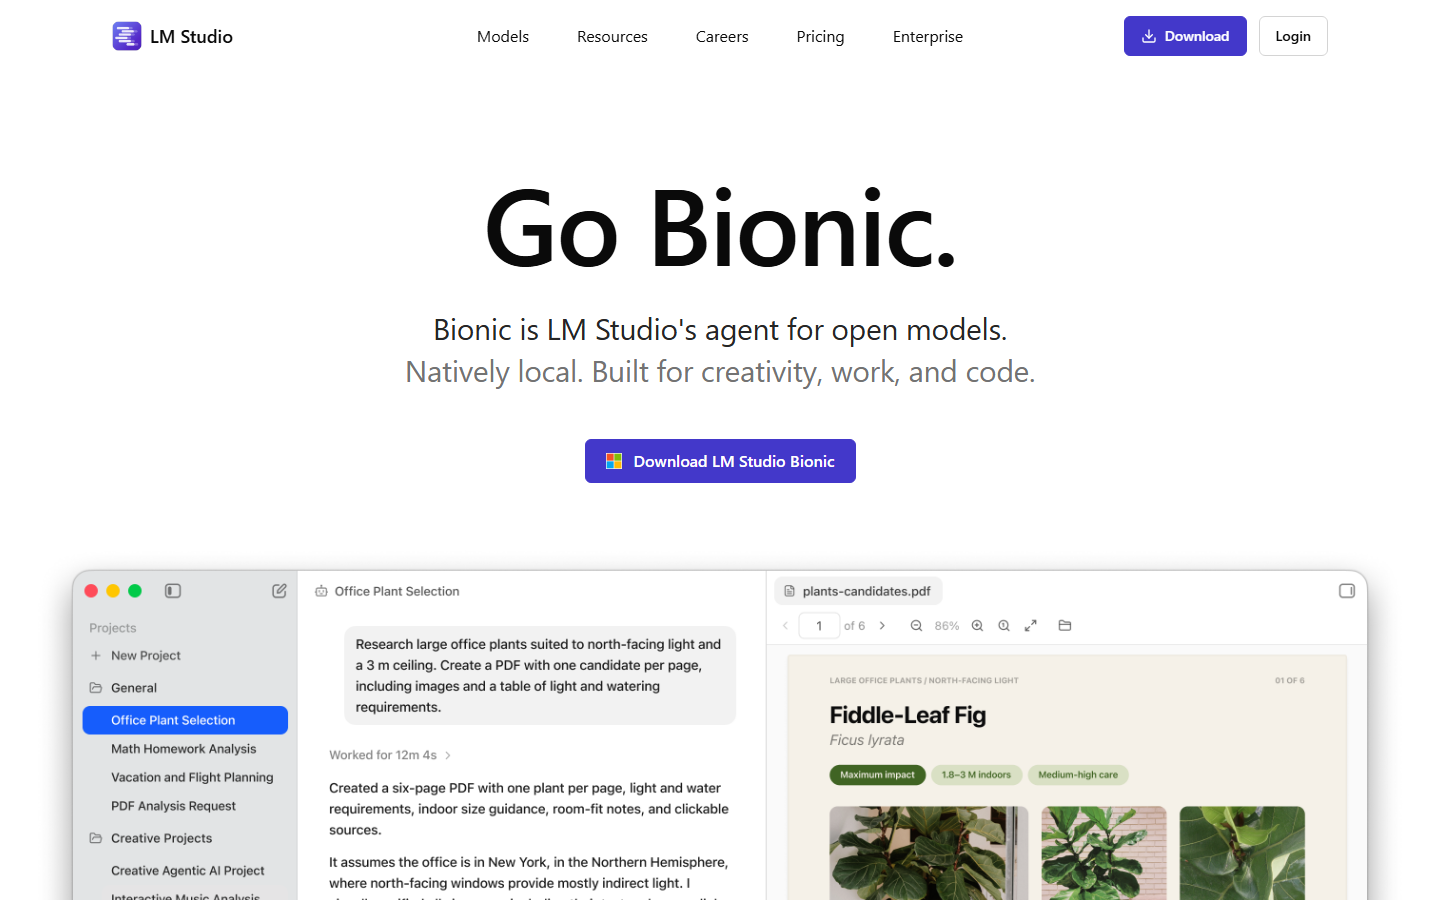
برنامهٔ رایگان ویندوز، مک و لینوکس برای دانلود و اجرای مدلهای زبانی روی کامپیوتر خودتان: چت آفلاین، گفتوگو با اسناد، سرور API سازگار با OpenAI و ایجنت Bionic برای کار و کدنویسی.
گوگل ایآی استودیو
Google AI Studio
محیط رایگان گوگل با Gemini: تست پرامپت، API — و یکی از بهترین مسیرهای متنبهگفتار رایگان با کمترین محدودیت (Gemini 3.8 Flash TTS).