کوئن ۳.۸ 27B (آفلاین)
Qwen3.8-27B (offline)قویترین مدل ۲۷ میلیاردی Qwen (اوت ۲۰۲۶) برای کارت گرافیک ۲۴ گیگابایتی: کدنویسی ایجنتی، کار با سند و تصویر و استدلال، طبق جدول Qwen نزدیک به Qwen3.7-Plus آنلاین، با مجوز Apache 2.0.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- Apache-2.0 — استفادهٔ تجاری آزاد
- فارسی: متوسط
بعد از دانلود کاملاً آفلاین کار میکند؛ Ollama برای این مدل برچسب cloud ندارد.
استفادهٔ تجاری، تغییر و بازنشر آزاد است؛ اگر مدل را بازنشر میکنید، متن مجوز را همراهش بگذارید.
نسخهها و سختافزار لازم
- 27B۲۷٫۸Bطول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۱۸ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۲۲ گیگ یا رم ۲۴ گیگ
ollama run qwen3.8:27bبرآورد. برچسب پیشفرض با پیشبینی چندتوکنی (MTP) برای سرعت است و روی مک برچسب qwen3.8:27b-mlx (۱۸ گیگابایت) هم هست. اگر کارت گرافیک ۸ تا ۱۶ گیگابایتی دارید، نسخههای فشردهٔ پایین همین جدول را ببینید.
- GSQ-RCO IQ3_S۲۷٫۸Bطول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۱۱٫۸ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۱۴ گیگ یا رم ۱۸ گیگ
نسخهٔ فشردهای که آزمایشگاه DASLab مؤسسهٔ علم و فناوری اتریش (سازندگان روش معروف GPTQ) ساخته است، با همان مجوز Apache 2.0. فایل GGUF معمولی است و بدون تغییر در llama.cpp و Ollama اجرا میشود. سازنده آن را «بدون افت» میداند (مثلاً GPQA از ۸۹٫۹ به ۸۹٫۴)، ولی فقط روی سه آزمون استدلال سنجیده و مقایسهٔ مستقیمی با نسخهٔ ۴ بیتی معمولی منتشر نشده است. مناسب کارت ۱۶ گیگابایتی؛ با کارت ۸ گیگ و ۳۲ گیگ رم هم اجرا میشود ولی کند (کاربران حدود ۴ توکن در ثانیه گفتهاند). نسخههایی با همین نام از فرستندههای دیگر، بهویژه «بدون سانسور»، کار این آزمایشگاه نیستند.
- GSQ-RCO IQ2_XS۲۷٫۸Bطول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۸٫۴ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۱۰ گیگ یا رم ۱۳ گیگ
کوچکترین نسخهٔ همان آزمایشگاه، برای کارت ۱۲ گیگابایتی. کمی کیفیت از دست میدهد (در جدول سازنده LiveCodeBench از ۸۵٫۷ به ۷۶٫۶) ولی از نسخههای همحجم دیگر بهتر است. نسخههای میانی IQ2_S (۹٫۳ گیگ) و IQ3_XXS (۱۰٫۱ گیگ) هم در همان مخزن هست.
- Ternary Bonsai 2 27Bطول متن ۲۵۶ هزار توکن
پیشرفته. نسخهٔ غیررسمی از شرکت آمریکایی PrismML (۱۷ سپتامبر ۲۰۲۶، Apache 2.0) که مدل را دوباره آموزش داده تا هر وزن فقط −۱، ۰ یا +۱ باشد (حدود ۱٫۷ بیت بهجای ۱۶). فایل PTQ1_0 ۵٫۹۵ و PQ2_0 (سریعتر) ۷٫۲۱ گیگابایت است و برای ورودی تصویر ۰٫۶۳ گیگ دیگر لازم است؛ با حافظهٔ متنی ۸ تا ۱۶ هزار توکن روی کارت ۸ گیگابایتی جا میشود. سازنده ۹۸٫۲٪ میانگین امتیاز مدل اصلی را اعلام کرده، ولی طبق گزارش خودش در کدنویسی ایجنتی طولانی حدود سهچهارم است (Terminal-Bench ۵۲٫۸ در برابر ۶۹٫۷). کاربران از فکر خیلی طولانی و گاهی گیرکردن در حلقه گفتهاند و ادعای «همسطح Claude Opus» منبعی ندارد. تا ۲۵ سپتامبر ۲۰۲۶ فقط با llama.cpp اختصاصی PrismML یا روی مک با MLX اجرا میشود؛ Ollama، LM Studio، Jan و llama.cpp معمولی هنوز بازش نمیکنند (مرحلهٔ آخر نصب).
نصب و اجرا
- ۱
Ollama را روی ویندوز نصب کنیدویندوز
irm https://ollama.com/install.ps1 | iexاین دستور را در PowerShell بزنید (ویندوز ۱۰ به بعد). فایل نصبی OllamaSetup.exe هم در صفحهٔ دانلود Ollama و بخش Releases گیتهاب آن هست.
- ۲
Ollama را روی لینوکس یا مک نصب کنیدلینوکس
curl -fsSL https://ollama.com/install.sh | shهمین دستور روی مک (macOS 14 به بعد) هم کار میکند؛ روی مک میتوانید فایل نصبی را هم از سایت Ollama بگیرید.
- ۳
مدل را دانلود و اجرا کنید
ollama run qwen3.8:27bحدود ۱۸ گیگابایت دانلود میشود و بعد آفلاین کار میکند. برای جواب سریعتر، در API فیلد think را false بگذارید.
- ۴
یا با LM Studio و Jan
lms get qwen/qwen3.8-27bاول LM Studio را از lmstudio.ai نصب و یکبار باز کنید تا دستور lms کار کند. در Jan هم از تب Hub نام Qwen3.8 را جستوجو و دانلود کنید.
- ۵
نصب کاملاً آفلاین با فایل GGUF
ollama create qwen38-offline -f ModelfileQwen فایل GGUF رسمی نداده؛ فایل Qwen3.8-27B-Q4_K_M.gguf (۱۶٫۸ گیگابایت) از مخزن lmstudio-community/Qwen3.8-27B-GGUF همان است که LM Studio دانلود میکند. آن را منتقل کنید، Modelfile با خط FROM ./Qwen3.8-27B-Q4_K_M.gguf بسازید و این دستور را بزنید (Ollama نسخهٔ ۰٫۳۰ به بعد). این روش متن را راه میاندازد؛ برای ورودی تصویر پوشهٔ مدلهای Ollama را از سیستمی که مدل را pull کرده کپی کنید.
- ۶
کارت ۱۲ تا ۱۶ گیگ: نسخهٔ فشردهٔ GSQ-RCO با llama.cpp
curl -L -O https://huggingface.co/ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF/resolve/main/Qwen3.8-27B-GSQ-RCO-IQ3_S.gguf llama-server -m Qwen3.8-27B-GSQ-RCO-IQ3_S.gguf -ngl 99 -c 16384llama.cpp معمولی را از بخش Releases گیتهاب ggml-org/llama.cpp بگیرید. برای کارت ۱۲ گیگابایتی نام فایل را IQ2_XS بگذارید. بعد http://localhost:8080 را باز کنید. در Ollama هم همین فایل را با Modelfile و دستور ollama create وارد کنید (مرحلهٔ نصب آفلاین).
- ۷
کارت ۸ گیگ (پیشرفته): Ternary Bonsai 2 با llama.cpp اختصاصی PrismML
curl -L -O https://huggingface.co/prism-ml/Ternary-Bonsai-2-27B-gguf/resolve/main/Ternary-Bonsai-2-27B-PTQ1_0.gguf llama-server -m Ternary-Bonsai-2-27B-PTQ1_0.gguf -ngl 99 -fa on -c 16384 -n 16384 --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.05llama-server را از بخش Releases گیتهاب PrismML-Eng/llama.cpp بگیرید (نسخهٔ prism-b10735 یا جدیدتر؛ برای کارت انویدیا فایل cuda-12.4 و فایل cudart کنارش). با llama.cpp معمولی، Ollama یا LM Studio کار نمیکند. اگر حافظه کم آمد، context را کمتر کنید یا -ctk q8_0 -ctv q8_0 را اضافه کنید.
دانلود
- Ollama ↗رسمی
نسخههای ۴ بیتی، ۸ بیتی، کامل و MLX.
- Hugging Face (Qwen) ↗رسمی
وزنهای اصلی؛ نسخهٔ FP8 هم در مخزن جدا هست.
- ModelScope (Qwen) ↗رسمی
مسیر پیشنهادی خود Qwen برای کسانی که به Hugging Face دسترسی ندارند.
- LM Studio ↗غیررسمی
صفحهٔ مدل در LM Studio؛ حداقل ۱۶ گیگابایت حافظه اعلام کرده.
- GGUF (LM Studio Community) ↗غیررسمی
فایلهای GGUF که LM Studio استفاده میکند؛ ساخت Qwen نیست.
- GSQ-RCO (ISTA-DASLab) ↗غیررسمی
نسخههای فشردهٔ ۸٫۴ تا ۱۱٫۸ گیگابایتی؛ کار آزمایشگاه اتریشی، نه Qwen.
- Ternary Bonsai 2 27B (PrismML) ↗غیررسمی
فایلهای ۵٫۹۵ و ۷٫۲۱ گیگابایتی؛ فقط با llama.cpp اختصاصی PrismML.
- llama.cpp نسخهٔ PrismML ↗غیررسمی
فایلهای آمادهٔ ویندوز، لینوکس و مک برای اجرای Bonsai 2.
نکات امنیتی
- پورت 11434 را روی اینترنت باز نکنید: Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و API آن رمز ندارد؛ اگر روی شبکهٔ داخلی لازمش دارید، پشت پروکسی با احراز هویت یا فایروال بگذارید.
- فایل مدل را فقط از منبع رسمی بگیرید، GGUF یا safetensors را به فایلهای pickle (.bin یا .pt) ترجیح دهید و هش SHA256 فایل را با صفحهٔ دانلود مقایسه کنید.
- اگر به مدل اجازهٔ اجرای دستور، دسترسی به فایل یا ابزار میدهید (حالت ایجنت)، کارهای برگشتناپذیر مثل پاککردن و ارسال را فقط با تأیید دستی انجام دهید.
- نسخههای فشرده یا تغییریافتهٔ دیگران (مثل نسخههای سهحالتی یا «بدون سانسور») را پیش از استفاده در محیط کاری جدا آزمون کنید؛ محصول رسمی Qwen نیستند.
برای شرکتها و سازمانها
برای سرور شرکت با چند کاربر، مخزن Qwen سرو با vLLM یا SGLang را پیشنهاد میکند و وزنها را میتوانید از ModelScope بگیرید. روی یک کارت ۲۴ گیگابایتی نسخهٔ ۴ بیتی جا میشود؛ برای حافظهٔ متنی بلند و کاربر همزمان بیشتر، حافظهٔ کارت گرافیک بیشتری لازم است.
برنامههایی که این مدل را اجرا میکنند
 اینفرکس
 اولاما
 الام استودیو
 لاما سیپیپی
 کوبولد سیپیپی
همسطح ابری
 کوئن استودیو
آخرین بررسی: ۱۷ مهر ۱۴۰۵ · انتشار: ۲۴ مرداد ۱۴۰۵
معرفی: کوئن ۳.۸ 27B (آفلاین)
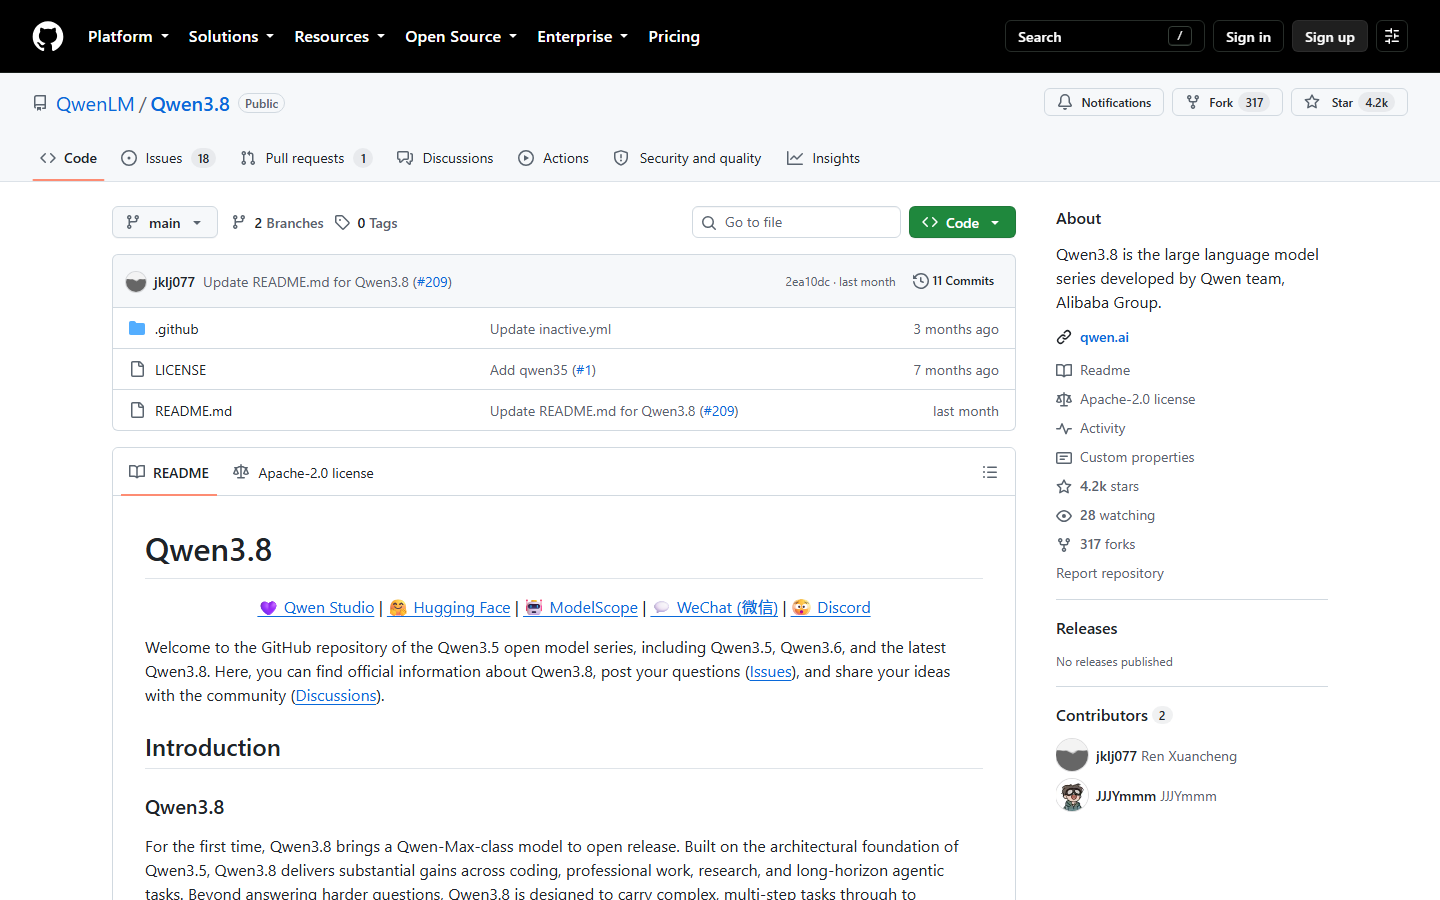
Qwen3.8-27B مدل متراکم ۲۷ میلیاردی (با انکودر تصویر حدود ۲۷٫۸ میلیارد پارامتر) است که ۱۴ اوت ۲۰۲۶ منتشر شد. روی معماری Qwen3.5 ساخته شده، تصویر و ویدئو را میفهمد و حالت فکر کردنش بهطور پیشفرض روشن است.
برای برنامهنویسها، تیمهای فنی و شرکتهایی مناسب است که مدل جدی برای کدنویسی ایجنتی، کار با اسناد و تحلیل تصویر روی سختافزار خودشان میخواهند. در جدول خود Qwen، در بیشتر آزمونهای کدنویسی و ایجنت از Qwen3.7-Plus (مدل آنلاین قبلی Qwen) جلوتر یا نزدیک به آن است.
سختافزار: نسخهٔ ۴ بیتی در Ollama ۱۸ گیگابایت است؛ یعنی کارت گرافیک ۲۴ گیگابایتی یا مک با حدود ۳۲ گیگابایت حافظهٔ یکپارچه. روی پردازنده و ۳۲ گیگابایت رم هم اجرا میشود، ولی خیلی کند. برای کارتهای کوچکتر دو نسخهٔ فشردهٔ غیررسمی هست: GSQ-RCO از آزمایشگاه DASLab اتریش (۸٫۴ تا ۱۱٫۸ گیگابایت، برای کارت ۱۲ تا ۱۶ گیگ، در Ollama و llama.cpp) و Ternary Bonsai 2 از PrismML (۶ تا ۷ گیگابایت، برای کارت ۸ گیگ) که فعلاً فقط با llama.cpp اختصاصی خودش اجرا میشود.
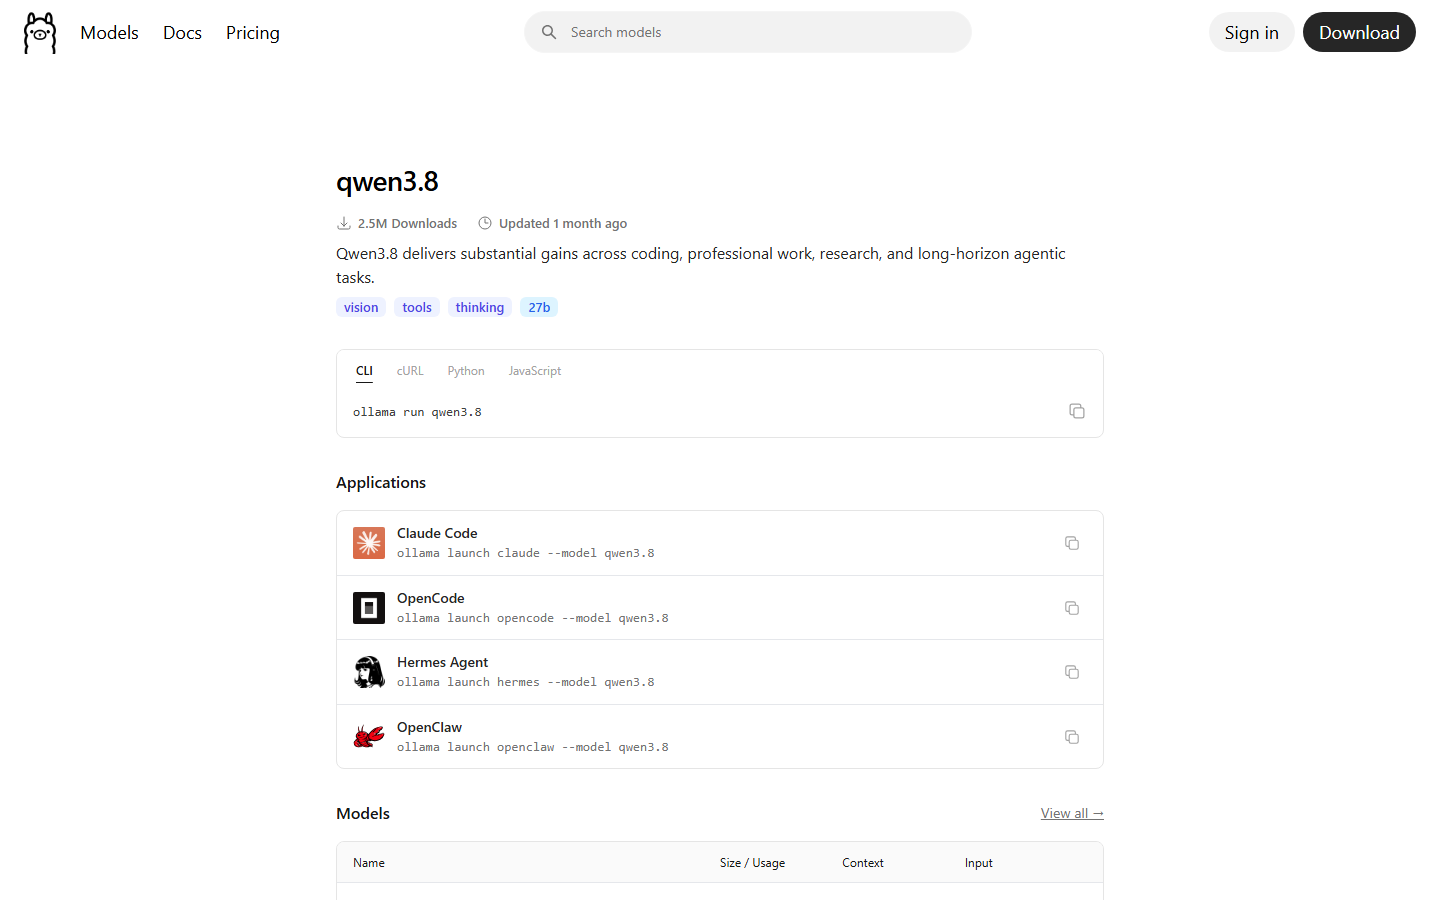
شروع: ollama run qwen3.8:27b یا در LM Studio دستور lms get qwen/qwen3.8-27b. برای مکهای اپل سیلیکون برچسب MLX هم هست.
محدودیتها: بهطور پیشفرض طولانی فکر میکند (سطح فکر روی بالاترین مقدار است) و جواب دیر میرسد؛ برای کارهای ساده فکر کردن را خاموش کنید. کارت مدل فهرست زبان ندارد و فارسی جداگانه آزمون نشده است.
تازهها (اکتبر ۲۰۲۶): Qwen از ۱۴ اوت وزن تازهای برای این مدل منتشر نکرده است. Jan از نسخهٔ 0.8.6 کندی پیشبینی چندتوکنی (MTP) Qwen3.8 را روی کارتهای ۱۲ گیگابایتی رفع کرده است. اگر سیستمی با ۹۶ تا ۱۲۸ گیگابایت حافظه دارید، برادر بزرگتر آن Qwen3.8-Flash-Next (۱۲۵ میلیارد پارامتر که هر بار فقط ۶ میلیاردش کار میکند) در کارهای ایجنتی طولانی قویتر است، مثلاً DeepSWE ۵۸٫۷ در برابر ۴۲٫۲ در جدول خود Qwen؛ برای کارت گرافیک ۲۴ گیگابایتی یا مک ۳۲ گیگابایتی همین مدل ۲۷ میلیاردی انتخاب درست میماند.
بهترین کاربردها
- •روی سرور شرکت یه دستیار برنامهنویسی آفلاین راه بندازم که کد از شبکه بیرون نره
- •با کارت گرافیک ۲۴ گیگ یه ایجنت کدنویسی محلی داشته باشم
- •از روی اسکرینشات یه صفحهٔ وب، بدون اینترنت کد HTML و CSS بسازم
- •یه قرارداد یا سند طولانی رو آفلاین بخونم و به سؤالهام جواب بگیرم
- •نمودار و جدول داخل عکس رو بدون ارسال به سرور خارجی تحلیل کنم
- •باگ یه پروژهٔ برنامهنویسی رو آفلاین پیدا کنم
- •یه جایگزین آفلاین برای Qwen آنلاین روی سیستم خودم داشته باشم
- •برای ایجنتهایی مثل OpenClaw یا Hermes یه مدل محلی قوی بذارم
برای این کارها سراغش نروید
- –اجرا روی لپتاپ معمولی با ۸ یا ۱۶ گیگ رم
- –ساخت تصویر یا ویدئو
- –تبدیل متن به گفتار
- –جستوجوی زنده در اینترنت
تصاویر محیط ابزار
نقاط قوت
- ✓کدنویسی ایجنتی قوی: SWE-bench Pro ۶۱٫۷ و Terminal Bench 2.1 ۷۳٫۰ در جدول Qwen
- ✓فهم تصویر و ویدئو؛ OmniDocBench ۹۱٫۱ برای سند و OSWorld ۸۴٫۳ برای کار با رابط کامپیوتر
- ✓حافظهٔ متنی ۲۶۲ هزار توکنی که تا حدود یک میلیون قابل گسترش است
- ✓مجوز Apache 2.0 و وزنها در Hugging Face و ModelScope
- ✓سطح فکر قابل تنظیم (low، medium، xhigh) و امکان خاموشکردن فکر
نقاط ضعف
- ✗نسخهٔ ۴ بیتی معمولی دستکم حدود ۲۲ گیگابایت حافظهٔ کارت گرافیک میخواهد؛ نسخههای فشردهٔ ۸ تا ۱۲ گیگابایتی (GSQ-RCO، Bonsai 2) کمی کیفیت از دست میدهند و لپتاپ بدون کارت گرافیک جوابگو نیست
- ✗بهطور پیشفرض خیلی طولانی فکر میکند و جواب کند میرسد
- ✗کارت مدل فهرست زبان ندارد و فارسی را جداگانه ارزیابی نکرده
- ✗Qwen فایل GGUF رسمی منتشر نکرده؛ فایلهای GGUF موجود کار جامعهاند
- ✗در Ollama فقط ورودی متن و تصویر فهرست شده و ویدئو نه
پرسشهای پرتکرار
برای Qwen3.8-27B چه سختافزاری لازم است؟
نسخهٔ ۴ بیتی معمولی ۱۸ گیگابایت است و کارت گرافیک ۲۴ گیگابایتی یا مک با ۳۲ گیگابایت حافظهٔ یکپارچه میخواهد. برای کارت ۱۶ گیگابایتی نسخهٔ فشردهٔ GSQ-RCO IQ3_S (۱۱٫۸ گیگ) و برای کارت ۱۲ گیگابایتی IQ2_XS (۸٫۴ گیگ) را بگیرید. روی کارت ۸ گیگابایتی فقط Ternary Bonsai 2 جا میشود که ابزار اختصاصی میخواهد. با لپتاپ ۸ یا ۱۶ گیگ بدون کارت گرافیک، کوئن ۳.۵ 9B یا جما ۴ را امتحان کنید.
Ternary Bonsai 2 و GSQ-RCO که در گروهها معرفی میشوند چیست؟
هر دو نسخهٔ فشردهشدهٔ همین مدلاند، ولی Qwen آنها را نساخته. GSQ-RCO کار آزمایشگاه DASLab اتریش است: فایل GGUF معمولی ۸٫۴ تا ۱۱٫۸ گیگابایتی که در Ollama و llama.cpp اجرا میشود و سازندهاش کیفیت را نزدیک اصل میداند. Ternary Bonsai 2 کار شرکت PrismML است: مدل را دوباره آموزش داده تا ۶ تا ۷ گیگابایت شود و روی کارت ۸ گیگ جا شود. ۹۸٪ امتیاز در آزمونهای خودش را نگه میدارد، ولی در کدنویسی ایجنتی طولانی حدود سهچهارم است. فعلاً فقط با llama.cpp اختصاصی PrismML اجرا میشود و ادعای «همسطح Opus» منبعی ندارد. نسخههای «بدون سانسور» این مدلها را فهرست نمیکنیم.
فارسی را خوب میفهمد؟
Qwen برای این مدل فهرست زبان منتشر نکرده. مدل روی پایهٔ Qwen3.5 ساخته شده که فارسی در فهرست رسمی ۲۰۱ زبانش است، پس انتظار فارسی خوب منطقی است؛ ولی آزمون رسمی فارسی ندارد و بهتر است با کار خودتان امتحانش کنید.
چرا اینقدر دیر جواب میدهد؟
حالت فکر کردن بهطور پیشفرض روشن و روی بالاترین سطح (xhigh) است. در API اولاما فیلد think را false بگذارید یا در برنامهای که استفاده میکنید فکر کردن را خاموش کنید. Qwen میگوید در کارهای ایجنتی چندمرحلهای، کمکردن فکر همیشه کار را زودتر تمام نمیکند.
بدون اینترنت چطور نصبش کنم؟
روی سیستم متصل ollama pull qwen3.8:27b بزنید و پوشهٔ مدلهای Ollama را به سیستم آفلاین ببرید. یا فایل Qwen3.8-27B-Q4_K_M.gguf را یکبار بگیرید، Modelfile با خط FROM ./Qwen3.8-27B-Q4_K_M.gguf بسازید و ollama create بزنید (Ollama نسخهٔ ۰٫۳۰ به بعد).
از کجا دانلودش کنم و استفادهٔ تجاری مجاز است؟
وزنها در Hugging Face و ModelScope (مسیر پیشنهادی Qwen برای کسانی که به Hugging Face دسترسی ندارند) و نسخهٔ آماده در Ollama هست. حجم دانلود حدود ۱۸ گیگابایت است، پس اگر اینترنت ناپایدار است روی سیستم دیگری بگیرید. مجوز Apache 2.0 است و استفادهٔ تجاری آزاد است.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
میمو ۲.۶ (آفلاین)
MiMo-V2.6 (offline)
خانوادهٔ مدلهای باز شیائومی (سپتامبر ۲۰۲۶، مجوز MIT) برای کدنویسی ایجنتی و کار با ابزار: نسخهٔ Distill-Qwen-9B با فایل ۵٫۸ گیگابایتی روی لپتاپ ۱۶ گیگابایتی اجرا میشود و Flash و Pro (به گزارش eWeek، Pro بالاترین مدل باز در شاخص Artificial Analysis) سرور چندکارته میخواهند؛ فارسی آزموده نشده است.
آنتیگرویتی
Google Antigravity
پلتفرم توسعه ایجنتمحور گوگل: IDE دسکتاپ + CLI + SDK؛ نسخه 2.0 (I/O 2026) با ایجنتهای موازی، سندباکس ابری و پلن رایگان واقعی.
کدکس
Codex
ایجنت کدنویسی OpenAI: در ترمینال (CLI)، IDE، وب و حتی موبایل کار میکند؛ کد مینویسد، تست میگیرد، PR میسازد و از ژوئیه ۲۰۲۶ با خانواده GPT-5.6 اجرا میشود.