میمو ۲.۶ (آفلاین)
MiMo-V2.6 (offline)خانوادهٔ مدلهای باز شیائومی (سپتامبر ۲۰۲۶، مجوز MIT) برای کدنویسی ایجنتی و کار با ابزار: نسخهٔ Distill-Qwen-9B با فایل ۵٫۸ گیگابایتی روی لپتاپ ۱۶ گیگابایتی اجرا میشود و Flash و Pro (به گزارش eWeek، Pro بالاترین مدل باز در شاخص Artificial Analysis) سرور چندکارته میخواهند؛ فارسی آزموده نشده است.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- MIT — استفادهٔ تجاری آزاد
- فارسی: نامعلوم
بعد از دانلود فایلها کاملاً بدون اینترنت کار میکند. Ollama برای این مدلها برچسب رسمی ندارد؛ نسخهٔ 9B را یک بار روی سیستم متصل از مسیر hf.co بگیرید و پوشهٔ مدلهای Ollama را به سیستم آفلاین کپی کنید.
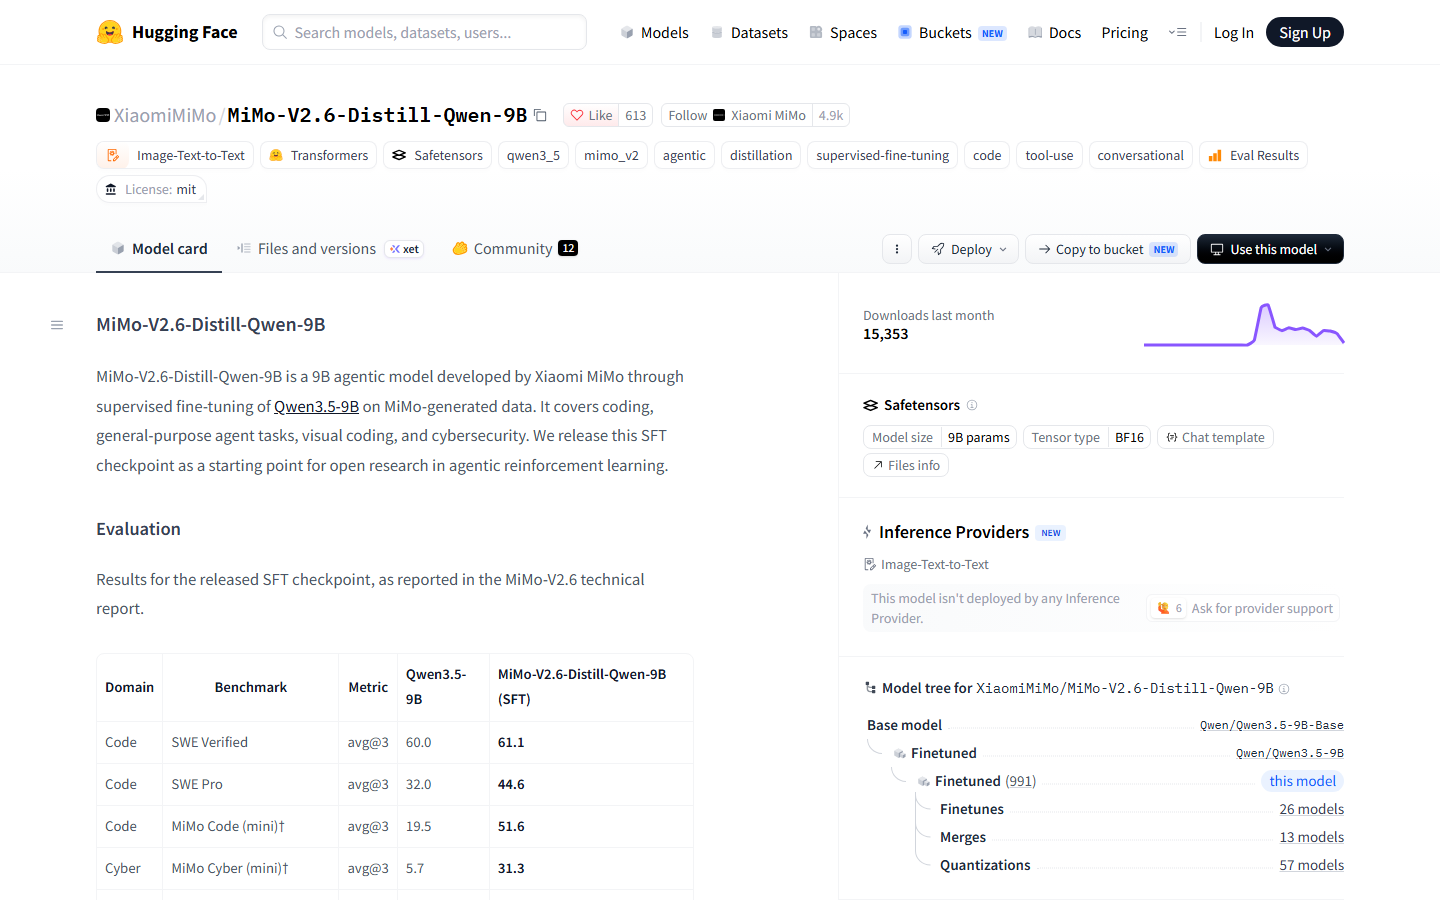
استفادهٔ تجاری، تغییر و بازنشر آزاد است؛ هنگام بازنشر متن مجوز و اعلان حق نشر را همراه کنید. نسخهٔ 9B روی Qwen3.5-9B ساخته شده که مجوزش Apache-2.0 است و آن هم تجاری آزاد است.
نسخهها و سختافزار لازم
- Distill-Qwen-9B۹٫۴Bطول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۵٫۸ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۸ گیگ یا رم ۸ گیگ
ollama run hf.co/bartowski/MiMo-V2.6-Distill-Qwen-9B-GGUF:Q4_K_Mانتخاب لپتاپ. حجمها از GGUF کاربر bartowski است، بهاضافهٔ فایل تصویر (mmproj) ۰٫۹۲ گیگابایت؛ وزن رسمی BF16 ۱۸٫۸ گیگابایت است. با ۸ گیگابایت رم و متن کوتاه اجرا میشود و ۱۶ گیگابایت رم یا کارت ۸ گیگابایتی راحت است. Ollama برچسب رسمی ندارد و این دستور فایل bartowski را مستقیم از Hugging Face میگیرد؛ کارکرد ورودی تصویر از این مسیر تأیید نشده. روی مک نسخهٔ ۴ بیتی MLX در mlx-community هست.
- Flash-MOPD (309B-A15B)۳۰۹B (فعال ۱۵B)طول متن ۱٬۰۰۰ هزار توکن
- حجم دانلود:
- ۱۶۷٫۴ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۲۰۱ گیگ یا رم ۱۹۲ گیگ
GGUF تیم llama.cpp (ggml-org): MXFP4 ۱۶۷٫۴ و Q2_K ۱۲۶٫۲ گیگابایت، بهاضافهٔ mmproj (۱٫۶ تا ۲٫۸ گیگابایت) و فایلهای جانبی MTP و DFlash برای سرعت. وزن اصلی (FP8 و MXFP4) ۱۷۷٫۷ گیگابایت است و نمونهٔ vLLM چهار کارت گرافیک میگیرد. رقم ۱۹۲ گیگابایت حافظهٔ یکپارچه برای GGUF برآوردی از حجم فایل است و تأیید نشده. Ollama برچسب ندارد.
- Pro-MOPD (1.02T-A42B)۱٬۰۲۰B (فعال ۴۲B)طول متن ۱٬۰۰۰ هزار توکن
- حجم دانلود:
- ۵۵۴٫۲ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۶۶۶ گیگ یا رم ۶۶۸ گیگ
GGUF تیم llama.cpp (ggml-org): MXFP4 ۵۵۴٫۲ و Q2_K ۴۱۸٫۸ گیگابایت. دستورالعمل SGLang آن ۱۶ کارت گرافیک (TP16) میگیرد؛ فقط برای مرکز داده. نسخهٔ RL هم هست، ولی MOPD تکرار در فراخوانی ابزار را رفع کرده.
نصب و اجرا
- ۱
Ollama را روی ویندوز نصب کنیدویندوز
irm https://ollama.com/install.ps1 | iexاین دستور را در PowerShell بزنید (ویندوز ۱۰ به بعد). فایل نصبی OllamaSetup.exe هم در صفحهٔ دانلود Ollama و بخش Releases گیتهاب آن هست.
- ۲
Ollama را روی لینوکس یا مک نصب کنیدلینوکس
curl -fsSL https://ollama.com/install.sh | shهمین دستور روی مک (macOS 14 به بعد) هم کار میکند؛ روی مک میتوانید فایل نصبی را هم از سایت Ollama بگیرید.
- ۳
نسخهٔ 9B را دانلود و اجرا کنید
ollama run hf.co/bartowski/MiMo-V2.6-Distill-Qwen-9B-GGUF:Q4_K_Mحدود ۵٫۸ گیگابایت دانلود میشود و بعد آفلاین کار میکند. Ollama برچسب رسمی این مدل را ندارد و این دستور فایل GGUF کاربر bartowski را مستقیم از Hugging Face میگیرد؛ نسخههای دیگری که در Ollama با این نام بارگذاری شدهاند کار سازنده نیستند. اینکه ورودی تصویر از این مسیر کار کند تأیید نشده.
- ۴
یا با LM Studio
LM Studio را از lmstudio.ai نصب کنید و در بخش جستوجوی مدلها MiMo-V2.6-Distill-Qwen-9B را پیدا و دانلود کنید (فایل GGUF با معماری qwen35).
- ۵
یا با llama.cpp و فایل تصویر
llama serve -hf ggml-org/MiMo-V2.6-Distill-Qwen-9B-GGUFمخزن ggml-org فقط نسخهٔ ۸ بیتی (۹٫۵۵ گیگابایت) و فایل تصویر (mmproj) را دارد و قالب چت را هنگام تبدیل اصلاح کرده است؛ رابط وب روی http://127.0.0.1:8080 باز میشود.
- ۶
Flash روی سرور با llama.cppلینوکس
llama serve -hf ggml-org/MiMo-V2.6-Flash-MOPD-GGUF --mtpllama.cpp این معماری را با نام mimo2 پشتیبانی میکند. فایل MXFP4 حدود ۱۶۷ گیگابایت و Q2_K حدود ۱۲۶ گیگابایت است؛ --mtp پیشبینی چندتوکنی را برای سرعت روشن میکند. برای Pro همین دستور با مخزن ggml-org/MiMo-V2.6-Pro-MOPD-GGUF است.
- ۷
Flash روی سرور چندکارته با vLLMلینوکس
docker run --gpus all --ipc=host -p 8000:8000 -v ~/.cache/huggingface:/root/.cache/huggingface vllm/vllm-openai:mimov25-cu129 --model XiaomiMiMo/MiMo-V2.6-Flash-MOPD --tensor-parallel-size 4 --api-key CHANGE_MEکارت مدل میگوید نسخهٔ پایدار vLLM ممکن است عقب باشد و این ایمیج را پیشنهاد میکند. گزینههای parser و فراخوانی ابزار را از کارت مدل بردارید. SGLang از روز انتشار پشتیبانی دارد و دستورش هم در کارت مدل هست.
دانلود
- XiaomiMiMo/MiMo-V2.6-Distill-Qwen-9B ↗رسمی
وزنهای اصلی نسخهٔ 9B (BF16، ۱۸٫۸ گیگابایت) و کارت مدل.
- bartowski GGUF (9B) ↗غیررسمی
فایل Q4_K_M (۵٫۸۴ گیگابایت) که دستور Ollama میگیرد.
- ggml-org GGUF (9B) ↗غیررسمی
از تیم llama.cpp: نسخهٔ Q8_0 و فایل تصویر، با قالب چت اصلاحشده.
- MLX 4-bit (9B, Mac) ↗غیررسمی
نسخهٔ ۴ بیتی جامعهٔ MLX برای مکهای اپل سیلیکون.
- XiaomiMiMo/MiMo-V2.6-Flash-MOPD ↗رسمی
وزنهای Flash (۱۷۷٫۷ گیگابایت) و دستورهای SGLang و vLLM.
- ggml-org GGUF (Flash) ↗غیررسمی
MXFP4 و Q2_K برای llama.cpp، بهاضافهٔ فایلهای MTP و DFlash.
- XiaomiMiMo/MiMo-V2.6-Pro-MOPD ↗رسمی
وزنهای Pro برای مرکز داده.
- وبلاگ رسمی MiMo-V2.6 ↗رسمی
معرفی و جدول عملکرد.
نکات امنیتی
- نسخهٔ 9B عمداً روی دادهٔ امنیت سایبری آموزش دیده و Flash و Pro در آزمونهای حملهٔ سایبری قویترین مدل باز گزارش شدهاند؛ ایجنت را در محیط ایزوله اجرا کنید و دسترسیاش به ابزار و شبکه را محدود کنید.
- قالب چت اصلی 9B ایراد داشت که ggml-org هنگام تبدیل اصلاحش کرده؛ GGUF همان ggml-org یا bartowski را به فایلی که خودتان تبدیل میکنید ترجیح دهید.
- اجرای Flash و Pro با Transformers گزینهٔ trust_remote_code میخواهد که کد مخزن را روی سیستم شما اجرا میکند؛ یک revision مشخص را ثابت کنید.
- پورت 11434 را روی اینترنت باز نکنید: Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و API آن رمز ندارد. سرورهای llama.cpp و vLLM را هم بدون کلید دسترسی (--api-key) روی شبکه باز نکنید.
برای شرکتها و سازمانها
برای سرور شرکت، Flash-MOPD گزینهٔ عملیتر است: SGLang از روز انتشار پشتیبانی دارد و vLLM با ایمیج vllm/vllm-openai:mimov25-cu129 روی چهار کارت گرافیک اجرا میشود. Pro به ۱۶ کارت (TP16) نیاز دارد. مجوز MIT شرط اضافهای برای ارائهٔ سرویس ندارد.
برنامههایی که این مدل را اجرا میکنند
 اولاما
 الام استودیو
 لاما سیپیپی
 ویالالام
همسطح ابری
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۴ شهریور ۱۴۰۵
معرفی: میمو ۲.۶ (آفلاین)
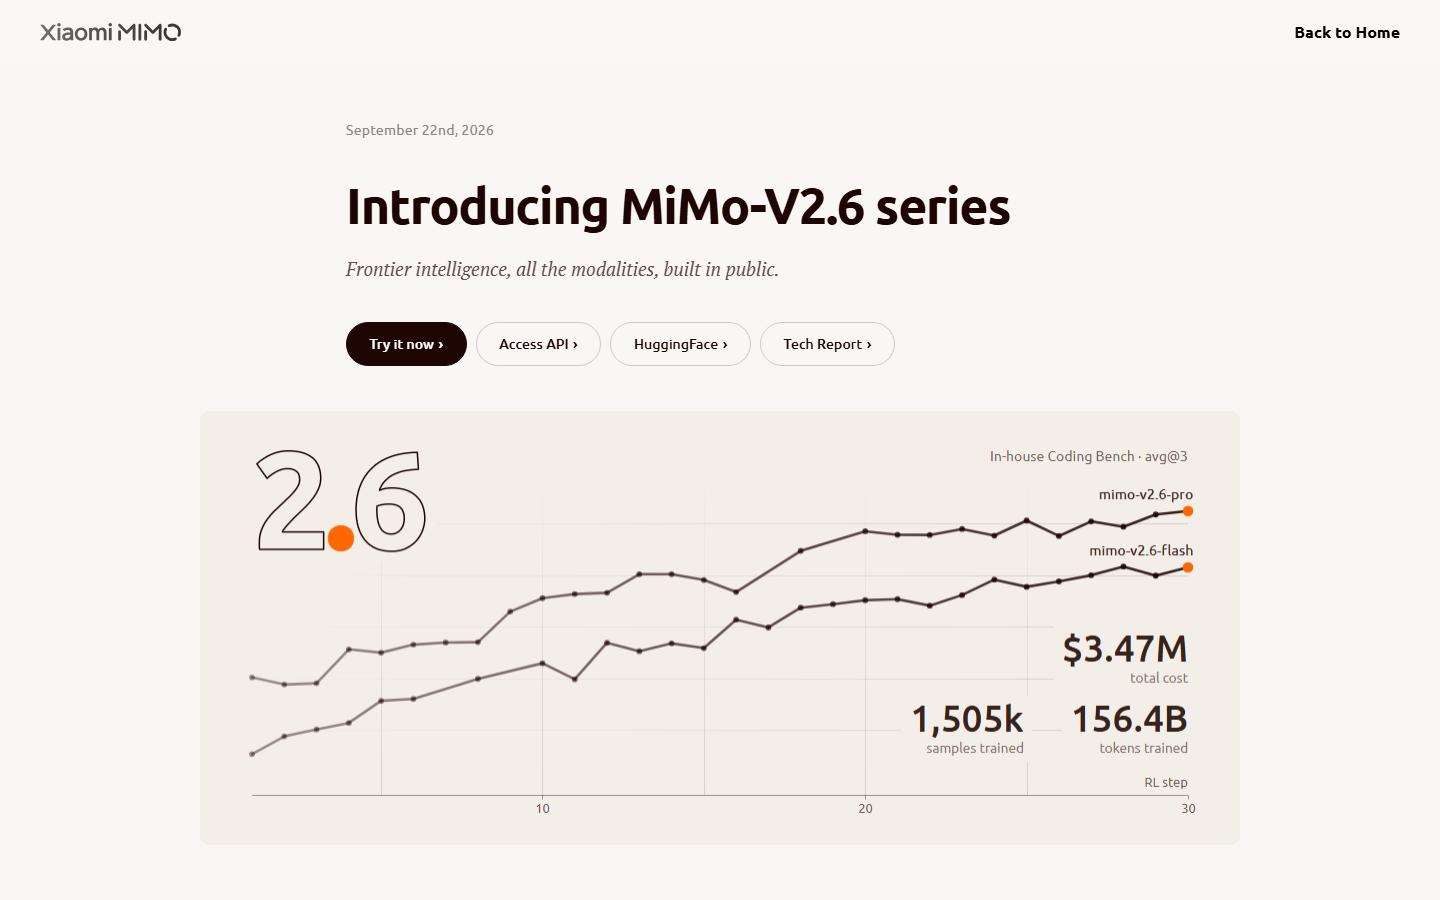
MiMo-V2.6 نسل مدلهای باز تیم MiMo شیائومی است. نسخههای Flash و Pro ۲۱ سپتامبر ۲۰۲۶ منتشر شدند و ۲۷ سپتامبر نسخههای MOPD آمدند که تکرار در فراخوانی ابزار را رفع کردهاند؛ همینها را بگیرید. همزمان نسخهٔ کوچک MiMo-V2.6-Distill-Qwen-9B هم منتشر شد (اعلام رسمی ۲۲ سپتامبر). هر سه مجوز MIT دارند.
کار اصلی این خانواده کدنویسی ایجنتی است: کار در ترمینال، فراخوانی ابزار، کار با کامپیوتر و امنیت سایبری. Flash و Pro متن، تصویر، ویدئو و صدا میگیرند، متن تحویل میدهند و حافظهٔ متنی ۱ میلیون توکنی دارند. در آزمون کار با کامپیوتر OSWorld-Verified، Flash امتیاز ۸۰٫۸ و Pro امتیاز ۸۲٫۰ گرفتهاند. Pro در شاخص هوش Artificial Analysis امتیاز ۴۶ دارد که به گزارش eWeek بالاترین امتیاز بین مدلهای باز است.
نسخهٔ لپتاپی، Distill-Qwen-9B، همان Qwen3.5-9B است که روی ۷۷٫۴ میلیارد توکن دادهٔ ساخت MiMo آموزش تکمیلی (SFT) دیده. در جدول شیائومی امتیاز SWE-bench Pro آن ۴۴٫۶ در برابر ۳۲٫۰ مدل پایه است و Terminal-Bench 2.1 آن ۳۷٫۱ در برابر ۲۷٫۰. متن و تصویر میگیرد و حالت فکر کردن دارد. خود شیائومی آن را نقطهٔ شروعی برای پژوهش باز روی ایجنتها خوانده؛ یعنی چکپوینت پژوهشی است، نه یک چتبات صیقلخورده.
سختافزار: فایل ۴ بیتی 9B (Q4_K_M) ۵٫۸۴ گیگابایت است؛ با ۸ گیگابایت رم و متن کوتاه اجرا میشود و با ۱۶ گیگابایت رم یا کارت گرافیک ۸ گیگابایتی راحت است. Flash ۳۰۹ میلیارد پارامتر دارد که ۱۵ میلیاردش در هر توکن فعال است؛ فایل GGUF آن ۱۲۶ تا ۱۶۷ گیگابایت است و نمونهٔ vLLM آن چهار کارت گرافیک میگیرد. Pro با ۱٫۰۲ تریلیون پارامتر (۴۲ میلیارد فعال) حتی در ۲ بیتی ۴۱۸٫۸ گیگابایت است و فقط برای مرکز داده است.
شروع: Ollama برای این خانواده برچسب رسمی ندارد؛ نسخهٔ 9B را با ollama run hf.co/bartowski/MiMo-V2.6-Distill-Qwen-9B-GGUF:Q4_K_M اجرا کنید یا در LM Studio نامش را جستوجو کنید. Flash و Pro با llama.cpp، vLLM یا SGLang سرو میشوند. محدودیتها: کارت Flash و Pro فقط انگلیسی و چینی را نام برده و کارت 9B فهرست زبان ندارد، پس فارسی آزموده نشده است. 9B عمداً روی دادهٔ امنیت سایبری آموزش دیده و Flash و Pro در آزمونهای حملهٔ سایبری قویترین مدل باز گزارش شدهاند؛ به ایجنت فقط دسترسی محدود بدهید.
بهترین کاربردها
- •روی لپتاپ خودم بدون اینترنت یک ایجنت کدنویسی سبک اجرا کنم
- •آفلاین روی کامپیوتر خودم مدلی برای کار در ترمینال و فراخوانی ابزار داشته باشم
- •مدل باز میمو شیائومی را روی سرور شرکت خودمان سرو کنم
- •روی سرور شرکت یک ایجنت کار با کامپیوتر بدون فرستادن داده به بیرون راه بیندازم
- •با لپتاپ ۱۶ گیگابایتی یک مدل کدنویسی ۹ میلیاردی را آفلاین امتحان کنم
- •مدل کدنویسی ایجنتی با مجوز MIT را روی سختافزار خودمان اجرا کنم
برای این کارها سراغش نروید
- –نوشتن، خلاصه یا ترجمهٔ متن فارسی
- –چتبات عمومی و روزمره
- –اجرای Flash یا Pro روی لپتاپ یا کامپیوتر معمولی
- –ساخت تصویر یا ویدئو
تصاویر محیط ابزار
نقاط قوت
- ✓مجوز MIT در هر سه اندازه؛ استفادهٔ تجاری آزاد
- ✓نسخهٔ 9B در کدنویسی ایجنتی خیلی بهتر از مدل پایه: SWE-bench Pro ۴۴٫۶ در برابر ۳۲٫۰ و Toolathlon-Verified ۳۵٫۲ در برابر ۲۵٫۹
- ✓نسخهٔ 9B با فایل ۴ بیتی ۵٫۸ گیگابایتی روی لپتاپ ۱۶ گیگابایتی راحت اجرا میشود
- ✓Pro با امتیاز ۴۶ در شاخص Artificial Analysis، به گزارش eWeek بالاترین مدل باز
- ✓Flash و Pro: ورودی متن، تصویر، ویدئو و صدا، حافظهٔ متنی ۱ میلیون توکنی و کار با کامپیوتر (OSWorld-Verified بالای ۸۰)
- ✓فایلهای GGUF تیم llama.cpp (ggml-org) و پشتیبانی SGLang از روز انتشار
نقاط ضعف
- ✗نسخهٔ 9B حدود ۶ گیگابایت دانلود و دستکم ۸ گیگابایت رم میخواهد؛ Flash حتی در ۲ بیتی ۱۲۶ گیگابایت است و چند کارت گرافیک میخواهد و Pro فقط برای مرکز داده است
- ✗فارسی آزموده نشده؛ کارت Flash و Pro فقط انگلیسی و چینی را نام برده و کارت 9B فهرست زبان ندارد
- ✗نسخهٔ 9B چکپوینت پژوهشی است و برای گفتوگوی عمومی صیقل نخورده
- ✗Ollama برای هیچکدام برچسب رسمی ندارد؛ 9B از مسیر hf.co اجرا میشود و کارکرد ورودی تصویر در این مسیر تأیید نشده
- ✗دوکاربردی در امنیت سایبری: 9B روی دادهٔ امنیت سایبری آموزش دیده و Flash و Pro در آزمونهای حمله قویترین مدل باز گزارش شدهاند؛ دسترسی ایجنت باید محدود شود
قیمتگذاری
رایگان (وزنهای باز)
Free (open weights)رایگان
- • دانلود و اجرای هر سه اندازه روی سختافزار خودتان
- • استفادهٔ تجاری آزاد با مجوز MIT
قیمتها تقریبی و بر اساس آخرین بازبینی است؛ برای قیمت دقیق به سایت رسمی مراجعه کنید.
پرسشهای پرتکرار
کدام نسخهٔ میمو ۲.۶ روی لپتاپ اجرا میشود؟
فقط MiMo-V2.6-Distill-Qwen-9B. فایل ۴ بیتی آن (Q4_K_M) ۵٫۸۴ گیگابایت است؛ با ۸ گیگابایت رم و متن کوتاه اجرا میشود و با ۱۶ گیگابایت رم یا کارت گرافیک ۸ گیگابایتی راحت است. Flash و Pro صدها گیگابایتاند و سرور میخواهند.
فارسی بلد است؟
آزموده نشده. کارت Flash و Pro فقط انگلیسی و چینی را نام برده و کارت 9B فهرست زبان ندارد؛ دادهٔ آموزشی 9B هم کد، ایجنت، تصویر و امنیت سایبری بوده. مدل پایهٔ آن، Qwen3.5، فارسی را در فهرست رسمی زبانهایش دارد، ولی برای این نسخه آزمون فارسی منتشر نشده. برای نوشتن و خلاصهکردن فارسی، Qwen3.5 مطمئنتر است.
چطور نصبش کنم؟
سادهترین راه: Ollama را نصب کنید و بزنید ollama run hf.co/bartowski/MiMo-V2.6-Distill-Qwen-9B-GGUF:Q4_K_M. در LM Studio هم MiMo-V2.6-Distill-Qwen-9B را جستوجو کنید. با llama.cpp دستور llama serve -hf ggml-org/MiMo-V2.6-Distill-Qwen-9B-GGUF نسخهٔ ۸ بیتی را با فایل تصویر میگیرد. برای سیستم بدون اینترنت، مدل را روی سیستم متصل بگیرید و پوشهٔ مدلهای Ollama را کپی کنید.
برای کار تجاری آزاد است؟
بله. هر سه با مجوز MIT منتشر شدهاند و استفادهٔ تجاری، تغییر و بازنشر آزاد است؛ فقط متن مجوز را همراه نسخهها نگه دارید. نسخهٔ 9B روی Qwen3.5-9B ساخته شده که مجوزش Apache-2.0 است و آن هم تجاری آزاد است.
Flash و Pro چه سختافزاری میخواهند؟
Flash (۳۰۹ میلیارد پارامتر، ۱۵ میلیارد فعال): نمونهٔ vLLM چهار کارت گرافیک میگیرد و فایل GGUF آن در MXFP4 ۱۶۷٫۴ و در Q2_K ۱۲۶٫۲ گیگابایت است؛ حدود ۱۹۲ گیگابایت حافظهٔ یکپارچه برآوردی از حجم فایل است و تأیید نشده. Pro (۱٫۰۲ تریلیون پارامتر): دستورالعمل SGLang آن ۱۶ کارت گرافیک میگیرد و GGUF آن ۴۱۸٫۸ تا ۵۵۴٫۲ گیگابایت است.
فرق نسخههای MOPD و RL چیست؟
نسخههای RL ۲۱ سپتامبر ۲۰۲۶ و نسخههای MOPD ۲۷ سپتامبر منتشر شدند. MOPD مشکل تکرار در فراخوانی ابزار را رفع کرده، پس برای Flash و Pro همین را بگیرید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
کوئن ۳.۸ 27B (آفلاین)
Qwen3.8-27B (offline)
قویترین مدل ۲۷ میلیاردی Qwen (اوت ۲۰۲۶) برای کارت گرافیک ۲۴ گیگابایتی: کدنویسی ایجنتی، کار با سند و تصویر و استدلال، طبق جدول Qwen نزدیک به Qwen3.7-Plus آنلاین، با مجوز Apache 2.0.
آنتیگرویتی
Google Antigravity
پلتفرم توسعه ایجنتمحور گوگل: IDE دسکتاپ + CLI + SDK؛ نسخه 2.0 (I/O 2026) با ایجنتهای موازی، سندباکس ابری و پلن رایگان واقعی.
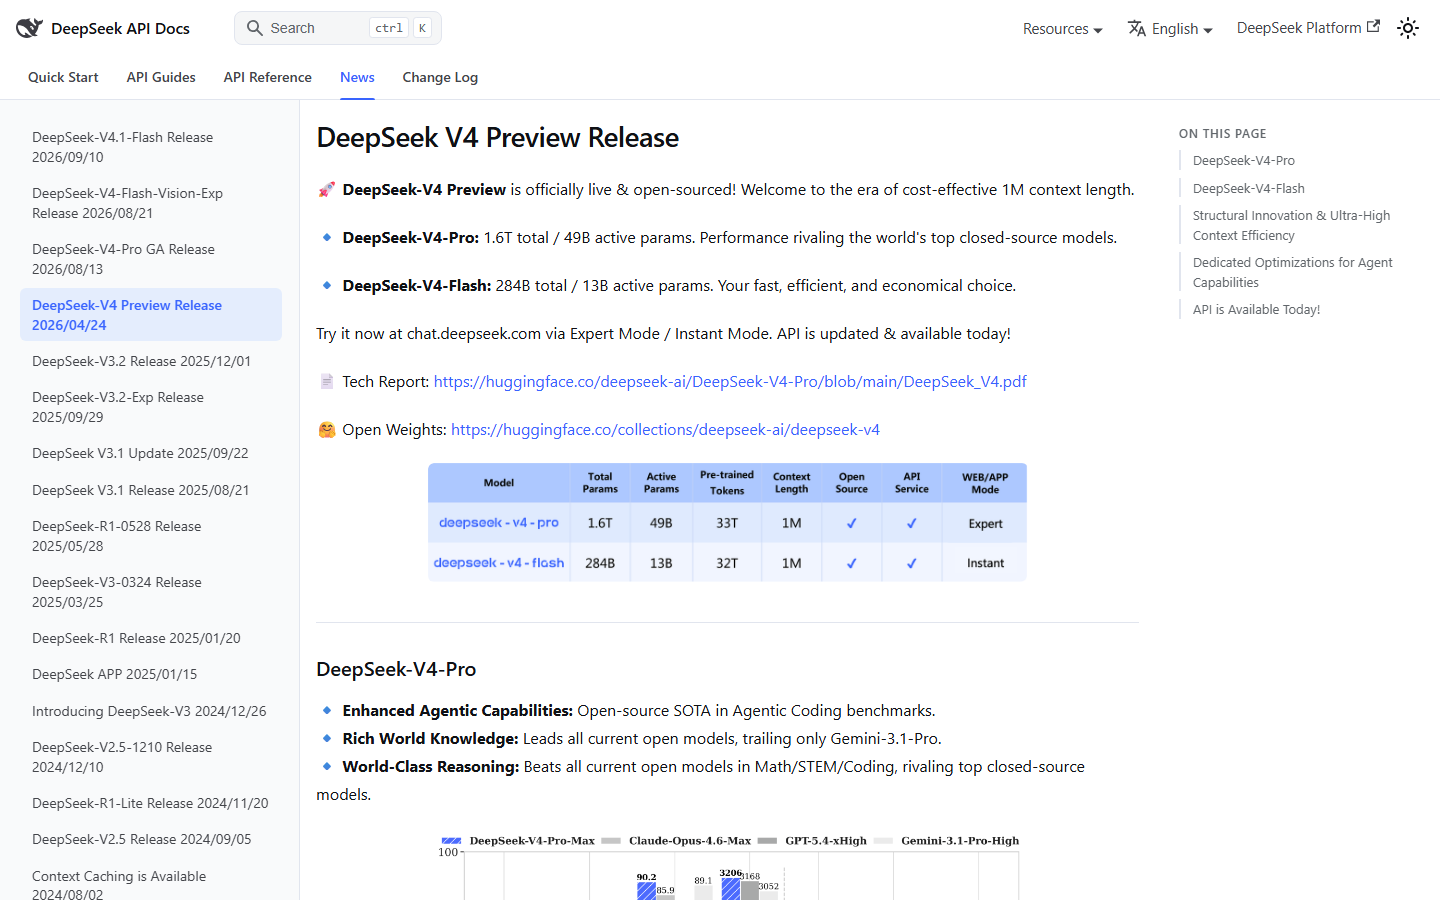

دیپسیک ۴ فلش (آفلاین)
DeepSeek-V4-Flash (offline)
نسخهٔ متنباز DeepSeek-V4-Flash با ۲۸۴ میلیارد پارامتر و متن تا یک میلیون توکن، برای برنامهنویسی و کار ایجنتی؛ روی سرور چندکارته یا دستگاه ۱۲۸ گیگابایتی، با مجوز MIT.