
دیپسیک ۴ فلش (آفلاین)
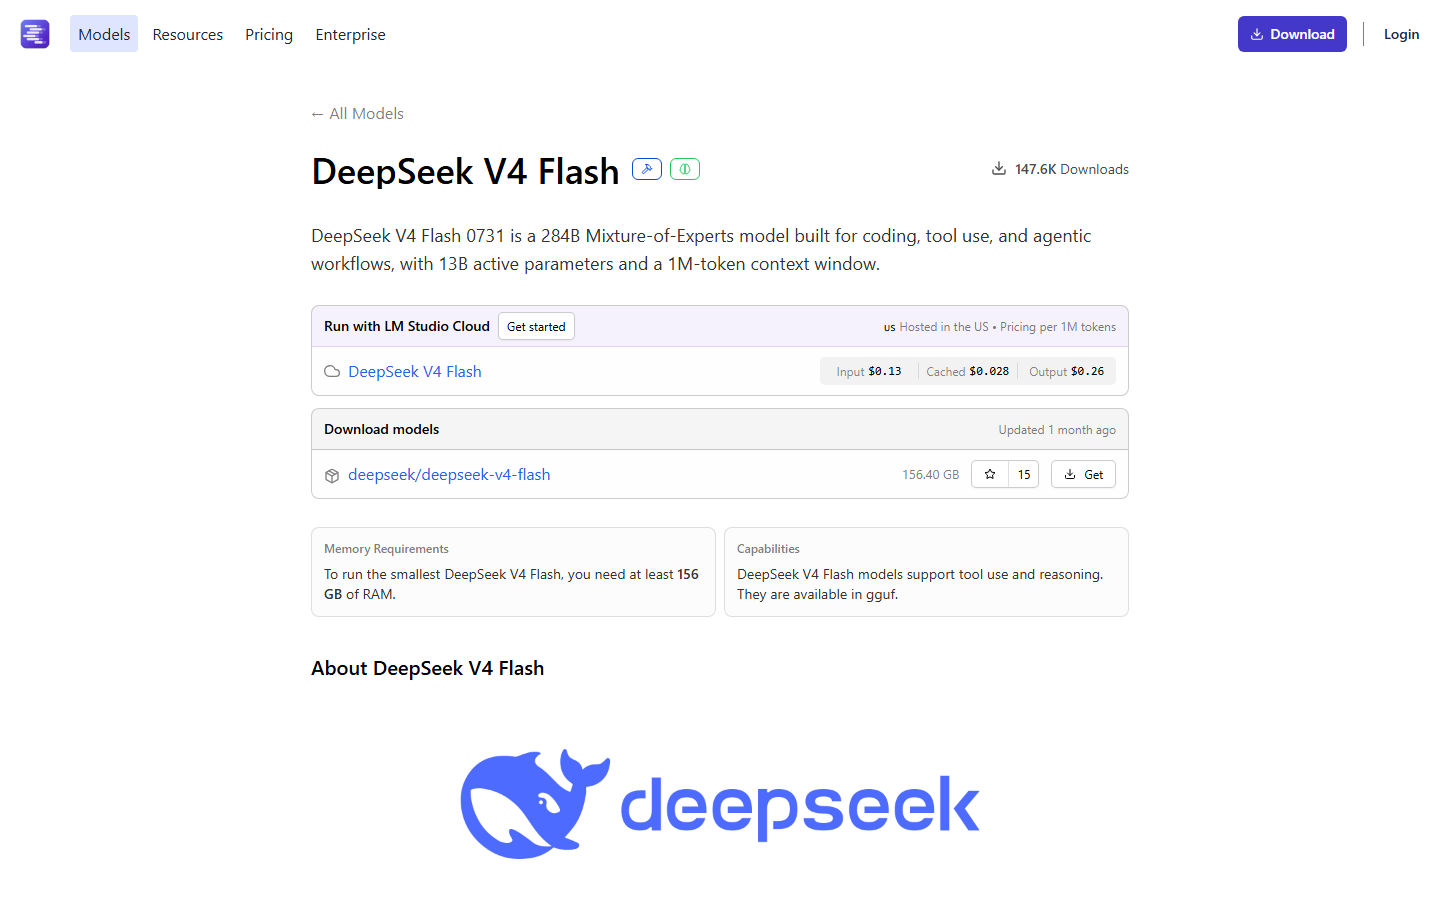
DeepSeek-V4-Flash (offline)نسخهٔ متنباز DeepSeek-V4-Flash با ۲۸۴ میلیارد پارامتر و متن تا یک میلیون توکن، برای برنامهنویسی و کار ایجنتی؛ روی سرور چندکارته یا دستگاه ۱۲۸ گیگابایتی، با مجوز MIT.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- MIT — استفادهٔ تجاری آزاد
- فارسی: نامعلوم
- برنامهٔ گرافیکی
- خط فرمان
- API
فقط برای دانلود اینترنت لازم است. برچسبهای cloud در Ollama و گزینهٔ Cloud در LM Studio آفلاین نیستند و متن را به سرور بیرونی میفرستند.
کد و وزنها هر دو مجوز MIT دارند. استفادهٔ تجاری، تغییر و بازتوزیع آزاد است؛ فقط متن مجوز MIT و نام صاحب حق را همراه نسخه نگه دارید.
نسخهها و سختافزار لازم
- V4-Flash-0731 (284B-A13B)۲۸۴B (فعال ۱۳B)طول متن ۱٬۰۲۴ هزار توکن
- حجم دانلود:
- ۱۵۵٫۱ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۱۸۷ گیگ یا رم ۱۸۹ گیگ
حجم ۴ و ۸ بیتی از نسخههای GGUF شرکت Unsloth است (نسخهٔ ۸ بیتی بیافت است). وزن رسمی (FP4 و FP8) حدود ۱۶۷ گیگابایت است و برای vLLM یا SGLang چند کارت میخواهد، مثلاً ۴ کارت H200 یا ۸ کارت RTX PRO 6000. حداقل حافظه برآوردی است.
- V4-Flash-0731 — 3-bit GGUF (UD-IQ3_XXS)۲۸۴B (فعال ۱۳B)طول متن ۱٬۰۲۴ هزار توکن
- حافظهٔ لازم:
- کارت گرافیک ۱۲۶ گیگ یا رم ۱۲۸ گیگ
فایل حدود ۱۰۴ گیگابایت؛ Unsloth آن را برای دستگاه ۱۲۸ گیگابایتی پیشنهاد میکند و کمی افت کیفیت دارد. حداقل حافظه برآوردی است.
- V4.1-Flash (552B + 196B Engram)۵۵۲B (فعال ۱۶B)طول متن ۱٬۰۲۴ هزار توکن
- حافظهٔ لازم:
- کارت گرافیک ۶۱۲ گیگ یا رم ۶۱۴ گیگ
جانشین V4-Flash (۱۰ سپتامبر ۲۰۲۶، MIT): ستون ۵۵۲ میلیاردی بهعلاوهٔ ۱۹۶ میلیارد حافظهٔ جستوجوی Engram (حدود ۷۶۳ میلیارد پارامتر ذخیرهشده)، ۸ میلیارد پارامتر فعال هنگام خواندن ورودی و ۱۶ میلیارد هنگام تولید، ورودی متن و تصویر. وزن رسمی FP8/FP4 حدود ۵۱۰ گیگابایت است و اجرای مرجع ۸ کارت گرافیک مرکز داده میخواهد. فعلاً فقط vLLM و SGLang اجرایش میکنند؛ llama.cpp هنوز نه، و Ollama و LM Studio فقط نسخهٔ ابریاش را دارند. حافظهٔ لازم برآوردی است.
- V4-Flash-Vision-Exp (GGUF)
- حجم دانلود:
- ۱۵۵ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۱۸۶ گیگ یا رم ۱۸۸ گیگ
V4-Flash بهعلاوهٔ ماژول بینایی (۳۱ اوت ۲۰۲۶، MIT، آزمایشی)؛ در کارهای ایجنتی متنی نزدیک 0731 است. GGUF رسمی تیم llama.cpp: MXFP4 حدود ۱۵۵ گیگابایت، Q2_K حدود ۱۱۷٫۴ و Q2_K_S حدود ۹۸٫۶ گیگابایت، بهعلاوهٔ فایل تصویر mmproj (۰٫۵ تا ۰٫۹ گیگابایت). کنار 0731، راه اجرای این خانواده با llama.cpp همین است. حافظهٔ لازم برآوردی است.
نصب و اجرا
- ۱
سادهترین راه روی دستگاه قوی: LM Studio
lms get deepseek/deepseek-v4-flashدانلود حدود ۱۵۶ گیگابایت است. در صفحهٔ مدل گزینهٔ Cloud هم هست که آفلاین نیست؛ نسخهٔ دانلودی را انتخاب کنید.
- ۲
یا llama.cpp را از گیتهاب بگیرید و بسازیدلینوکس
git clone https://github.com/ggml-org/llama.cpp && cmake llama.cpp -B llama.cpp/build -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON && cmake --build llama.cpp/build --config Release -j --target llama-cli llama-serverبدون کارت گرافیک NVIDIA، گزینهٔ GGML_CUDA را OFF بگذارید؛ روی مک، Metal خودکار فعال است.
- ۳
نسخهٔ ۳ بیتی را یک بار دانلود کنید
hf download unsloth/DeepSeek-V4-Flash-0731-GGUF --local-dir DeepSeek-V4-Flash-0731-GGUF --include "*UD-IQ3_XXS*"حدود ۱۰۴ گیگابایت. برای کیفیت کامل بهجای آن *UD-Q8_K_XL* (حدود ۱۶۲ گیگابایت) را بگیرید. ابزار hf با pip install -U "huggingface_hub[cli]" نصب میشود.
- ۴
مدل را بهصورت API محلی اجرا کنیدلینوکس
./llama.cpp/build/bin/llama-server --model DeepSeek-V4-Flash-0731-GGUF/UD-IQ3_XXS/DeepSeek-V4-Flash-0731-UD-IQ3_XXS-00001-of-00004.gguf --ctx-size 32768 --temp 1.0 --top-p 1.0 --min-p 0.01API سازگار با OpenAI روی پورت ۸۰۸۰ بالا میآید. تنظیمات دما از راهنمای Unsloth است.
- ۵
روی سرور چندکارته، vLLMلینوکس
vllm serve deepseek-ai/DeepSeek-V4-Flash-0731 --trust-remote-code --kv-cache-dtype fp8 --block-size 256 --data-parallel-size 4 --enable-expert-parallel --moe-backend deep_gemm_mega_moe --attention-config '{"use_fp4_indexer_cache": true}' --speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'این دستور رسمی دیپسیک برای یک سرور ۴ کارتهٔ GB300 است؛ برای H200 یا RTX PRO 6000 دستور مناسب را از دستورالعمل vLLM بردارید. vLLM نسخهٔ 0.25.0 یا جدیدتر لازم است.
دانلود
- Hugging Face (مخزن رسمی، نسخهٔ 0731) ↗رسمی
وزن رسمی FP4 و FP8، حدود ۱۶۷ گیگابایت.
- ModelScope (حساب رسمی دیپسیک) ↗رسمی
همان وزنها روی ModelScope؛ کارت رسمی نسخهٔ اول هم به همین حساب دیپسیک لینک داده است.
- LM Studio ↗رسمی
نسخهٔ دانلودی حدود ۱۵۶ گیگابایت؛ گزینهٔ Cloud را انتخاب نکنید.
- Unsloth GGUF ↗غیررسمی
نسخههای GGUF برای llama.cpp، از ۸۳ تا ۱۶۲ گیگابایت.
- Hugging Face (DeepSeek-V4.1-Flash) ↗رسمی
وزن رسمی FP8/FP4 حدود ۵۱۰ گیگابایت برای vLLM و SGLang؛ قالب چت Jinja همراهش نیست.
- GGUF رسمی llama.cpp برای Vision-Exp (ggml-org) ↗رسمی
MXFP4 حدود ۱۵۵، Q2_K حدود ۱۱۷٫۴ و Q2_K_S حدود ۹۸٫۶ گیگابایت، با فایل تصویر mmproj.
نکات امنیتی
- vLLM برای این مدل گزینهٔ --trust-remote-code میخواهد، یعنی کد پایتون داخل مخزن اجرا میشود؛ فقط مخزن رسمی deepseek-ai را به کار ببرید.
- پورت API سرور (۸۰۰۰ در vLLM) را به اینترنت باز نکنید؛ آن را پشت فایروال یا VPN داخلی بگذارید و با گزینهٔ --api-key کلید تعیین کنید. همین نکته برای پورت ۸۰۸۰ llama-server هم صدق میکند.
- در Ollama و LM Studio گزینههای Cloud را انتخاب نکنید؛ در آن حالت متن شما به سرور بیرونی میرود.
- فایلهای GGUF را فقط از مخزنهای شناختهشده (Unsloth یا LM Studio) بگیرید و حجم فایلها را با صفحهٔ مخزن مقایسه کنید.
- اگر آن را به ایجنت برنامهنویسی وصل میکنید، ایجنت را در محیط ایزوله اجرا کنید؛ ممکن است دستور خطرناک اجرا کند.
- V4.1-Flash قالب چت Jinja ندارد و پرامپت باید با encoding/encoding.py مخزن یا دستورالعمل رسمی ساخته شود. چند GGUF جامعه پیش از پشتیبانی llama.cpp ساخته شدهاند و نسخههای «بدون سانسور» هم هست؛ فقط نسخههای رسمی دیپسیک، nvidia یا antirez را بگیرید.
برای شرکتها و سازمانها
مناسب سرور شرکت است، نه کامپیوتر شخصی. دستورالعمل vLLM هر نسخهٔ سرویس را روی ۴ کارت H200 یا B200 (نیمی از یک سرور ۸ کارته) اجرا میکند و روی ۸ کارت ۹۶ گیگابایتی RTX PRO 6000 هم آزموده شده است. چنین سروری به چند ده کاربر همزمان جواب میدهد (برآورد ما؛ عدد رسمی نیست). روی یک دستگاه ۱۲۸ گیگابایتی با نسخهٔ ۳ بیتی، فقط برای یک یا دو کاربر مناسب است.
برنامههایی که این مدل را اجرا میکنند
 الام استودیو
 لاما سیپیپی
همسطح ابری
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۶ فروردین ۱۴۰۵
معرفی: دیپسیک ۴ فلش (آفلاین)
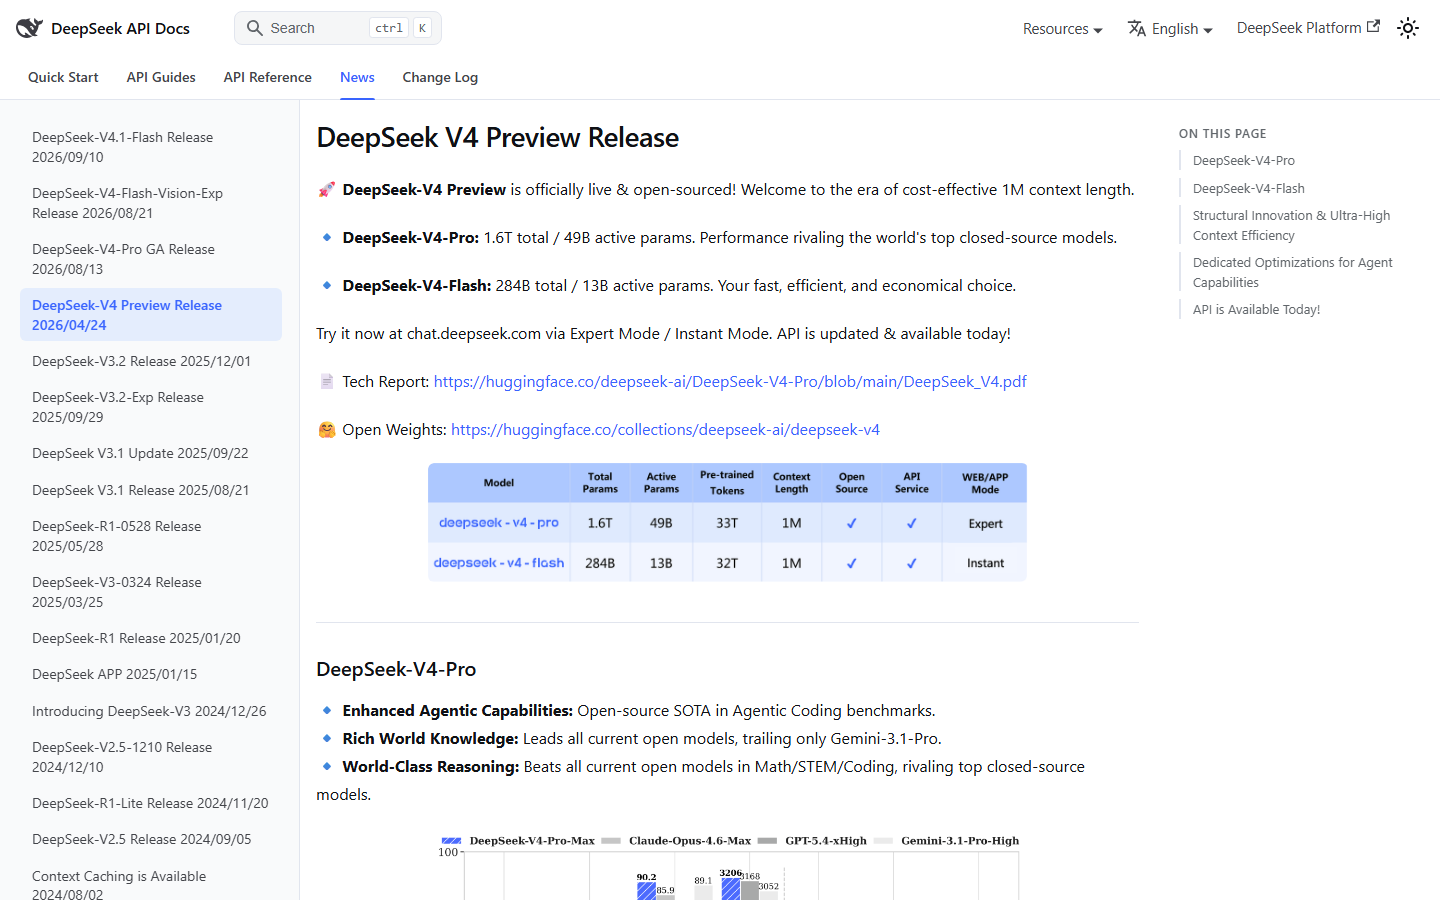
DeepSeek-V4-Flash مدل متنباز دیپسیک است؛ ۲۸۴ میلیارد پارامتر دارد و در هر توکن ۱۳ میلیارد پارامتر فعال میشود. پیشنمایش آن ۲۴ آوریل ۲۰۲۶ آمد و نسخهٔ رسمی (DeepSeek-V4-Flash-0731) ۳۱ ژوئیهٔ ۲۰۲۶ منتشر شد؛ با همان معماری و اندازه، اما آموزش تکمیلی تازه. متن تا یک میلیون توکن را میخواند و برای برنامهنویسی، کار با ابزار و ایجنت ساخته شده است.
برای شرکتها و تیمهای فنی مناسب است که مدلی قوی میخواهند ولی نمیخواهند کد و دادهشان به سرور خارجی برود. طبق دیپسیک، نسخهٔ 0731 در سنجههای ایجنتی حتی از V4-Pro پیشنمایش بهتر است؛ مثلاً ۸۲٫۷ در Terminal Bench 2.1. مجوز MIT هم هر نوع استفادهٔ تجاری را آزاد گذاشته است.
سختافزار سنگینی میخواهد. وزن رسمی حدود ۱۶۷ گیگابایت است و دستورالعمل vLLM آن را روی ۴ کارت H200 یا B200 اجرا میکند. ارزانترین راه، نسخهٔ ۳ بیتی GGUF (حدود ۱۰۴ گیگابایت) است که Unsloth آن را برای دستگاههای ۱۲۸ گیگابایتی پیشنهاد کرده است.
برای شروع روی یک دستگاه قوی، در LM Studio نسخهٔ دانلودی را بگیرید یا فایل GGUF را با llama.cpp اجرا کنید. روی سرور، vLLM یا SGLang یک API سازگار با OpenAI میدهد که ابزارهای برنامهنویسی و چت به آن وصل میشوند.
جانشین آن، DeepSeek-V4.1-Flash، ۱۰ سپتامبر ۲۰۲۶ با همان مجوز MIT منتشر شد و حالا نسخهٔ تازهٔ این خانواده است؛ API خود دیپسیک هم از همان روز به آن منتقل شده. ستون اصلیاش ۵۵۲ میلیارد پارامتر است بهعلاوهٔ ۱۹۶ میلیارد حافظهٔ جستوجو به نام Engram؛ هنگام خواندن ورودی ۸ و هنگام تولید ۱۶ میلیارد پارامتر فعال است، تصویر هم میگیرد و حافظهٔ KV آن برای هر توکن حدود یکچهارم V4-Flash است. طبق دیپسیک در Terminal-Bench 2.1 به ۹۰٫۶ رسیده است. اما فعلاً فقط برای سرور است: وزن رسمی FP8/FP4 حدود ۵۱۰ گیگابایت است، اجرای مرجع ۸ کارت گرافیک مرکز داده میخواهد و فقط vLLM و SGLang پشتیبانیاش میکنند. llama.cpp هنوز آن را اجرا نمیکند (درخواست ادغامش باز است) و Ollama و LM Studio فقط نسخهٔ ابریاش را دارند. antirez هم نسخهٔ ۲ بیتیای برای موتور DwarfStar (فقط مک) ساخته که به گفتهٔ او با خواندن جدولهای Engram از SSD روی یک مک ۱۲۸ گیگابایتی اجرا میشود. پس برای اجرا روی یک دستگاه، V4-Flash-0731 هنوز راه عملیتر است.
دو نکتهٔ دیگر: V4-Flash در Ollama فقط نسخهٔ ابری دارد که آفلاین نیست، و کیفیت فارسی هیچکدام رسماً سنجیده نشده است.
بهترین کاربردها
- •روی سرور شرکت یک مدل قوی برنامهنویسی راه بیندازم که کد بیرون نرود
- •یک ایجنت برنامهنویسی را به مدل آفلاین روی سرور خودمان وصل کنم
- •کل مستندات یا کد یک پروژهٔ بزرگ را یکجا به مدل بدهم (تا یک میلیون توکن)
- •روی مک یا کامپیوتر ۱۲۸ گیگابایتی دیپسیک را بدون اینترنت اجرا کنم
- •بدون فرستادن داده به سرور خارجی از دیپسیک در شرکت استفاده کنم
- •مسئلههای ریاضی و استدلالی سخت را آفلاین حل کنم
- •یک API داخلی سازگار با OpenAI برای تیم توسعه راه بیندازم
برای این کارها سراغش نروید
- –اجرا روی لپتاپ یا کامپیوتر معمولی
- –خواندن عکس و اسکن (نسخهٔ اصلی فقط متن است)
- –ساخت تصویر، صدا یا ویدیو
- –چت سادهٔ روزمره (مدلهای کوچکتر ارزانترند)
تصاویر محیط ابزار
نقاط قوت
- ✓مجوز MIT؛ استفادهٔ تجاری، تغییر و بازتوزیع آزاد
- ✓نسخهٔ رسمی 0731 طبق دیپسیک در سنجههای ایجنتی از V4-Pro پیشنمایش هم بهتر است
- ✓پنجرهٔ متن یک میلیون توکنی
- ✓فقط ۱۳ میلیارد پارامتر فعال؛ برای اندازهاش سریع است
- ✓سه سطح استدلال (low، high و max) برای تعادل سرعت و دقت
- ✓پشتیبانی در vLLM، SGLang، llama.cpp و LM Studio
نقاط ضعف
- ✗حتی نسخهٔ ۳ بیتی حدود ۱۰۴ گیگابایت است و دستگاه ۱۲۸ گیگابایتی میخواهد؛ برای سرور چندکاربره ۴ کارت H200 یا B200 لازم است
- ✗در Ollama فقط نسخهٔ ابری دارد و آن نسخه آفلاین نیست
- ✗کیفیت فارسیاش رسماً سنجیده نشده
- ✗V4-Flash-0731 عکس نمیخواند؛ نسخهٔ Vision-Exp آزمایشی است و V4.1-Flash که عکس میگیرد فقط روی سرور اجرا میشود
- ✗API دیپسیک از ۱۰ سپتامبر ۲۰۲۶ آن را کنار گذاشته و جانشینش V4.1-Flash است که فعلاً فقط روی سرور چندکارته با vLLM یا SGLang اجرا میشود
پرسشهای پرتکرار
با چه سختافزاری اجرا میشود؟
راه ارزان: نسخهٔ ۳ بیتی GGUF (حدود ۱۰۴ گیگابایت) روی دستگاهی با ۱۲۸ گیگابایت رم یا حافظهٔ یکپارچه، با llama.cpp یا LM Studio؛ برای یک کاربر. راه سرور: وزن رسمی ۱۶۷ گیگابایتی با vLLM روی ۴ کارت H200 یا B200، یا ۸ کارت RTX PRO 6000.
در Ollama هست؟
فقط با برچسب cloud، که روی سرورهای Ollama اجرا میشود و آفلاین نیست. برای اجرای محلی از LM Studio، llama.cpp یا vLLM استفاده کنید.
فارسی را خوب میفهمد؟
دیپسیک فهرست زبان یا آزمون فارسی برای این مدل منتشر نکرده است. پیش از استفادهٔ جدی، با متنهای خودتان امتحان کنید.
استفادهٔ تجاری آزاد است؟
بله. کد و وزنها مجوز MIT دارند؛ فقط متن مجوز را همراه نسخه نگه دارید.
فرق نسخهٔ 0731 با نسخهٔ اول چیست؟
0731 نسخهٔ رسمی است که ۳۱ ژوئیهٔ ۲۰۲۶ منتشر شد: همان معماری و اندازه، با آموزش تکمیلی تازه و یک ماژول DSpark برای تولید سریعتر متن. در سنجههای ایجنتی خیلی بهتر از پیشنمایش است.
چرا V4.1-Flash را نصب نکنم؟
V4.1-Flash (۱۰ سپتامبر ۲۰۲۶) جانشین آن و نسخهٔ تازهتر است، اما خیلی بزرگتر است: ستون ۵۵۲ میلیاردی بهعلاوهٔ ۱۹۶ میلیارد حافظهٔ Engram و دانلود حدود ۵۱۰ گیگابایت. فعلاً فقط vLLM و SGLang روی سرور چندکارته (اجرای مرجع ۸ کارت) آن را اجرا میکنند؛ llama.cpp هنوز پشتیبانیاش نمیکند و Ollama و LM Studio فقط نسخهٔ ابریاش را دارند. برای اجرا روی یک دستگاه، V4-Flash هنوز عملیتر است.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
کوئن ۳.۸ 27B (آفلاین)
Qwen3.8-27B (offline)
قویترین مدل ۲۷ میلیاردی Qwen (اوت ۲۰۲۶) برای کارت گرافیک ۲۴ گیگابایتی: کدنویسی ایجنتی، کار با سند و تصویر و استدلال، طبق جدول Qwen نزدیک به Qwen3.7-Plus آنلاین، با مجوز Apache 2.0.
میمو ۲.۶ (آفلاین)
MiMo-V2.6 (offline)
خانوادهٔ مدلهای باز شیائومی (سپتامبر ۲۰۲۶، مجوز MIT) برای کدنویسی ایجنتی و کار با ابزار: نسخهٔ Distill-Qwen-9B با فایل ۵٫۸ گیگابایتی روی لپتاپ ۱۶ گیگابایتی اجرا میشود و Flash و Pro (به گزارش eWeek، Pro بالاترین مدل باز در شاخص Artificial Analysis) سرور چندکارته میخواهند؛ فارسی آزموده نشده است.

گراک
Grok
دستیار SpaceXAI با Grok 4.6 برای ایجنت و کدنویسی، دسترسی زنده به X، و Grok Imagine Image 2 برای ساخت/ویرایش عکس.