جیالام ۵.۳ فلش (آفلاین)
GLM-5.3-Flash (offline)مدل چندوجهی متنباز Z.ai با ۳۲۰ میلیارد پارامتر برای برنامهنویسی و کار ایجنتی که به گفتهٔ سازنده به Claude Opus 4.8 نزدیک است؛ مجوز MIT، مخصوص سرور چندکارته یا دستگاه ۱۲۸ گیگابایتی.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- MIT — استفادهٔ تجاری آزاد
- فارسی: نامعلوم
- خط فرمان
- API
فقط برای دانلود اینترنت لازم است. نسخههای Ollama (glm-5.3-flash:cloud) و LM Studio ابریاند و آفلاین نیستند.
استفادهٔ تجاری، تغییر و بازتوزیع آزاد است؛ فقط متن مجوز MIT و نام صاحب حق را همراه نسخه نگه دارید. این مجوز فقط برای GLM-5.3-Flash است؛ مدل بزرگتر GLM-5.3 مجوز دیگری دارد.
نسخهها و سختافزار لازم
- 320B-A18B۳۲۰B (فعال ۱۸B)طول متن ۱٬۰۲۴ هزار توکن
- حجم دانلود:
- ۱۹۹٫۷ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۲۴۰ گیگ یا رم ۲۴۲ گیگ
حجم ۸ بیتی همان وزن رسمی FP8 و حجم BF16 از مخزن رسمی BF16 است؛ حجم ۴ بیتی از نسخهٔ GGUF شرکت Unsloth است که فعلاً فقط با شاخهٔ ویژهٔ llama.cpp کار میکند. دستورالعمل vLLM وزن FP8 را روی ۴ کارت H200 اجرا کرده است. حداقل حافظه برآوردی است.
- 320B-A18B — 2-bit GGUF (UD-IQ2_XXS)۳۲۰B (فعال ۱۸B)طول متن ۱٬۰۲۴ هزار توکن
- حافظهٔ لازم:
- کارت گرافیک ۱۲۳ گیگ یا رم ۱۲۵ گیگ
فایل حدود ۱۰۲ گیگابایت؛ روی دستگاه ۱۲۸ گیگابایتی جا میشود ولی طبق سنجش Unsloth فقط در حدود ۷۶ درصد توکنها با نسخهٔ کامل همخوان است. Unsloth نسخهٔ ۳ بیتی (۱۲۰ گیگابایت) را هم برای دستگاههای ۱۲۸ گیگابایتی پیشنهاد کرده است. حداقل حافظه برآوردی است.
- 320B-A18B — ggml-org GGUF۳۲۰B (فعال ۱۸B)طول متن ۱٬۰۲۴ هزار توکن
- حجم دانلود:
- ۱۸۱٫۴ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۲۱۸ گیگ یا رم ۲۲۰ گیگ
نسخهٔ GGUF رسمی تیم llama.cpp (ggml-org) که ۳ اکتبر ۲۰۲۶ منتشر شد: Q4_K حدود ۱۸۱٫۴ و Q2_K حدود ۱۳۳٫۸ گیگابایت، بهعلاوهٔ فایل تصویر mmproj (۰٫۶۵ گیگابایت) و فایل جانبی MTP برای تولید سریعتر (۴٫۹۵ گیگابایت در Q4_0 یا ۹٫۲۸ گیگابایت در Q8_0). حافظهٔ لازم برآوردی است.
نصب و اجرا
- ۱
روی سرور لینوکس، vLLM را نصب کنیدلینوکس
uv pip install -U vllmپشتیبانی GLM-5.3-Flash در vLLM نسخهٔ 0.30.0 آمده است.
- ۲
وزنها را یک بار دانلود کنیدلینوکس
hf download zai-org/GLM-5.3-Flashحدود ۳۲۸ گیگابایت. برای سرور بدون اینترنت، پوشهٔ کش هاگینگفیس را کپی کنید و HF_HUB_OFFLINE=1 بگذارید.
- ۳
سرویس را روی ۴ کارت بالا بیاوریدلینوکس
vllm serve zai-org/GLM-5.3-Flash --tensor-parallel-size 4 --tool-call-parser glm47 --reasoning-parser glm47 --enable-auto-tool-choice --served-model-name glm-5.3-flashبرگرفته از دستورالعمل رسمی vLLM که روی ۴ کارت H200 آزموده شده است. روی کارتهای Blackwell میتوانید --kv-cache-dtype fp8 را هم اضافه کنید؛ روی H100 و H200 این گزینه برای این مدل پشتیبانی نمیشود.
- ۴
روی دستگاه ۱۲۸ گیگابایتی: شاخهٔ llama.cpp شرکت Unsloth را بسازیدلینوکس
git clone --branch glm5next/upstream https://github.com/unslothai/llama.cpp && cmake llama.cpp -B llama.cpp/build -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON && cmake --build llama.cpp/build --config Release -j --target llama-cli llama-serverپشتیبانی این مدل هنوز در llama.cpp اصلی ادغام نشده و این شاخه غیررسمی است. روی مک، GGML_CUDA را OFF بگذارید.
- ۵
نسخهٔ ۲ بیتی را دانلود و اجرا کنیدلینوکس
hf download unsloth/GLM-5.3-Flash-GGUF --local-dir GLM-5.3-Flash-GGUF --include "*UD-IQ2_XXS*" && ./llama.cpp/build/bin/llama-server --model GLM-5.3-Flash-GGUF/UD-IQ2_XXS/GLM-5.3-Flash-UD-IQ2_XXS-00001-of-00004.gguf --ctx-size 32768 --temp 1.0 --top-p 0.95حدود ۱۰۲ گیگابایت دانلود؛ API سازگار با OpenAI روی پورت ۸۰۸۰ بالا میآید.
دانلود
- Hugging Face (مخزن رسمی Z.ai) ↗رسمی
وزن رسمی FP8، حدود ۳۲۸ گیگابایت.
- Hugging Face — BF16 ↗رسمی
نسخهٔ کامل BF16، حدود ۶۴۳ گیگابایت.
- ModelScope (حساب رسمی ZhipuAI) ↗رسمی
همان وزن رسمی روی ModelScope.
- Unsloth GGUF ↗غیررسمی
نسخههای ۱ تا ۸ بیتی، از ۹۳ تا ۳۴۱ گیگابایت؛ فقط با شاخهٔ llama.cpp شرکت Unsloth.
- llama.cpp (شاخهٔ Unsloth) ↗غیررسمی
تا ادغام پشتیبانی در llama.cpp اصلی، برای اجرای GGUF لازم است.
- GGUF رسمی llama.cpp (ggml-org) ↗رسمی
Q2_K حدود ۱۳۳٫۸ و Q4_K حدود ۱۸۱٫۴ گیگابایت، با فایلهای mmproj و MTP؛ ۳ اکتبر ۲۰۲۶.
نکات امنیتی
- پورت API سرور (۸۰۰۰ در vLLM) را به اینترنت باز نکنید؛ آن را پشت فایروال یا VPN داخلی بگذارید و با گزینهٔ --api-key کلید تعیین کنید.
- شاخهٔ llama.cpp شرکت Unsloth کد غیررسمی است؛ فقط از مخزن گیتهاب خود Unsloth بگیرید و بعد از ادغام پشتیبانی در نسخهٔ اصلی، به آن برگردید.
- در Ollama و LM Studio گزینههای Cloud را انتخاب نکنید؛ در آن حالت متن شما به سرور بیرونی میرود.
- اگر مدل را به ایجنتی با دسترسی به مرورگر یا دسکتاپ وصل میکنید، آن را در محیط ایزوله اجرا کنید.
- قالب چت مدل ۴ سپتامبر ۲۰۲۶ اصلاح شد (اشکال در مرتب کردن نتیجهٔ ابزارها)؛ اگر مدل را پیش از آن دانلود کردهاید، قالب را دوباره بگیرید تا فراخوانی ابزار درست کار کند.
برای شرکتها و سازمانها
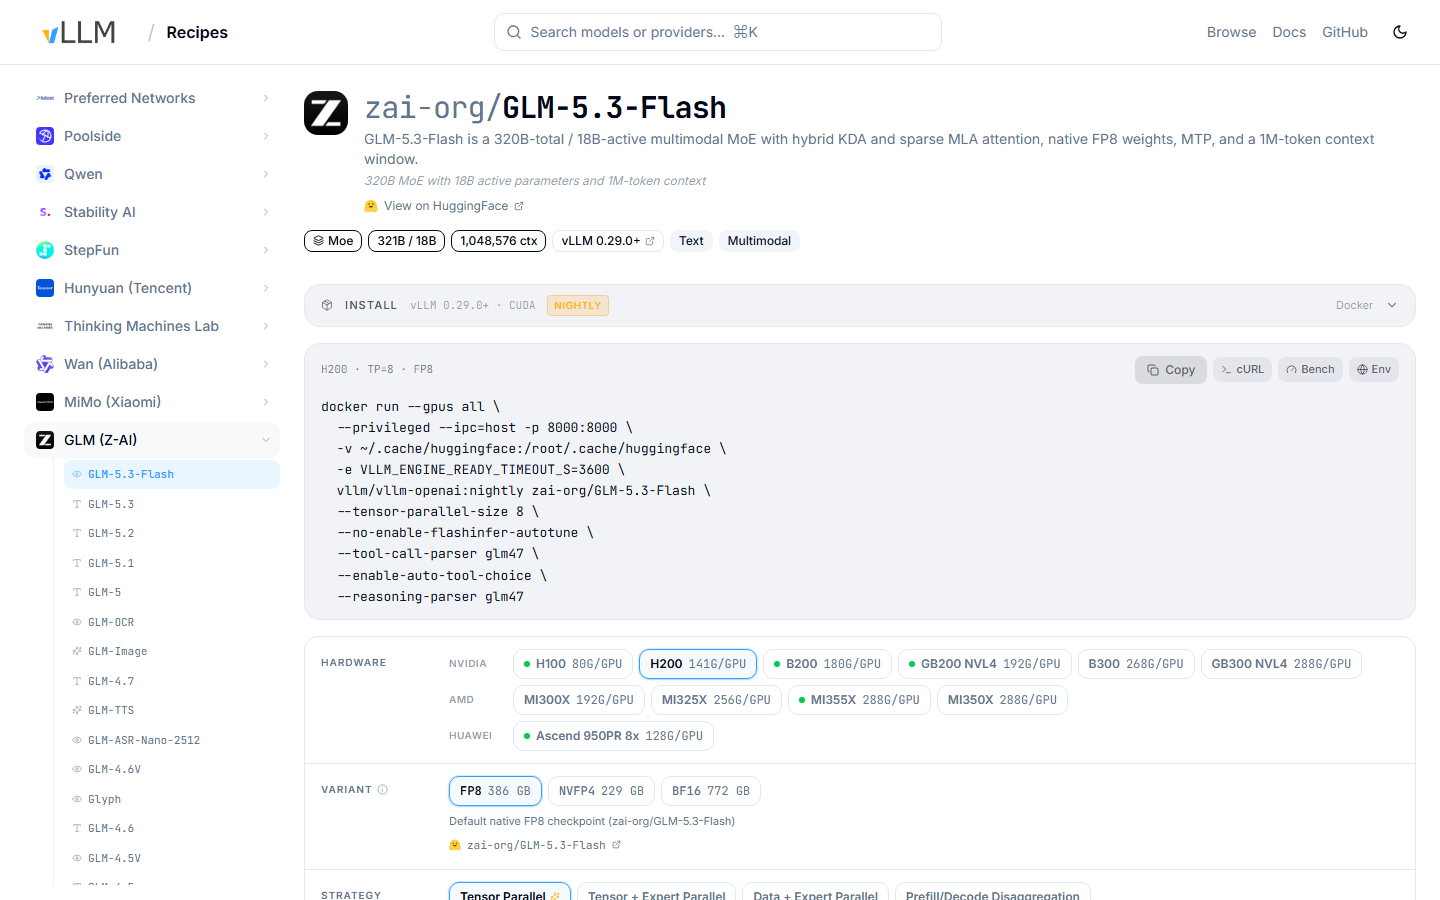
برای سرور شرکت: دستورالعمل vLLM آن را روی ۴ کارت H200 (نیمی از یک سرور ۸ کارته) اجرا کرده و روی GB200، AMD MI355X و Huawei Ascend هم پشتیبانی دارد. خود Z.ai همین مدل را در مقیاس بزرگ روی تراشههای چینی سرو میکند. چنین سروری به چند ده کاربر همزمان جواب میدهد (برآورد ما؛ عدد رسمی نیست). روی دستگاه ۱۲۸ گیگابایتی با نسخهٔ ۲ یا ۳ بیتی، فقط برای یک کاربر مناسب است.
برنامههایی که این مدل را اجرا میکنند
 اینفرکس
همسطح ابری
 زد ایآی
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۴ مرداد ۱۴۰۵
معرفی: جیالام ۵.۳ فلش (آفلاین)
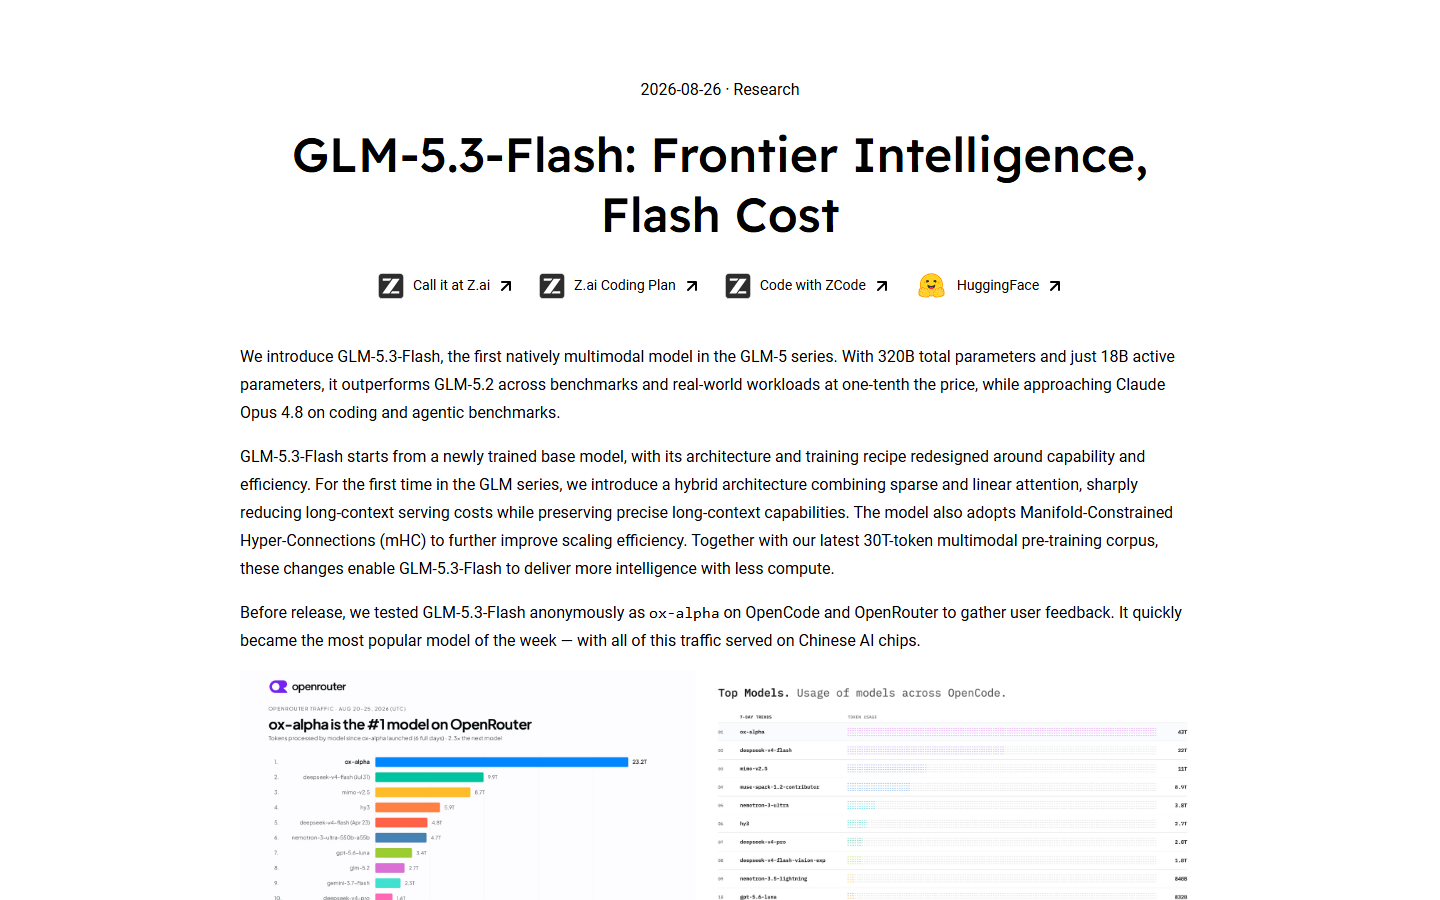
GLM-5.3-Flash مدل متنباز شرکت چینی Z.ai (ژیپو) است که ۲۶ اوت ۲۰۲۶ منتشر شد. ۳۲۰ میلیارد پارامتر دارد و در هر توکن ۱۸ میلیارد پارامتر فعال است. اولین مدل چندوجهی خانوادهٔ GLM-5 است: متن، عکس و ویدیو را میفهمد و تا یک میلیون توکن متن میخواند.
تمرکزش برنامهنویسی و کار ایجنتی است. Z.ai میگوید در این کارها از GLM-5.2 بهتر و به Claude Opus 4.8 نزدیک است؛ مثلاً ۸۴٫۳ در Terminal-Bench 2.1 در برابر ۸۵. عکس صفحهای را که خودش ساخته میبیند و ایرادش را درست میکند. برای تیمهای فنی که مدلی قوی روی سرور خودشان میخواهند مناسب است و مجوز MIT استفادهٔ تجاری را آزاد گذاشته است.
سختافزار: وزن رسمی FP8 حدود ۳۲۸ گیگابایت است و دستورالعمل vLLM آن را روی ۴ کارت H200 آزموده است. ارزانترین راه، نسخههای ۲ یا ۳ بیتی GGUF از Unsloth روی مک یا دستگاه ۱۲۸ گیگابایتی است که کیفیت پایینتری دارند.
برای شروع روی سرور، vLLM نسخهٔ 0.30 یا جدیدتر را نصب کنید و سرویس را روی ۴ کارت بالا بیاورید؛ SGLang و KTransformers هم پشتیبانی میکنند. نتیجه یک API سازگار با OpenAI است که ابزارهای برنامهنویسی به آن وصل میشوند.
ایرادها: در Ollama و LM Studio فقط نسخهٔ ابری دارد، تا اواخر سپتامبر پشتیبانی llama.cpp در نسخهٔ اصلی ادغام نشده بود (از ۳ اکتبر ۲۰۲۶ خود تیم llama.cpp نسخهٔ GGUF رسمی ggml-org/GLM-5.3-Flash-GGUF را منتشر کرده است)، و مدل همیشه پیش از جواب «فکر» میکند و سطح پیشفرض استدلالش بیشترین است. زبانهای رسمی کارت مدل هم فقط انگلیسی و چینی است.
بهترین کاربردها
- •روی سرور شرکت یک مدل برنامهنویسی نزدیک به Claude Opus راه بیندازم
- •ایجنتی بسازم که از روی اسکرینشات صفحهٔ وب، کد رابط کاربری را درست کند
- •بدون اینترنت از روی عکس نمودار یا جدول، تحلیل و گزارش بگیرم
- •یک پروژهٔ نرمافزاری بزرگ را یکجا به مدل آفلاین بدهم (تا یک میلیون توکن)
- •یک API داخلی سازگار با OpenAI برای تیم فنی روی سرور خودمان بالا بیاورم
- •یک مدل چندوجهی متنباز با مجوز MIT برای محصول تجاری میخواهم
- •روی مک ۱۲۸ گیگابایتی یک مدل بزرگ GLM را آزمایشی و آفلاین اجرا کنم
برای این کارها سراغش نروید
- –اجرا روی لپتاپ یا کامپیوتر معمولی
- –ساخت تصویر یا ویدیو (فقط میخواند، نمیسازد)
- –نصب ساده با Ollama یا LM Studio (فعلاً فقط نسخهٔ ابری دارند)
- –متن فارسی حساس بدون آزمایش قبلی
تصاویر محیط ابزار
نقاط قوت
- ✓مجوز MIT؛ استفادهٔ تجاری کاملاً آزاد
- ✓طبق Z.ai در برنامهنویسی و کار ایجنتی نزدیک Claude Opus 4.8 است
- ✓متن، عکس و ویدیو را میفهمد؛ برای کدنویسی دیداری و اسناد اداری ساخته شده
- ✓فقط ۱۸ میلیارد پارامتر فعال و توجه ترکیبی؛ هزینهٔ اجرای متن طولانی کم است
- ✓پنجرهٔ متن یک میلیون توکنی
- ✓پشتیبانی رسمی در vLLM، SGLang و KTransformers
نقاط ضعف
- ✗وزن رسمی حدود ۳۲۸ گیگابایت است و ۴ کارت H200 میخواهد؛ ارزانترین راه، نسخهٔ ۲ بیتی روی دستگاه ۱۲۸ گیگابایتی با افت محسوس کیفیت است
- ✗در Ollama و LM Studio فقط نسخهٔ ابری دارد
- ✗تا اواخر سپتامبر ۲۰۲۶ پشتیبانی llama.cpp ادغام نشده بود و GGUF شرکت Unsloth فقط با شاخهٔ خودش کار میکرد؛ از ۳ اکتبر تیم llama.cpp نسخهٔ GGUF رسمی منتشر کرده است
- ✗زبانهای رسمی فقط انگلیسی و چینی است؛ فارسی سنجیده نشده
- ✗همیشه «فکر» میکند و پیشفرضش بیشترین سطح استدلال است؛ برای چت ساده باید سطح را پایین بیاورید
پرسشهای پرتکرار
با چه سختافزاری اجرا میشود؟
راه اصلی: vLLM یا SGLang روی ۴ کارت H200 (یا GB200) با وزن رسمی ۳۲۸ گیگابایتی. راه ارزان: نسخهٔ ۲ بیتی GGUF (حدود ۱۰۲ گیگابایت) روی مک یا کامپیوتر ۱۲۸ گیگابایتی با شاخهٔ llama.cpp شرکت Unsloth؛ کیفیتش محسوس پایینتر است.
چرا در Ollama یا LM Studio نصب نمیشود؟
هر دو فعلاً فقط نسخهٔ ابری آن را دارند که روی سرورهای خودشان اجرا میشود و آفلاین نیست. برای اجرای محلی با llama.cpp، از ۳ اکتبر ۲۰۲۶ نسخهٔ GGUF رسمی تیم llama.cpp (ggml-org/GLM-5.3-Flash-GGUF) هست؛ Q2_K آن حدود ۱۳۴ و Q4_K حدود ۱۸۱ گیگابایت است.
فارسی بلد است؟
زبانهای رسمی کارت مدل انگلیسی و چینی است و آزمون فارسی منتشر نشده. پیش از استفادهٔ جدی، با متنهای خودتان امتحان کنید.
استفادهٔ تجاری آزاد است؟
بله؛ مجوز MIT است و فقط باید متن مجوز را نگه دارید. مدل بزرگتر GLM-5.3 مجوز دیگری دارد؛ این پاسخ فقط دربارهٔ نسخهٔ Flash است.
چطور استدلالش را کم کنم؟
پیشفرض بیشترین سطح (max) است. در درخواست، reasoning_effort را low یا high بگذارید. Z.ai برای چت، clear_thinking=true را هم پیشنهاد میکند.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
کوئن ۳.۸ 27B (آفلاین)
Qwen3.8-27B (offline)
قویترین مدل ۲۷ میلیاردی Qwen (اوت ۲۰۲۶) برای کارت گرافیک ۲۴ گیگابایتی: کدنویسی ایجنتی، کار با سند و تصویر و استدلال، طبق جدول Qwen نزدیک به Qwen3.7-Plus آنلاین، با مجوز Apache 2.0.

دیپسیک ۴ فلش (آفلاین)
DeepSeek-V4-Flash (offline)
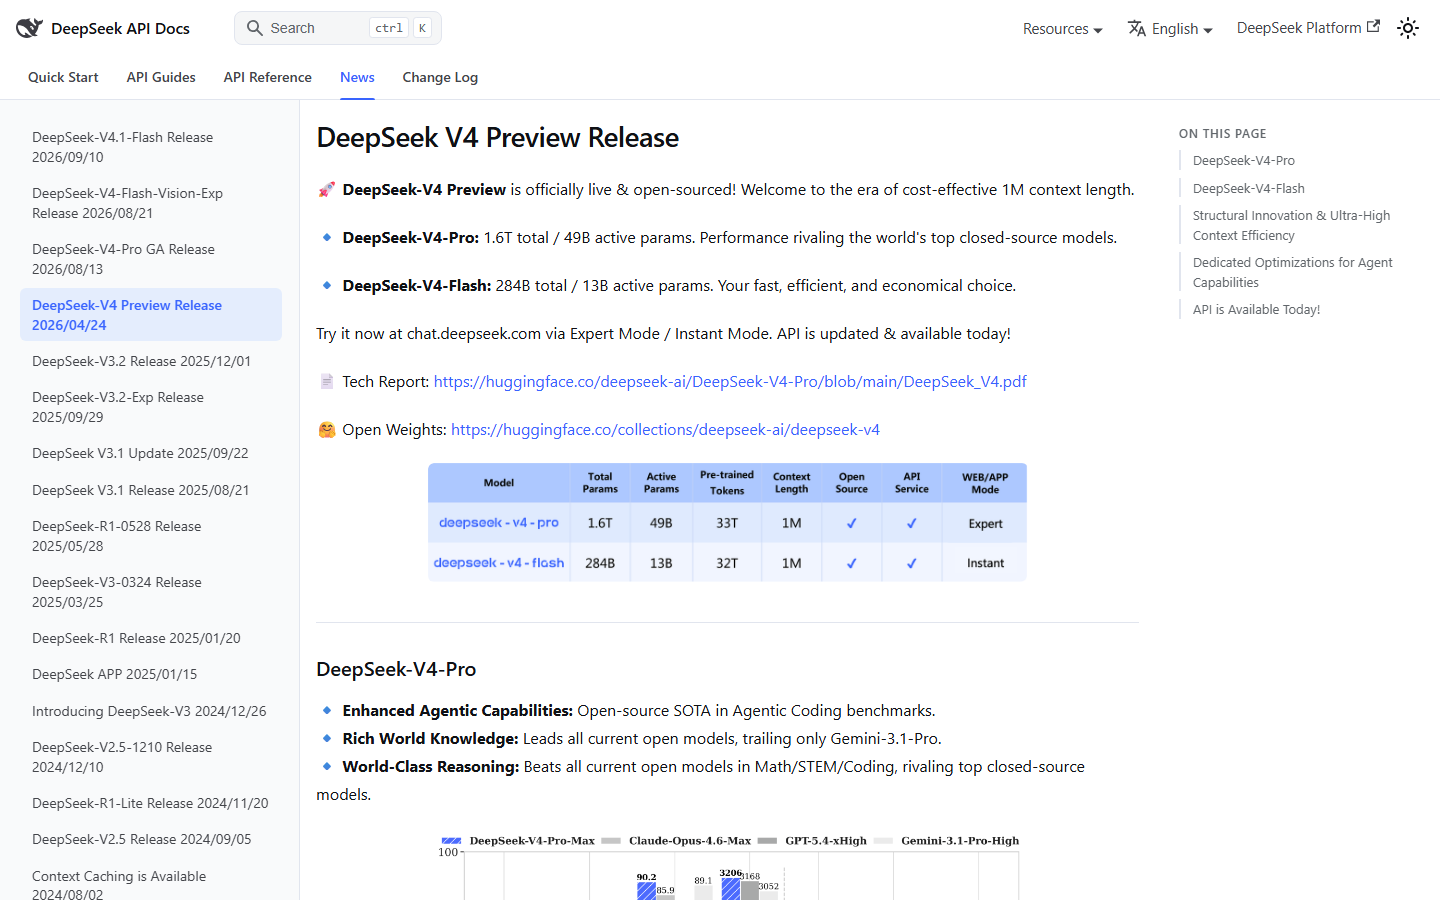
نسخهٔ متنباز DeepSeek-V4-Flash با ۲۸۴ میلیارد پارامتر و متن تا یک میلیون توکن، برای برنامهنویسی و کار ایجنتی؛ روی سرور چندکارته یا دستگاه ۱۲۸ گیگابایتی، با مجوز MIT.
میمو ۲.۶ (آفلاین)
MiMo-V2.6 (offline)
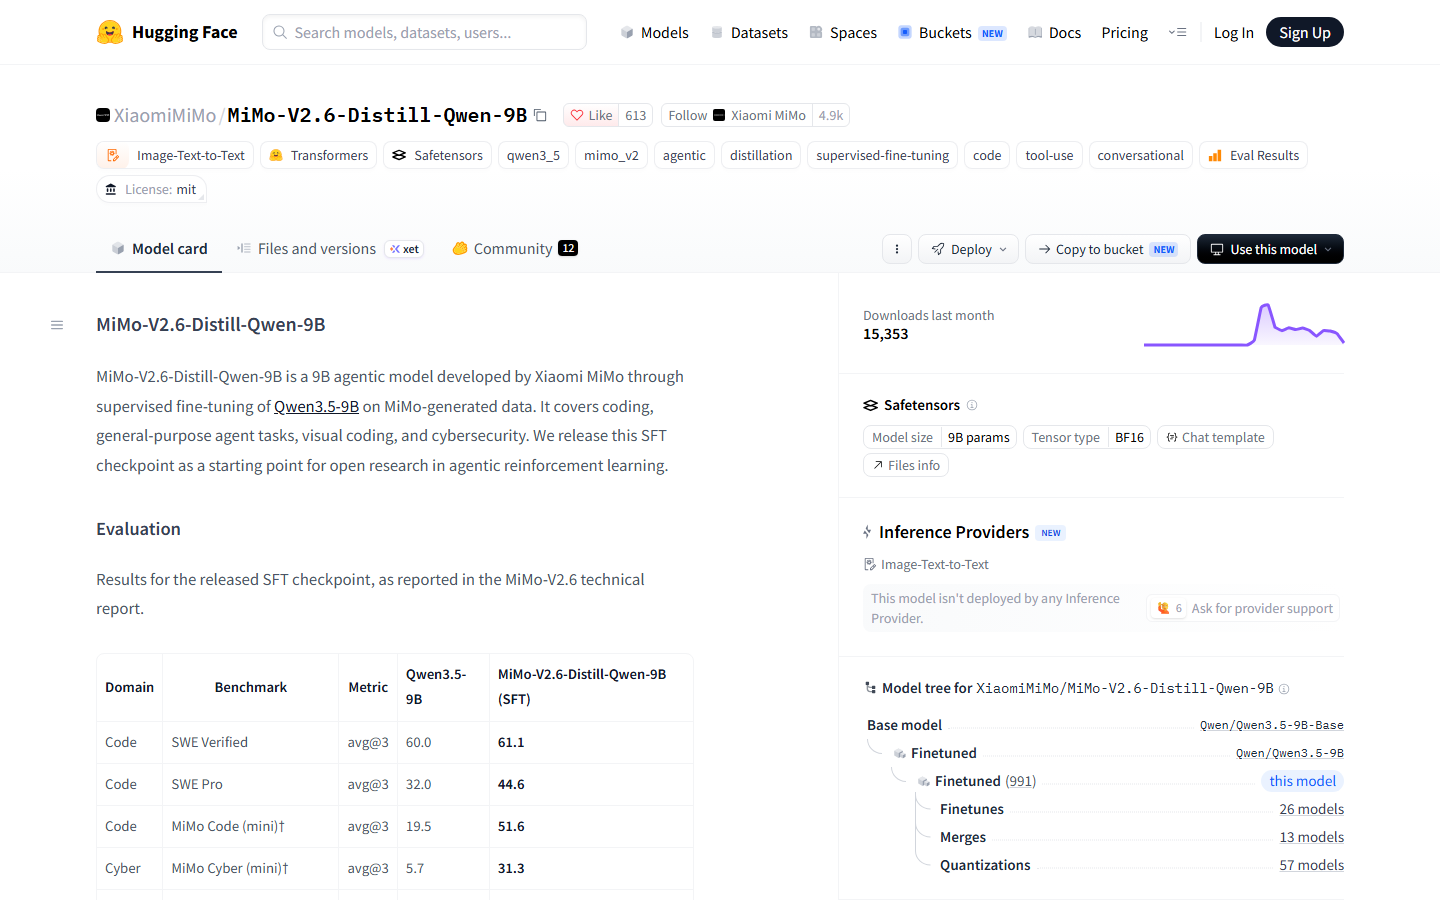
خانوادهٔ مدلهای باز شیائومی (سپتامبر ۲۰۲۶، مجوز MIT) برای کدنویسی ایجنتی و کار با ابزار: نسخهٔ Distill-Qwen-9B با فایل ۵٫۸ گیگابایتی روی لپتاپ ۱۶ گیگابایتی اجرا میشود و Flash و Pro (به گزارش eWeek، Pro بالاترین مدل باز در شاخص Artificial Analysis) سرور چندکارته میخواهند؛ فارسی آزموده نشده است.