گرانیت ۴.۲ (آفلاین)
Granite 4.2 (offline)مدلهای باز IBM (۲۵ اوت ۲۰۲۶) در سه اندازهٔ 3B، 8B و 30B با مجوز Apache-2.0: استدلال با حالت فکر کردن قابل تنظیم، فراخوانی ابزار، جواب از روی سند و خروجی JSON؛ 3B با ۴ گیگابایت رم اجرا میشود، ولی فارسی در فهرست زبانهای رسمیاش نیست.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- Apache-2.0 — استفادهٔ تجاری آزاد
- فارسی: نامعلوم
بعد از دانلود کاملاً بدون اینترنت کار میکند. برای سیستم آفلاین، مدل را روی سیستم متصل pull کنید و پوشهٔ مدلهای Ollama را کپی کنید، یا فایل GGUF رسمی را منتقل و وارد کنید.
استفادهٔ تجاری، تغییر و بازنشر آزاد است؛ اگر مدل را بازنشر میکنید، متن مجوز و اعلانها را همراهش بگذارید.
نسخهها و سختافزار لازم
- 3B۳Bطول متن ۱۲۸ هزار توکن
- حجم دانلود:
- ۲٫۲ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۳ گیگ یا رم ۴ گیگ
ollama run granite4.2:3bحجمها از GGUF رسمی IBM است؛ برچسب Ollama ۲٫۲ گیگابایت است. برای لپتاپ ضعیف و کارهای ساده.
- 8B۸Bطول متن ۱۲۸ هزار توکن
- حجم دانلود:
- ۵٫۴ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۷ گیگ یا رم ۸ گیگ
ollama run granite4.2:8bهمان برچسب پیشفرض (latest) در Ollama، ۵٫۳ گیگابایت. ۱۶ گیگابایت رم راحت است.
- 30B۲۹٫۳Bطول متن ۱۲۸ هزار توکن
- حجم دانلود:
- ۱۷٫۷ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۲۴ گیگ یا رم ۳۲ گیگ
ollama run granite4.2:30bبرچسب Ollama ۱۸ گیگابایت است. متراکم است و روی پردازنده کند. Ollama برچسب 30b-bf16 را ۴۵ گیگابایت نشان میدهد که با ۵۸٫۵۶ گیگابایت Hugging Face نمیخواند؛ دلیلش تأیید نشده.
نصب و اجرا
- ۱
Ollama را روی ویندوز نصب کنیدویندوز
irm https://ollama.com/install.ps1 | iexاین دستور را در PowerShell بزنید (ویندوز ۱۰ به بعد). فایل نصبی OllamaSetup.exe هم در صفحهٔ دانلود Ollama و بخش Releases گیتهاب آن هست.
- ۲
Ollama را روی لینوکس یا مک نصب کنیدلینوکس
curl -fsSL https://ollama.com/install.sh | shهمین دستور روی مک (macOS 14 به بعد) هم کار میکند؛ روی مک میتوانید فایل نصبی را هم از سایت Ollama بگیرید.
- ۳
مدل را دانلود و اجرا کنید
ollama run granite4.2:8bحدود ۵٫۳ گیگابایت دانلود میشود و بعد آفلاین کار میکند. برای سیستم ضعیفتر granite4.2:3b (۲٫۲ گیگابایت) و برای کارت ۲۴ گیگابایتی granite4.2:30b (۱۸ گیگابایت) را بزنید.
- ۴
یا با LM Studio
LM Studio را از lmstudio.ai نصب کنید و granite-4.2 را جستوجو کنید؛ نسخههای GGUF و MLX از lmstudio-community (۲۵ اوت) آمادهاند.
- ۵
یا با llama.cpp و GGUF رسمی
llama serve -hf ibm-granite/granite-4.2-8b-GGUF:Q4_K_Mفایل Q4_K_M رسمی ۵٫۳۵ گیگابایت است؛ رابط وب روی http://127.0.0.1:8080 باز میشود.
- ۶
روی سرور با vLLMلینوکس
vllm serve ibm-granite/granite-4.2-8b --api-key CHANGE_MEAPI سازگار با OpenAI روی http://localhost:8000/v1 باز میشود. برای 30B مخزن ibm-granite/granite-4.2-30b را بدهید.
دانلود
- Ollama: granite4.2 ↗رسمی
برچسبهای 3b، 8b و 30b در چند سطح فشردهسازی.
- ibm-granite/granite-4.2-8b-GGUF ↗رسمی
GGUF رسمی IBM؛ مخزنهای همنام برای 3B و 30B هم هست.
- ibm-granite/granite-4.2-8b ↗رسمی
وزنهای اصلی برای vLLM و Transformers، با کارت مدل.
- lmstudio-community GGUF (8B) ↗غیررسمی
فایلهایی که LM Studio دانلود میکند؛ ساخت IBM نیست.
- معرفی Granite 4.2 ↗رسمی
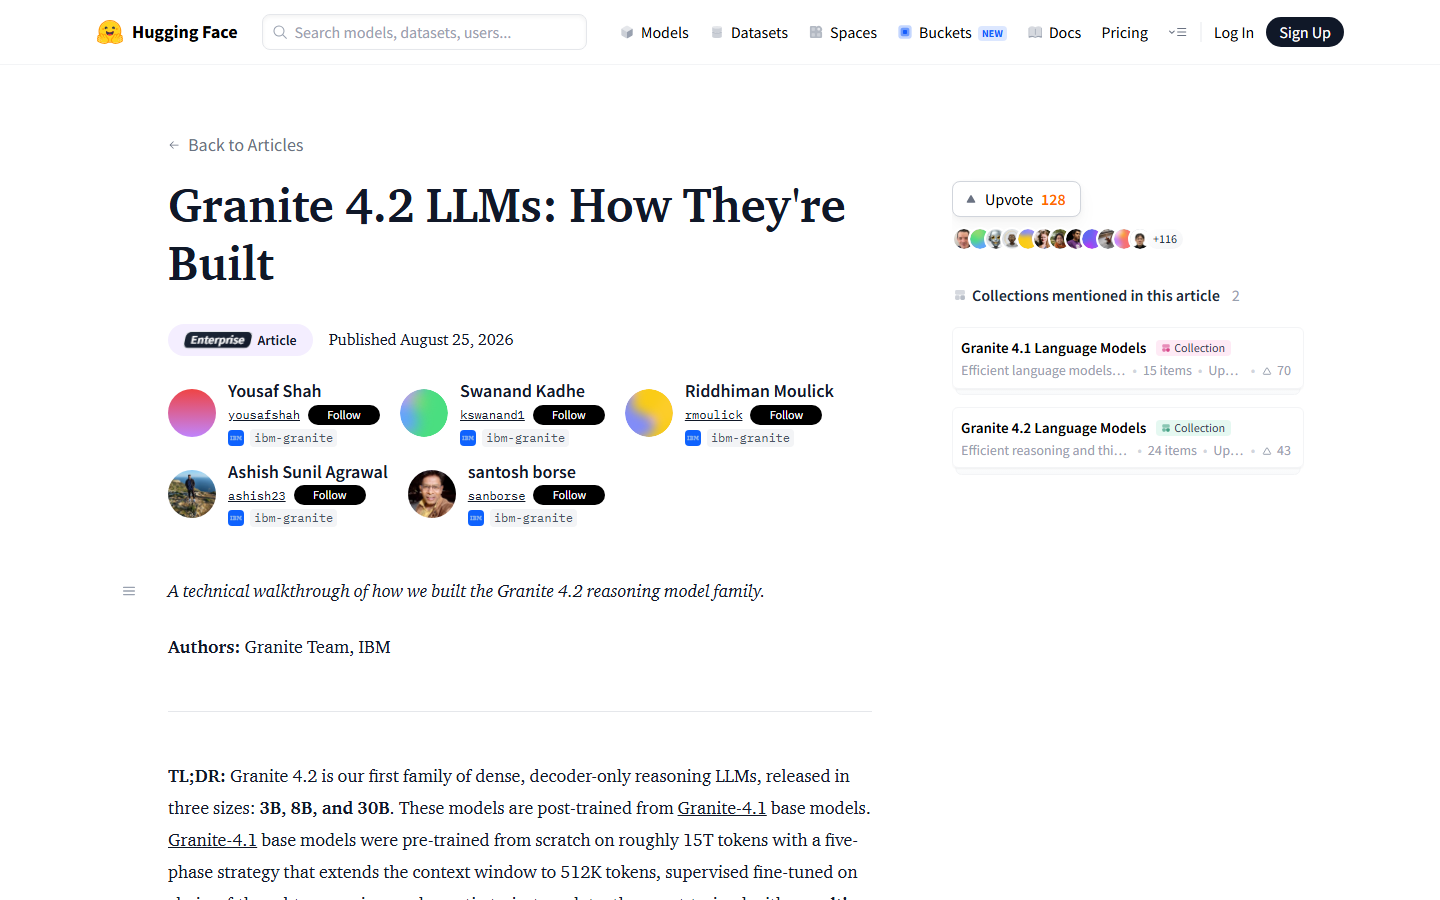
وبلاگ فنی IBM در Hugging Face.
نکات امنیتی
- پورت 11434 را روی اینترنت باز نکنید: Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و API آن رمز ندارد. سرورهای llama.cpp و vLLM را هم بدون کلید دسترسی (--api-key) روی شبکه باز نکنید.
- فایل مدل را فقط از مخزن رسمی سازنده یا منبع شناختهشده بگیرید، GGUF یا safetensors را به فایلهای pickle (.bin یا .pt) ترجیح دهید و هش SHA256 فایل را با صفحهٔ دانلود مقایسه کنید.
- اگر به مدل اجازهٔ اجرای دستور، دسترسی به فایل یا ابزار میدهید (حالت ایجنت)، کارهای برگشتناپذیر مثل پاککردن و ارسال را فقط با تأیید دستی انجام دهید.
برای شرکتها و سازمانها
برای سرور شرکت، وزنهای رسمی ibm-granite را با vLLM سرو کنید؛ مجوز Apache-2.0 شرط اضافهای برای کار تجاری ندارد. ارائهٔ نسخهٔ ۴.۲ در IBM watsonx.ai تأیید نشده است.
برنامههایی که این مدل را اجرا میکنند
 اولاما
 الام استودیو
 لاما سیپیپی
 ویالالام
همسطح ابری
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۴ مرداد ۱۴۰۵
معرفی: گرانیت ۴.۲ (آفلاین)
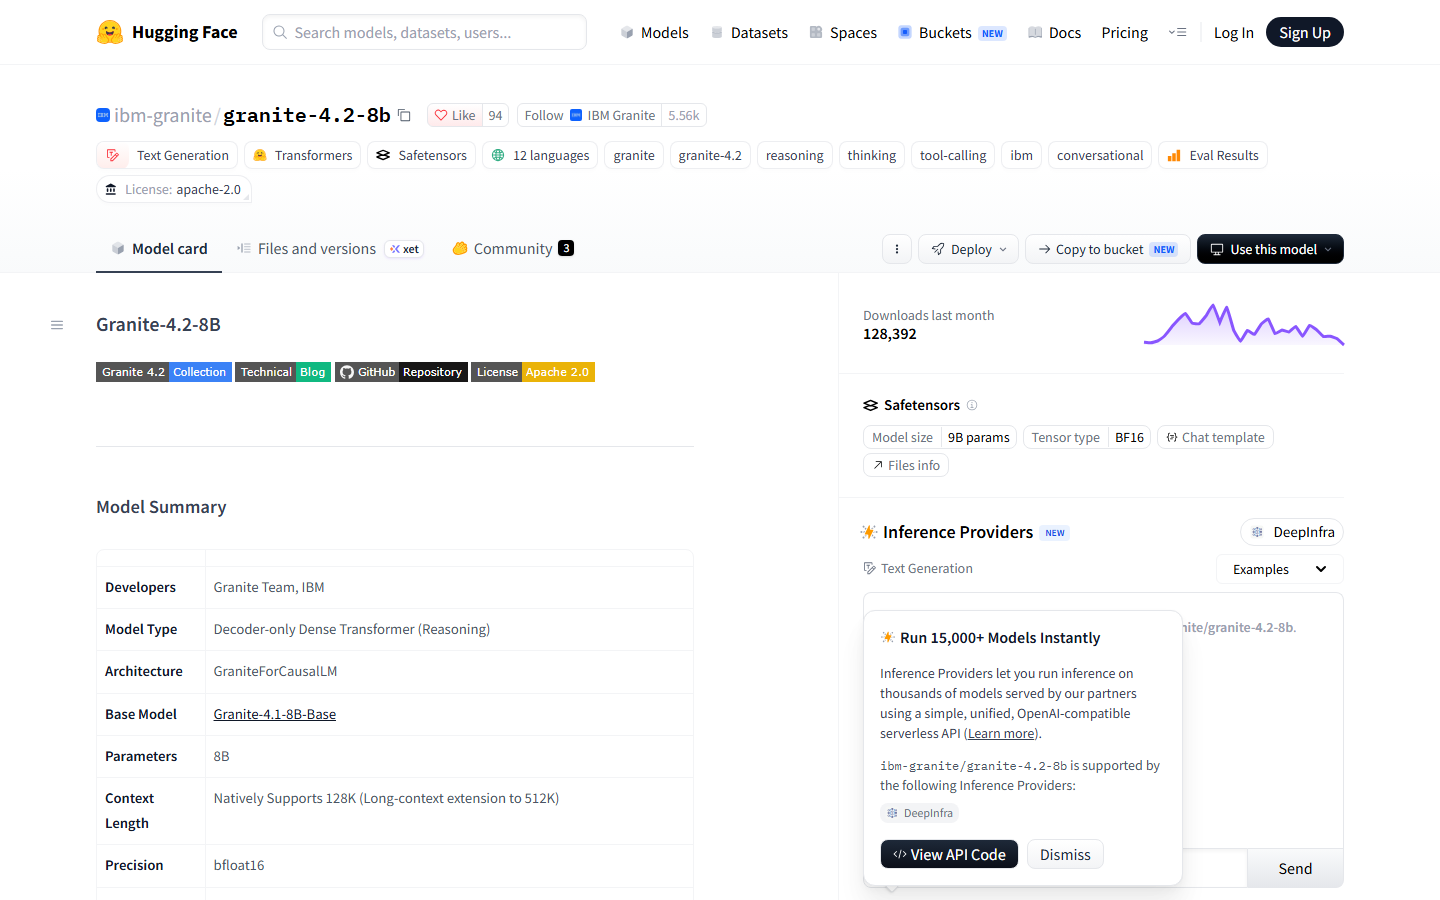
Granite 4.2 نسل تازهٔ مدلهای باز IBM است که ۲۵ اوت ۲۰۲۶ با مجوز Apache-2.0 منتشر شد. سه اندازه دارد، 3B، 8B و 30B، هر سه متراکم (نه MoE) و با حافظهٔ متنی ۱۲۸ هزار توکنی که به گفتهٔ کارت مدل تا ۵۱۲ هزار قابل افزایش است. فقط متن میگیرد و متن میدهد.
کاربرد اصلیاش کارهای سازمانی است: استدلال با حالت فکر کردن که میشود کامل، کم یا خاموشش کرد، فراخوانی ابزار، جوابدادن از روی سند (RAG)، خروجی JSON ساختاریافته و چت سازمانی. مجوز ساده و بیشرطش برای شرکتها مهم است.
سختافزار: 3B با فایل ۴ بیتی ۲٫۲ گیگابایتی روی ۴ گیگابایت رم اجرا میشود. 8B حدود ۵٫۳ گیگابایت است و ۸ گیگابایت رم میخواهد (۱۶ گیگابایت راحت است). 30B حدود ۱۸ گیگابایت است و کارت گرافیک ۲۴ گیگابایتی یا ۳۲ گیگابایت رم میخواهد؛ چون متراکم است، روی پردازنده کند است.
شروع: بعد از نصب Ollama بزنید ollama run granite4.2:8b، یا در LM Studio عبارت granite-4.2 را جستوجو کنید. IBM فایلهای GGUF و MLX رسمی هم داده و llama.cpp و vLLM هم اجرایش میکنند.
محدودیت: فارسی در فهرست زبانهای آزمودهشده نیست (انگلیسی، آلمانی، اسپانیایی، فرانسوی، ژاپنی، پرتغالی، عربی، چکی، ایتالیایی، کرهای، هلندی و چینی). IBM میگوید زبانهای دیگر ممکن است کار کنند ولی کامل آزموده نشدهاند؛ برای کار فارسی Qwen3.5 مطمئنتر است.
بهترین کاربردها
- •روی سرور شرکت یک مدل باز با مجوز Apache برای جوابدادن از روی اسناد داخلی راه بیندازم
- •آفلاین روی لپتاپ خودم از متن انگلیسی خروجی JSON ساختاریافته بگیرم
- •یک مدل کوچک و تجاریآزاد برای فراخوانی ابزار روی کامپیوتر خودم بدون اینترنت داشته باشم
- •روی کامپیوتر ضعیف با ۴ گیگابایت رم یک دستیار متنی انگلیسی آفلاین داشته باشم
- •مدل سازمانی IBM را روی سرور شرکت خودمان بدون فرستادن داده به بیرون اجرا کنم
برای این کارها سراغش نروید
- –نوشتن یا خلاصهکردن متن فارسی
- –خواندن تصویر یا سند اسکنشده
- –ترجمه به فارسی
- –ساخت تصویر
تصاویر محیط ابزار
نقاط قوت
- ✓مجوز Apache-2.0 بدون شرط؛ مناسب کار تجاری و سازمانی
- ✓سه اندازه از ۲٫۲ تا ۱۸ گیگابایت؛ 3B حتی روی ۴ گیگابایت رم
- ✓حالت فکر کردن قابل تنظیم: کامل، کم یا خاموش
- ✓فراخوانی ابزار، جواب از روی سند (RAG) و خروجی JSON ساختاریافته
- ✓فایلهای GGUF و MLX رسمی IBM و برچسبهای آمادهٔ Ollama
نقاط ضعف
- ✗8B دستکم ۸ گیگابایت رم و 30B کارت ۲۴ گیگابایتی یا ۳۲ گیگابایت رم میخواهد و چون متراکم است روی پردازنده کند است
- ✗فارسی در فهرست زبانهای رسمی نیست و آزموده نشده
- ✗فقط متن؛ تصویر و سند اسکنشده نمیخواند
- ✗حجم نسخهٔ bf16 مدل 30B در Ollama (۴۵ گیگابایت) با Hugging Face (۵۸٫۵۶ گیگابایت) نمیخواند و دلیلش تأیید نشده
قیمتگذاری
رایگان (وزنهای باز)
Free (open weights)رایگان
- • دانلود و اجرای هر سه اندازه روی سختافزار خودتان
- • استفادهٔ تجاری آزاد با مجوز Apache-2.0
قیمتها تقریبی و بر اساس آخرین بازبینی است؛ برای قیمت دقیق به سایت رسمی مراجعه کنید.
پرسشهای پرتکرار
کدام اندازهٔ گرانیت ۴.۲ را بگیرم؟
با ۴ تا ۸ گیگابایت رم نسخهٔ 3B (۲٫۲ گیگابایت)، با ۱۶ گیگابایت رم نسخهٔ 8B (۵٫۳ گیگابایت) و با کارت گرافیک ۲۴ گیگابایتی یا ۳۲ گیگابایت رم نسخهٔ 30B (۱۸ گیگابایت). 30B متراکم است و روی پردازنده کند کار میکند.
فارسی بلد است؟
رسمی نه. فهرست زبانهای آزمودهشدهٔ IBM انگلیسی، آلمانی، اسپانیایی، فرانسوی، ژاپنی، پرتغالی، عربی، چکی، ایتالیایی، کرهای، هلندی و چینی است و فارسی در آن نیست. IBM میگوید زبانهای دیگر ممکن است کار کنند ولی کامل آزموده نشدهاند. برای کار فارسی Qwen3.5 مطمئنتر است.
برای کار تجاری آزاد است؟
بله. مجوز Apache-2.0 است: استفادهٔ تجاری، تغییر و ساخت محصول روی آن آزاد است؛ فقط هنگام بازنشر متن مجوز و اعلانها را همراه کنید.
چطور نصبش کنم؟
Ollama را نصب کنید و بزنید ollama run granite4.2:8b (یا granite4.2:3b و granite4.2:30b). در LM Studio هم granite-4.2 را جستوجو کنید. برای سیستم بدون اینترنت، فایل GGUF رسمی را از مخزن ibm-granite/granite-4.2-8b-GGUF بگیرید و با Modelfile و دستور ollama create وارد کنید.
برای سرور شرکت مناسب است؟
بله، برای کارهای انگلیسی و زبانهای فهرستش: فراخوانی ابزار، RAG و خروجی JSON را خوب پشتیبانی میکند و مجوزش شرطی ندارد. وزنهای رسمی را با vLLM سرو کنید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه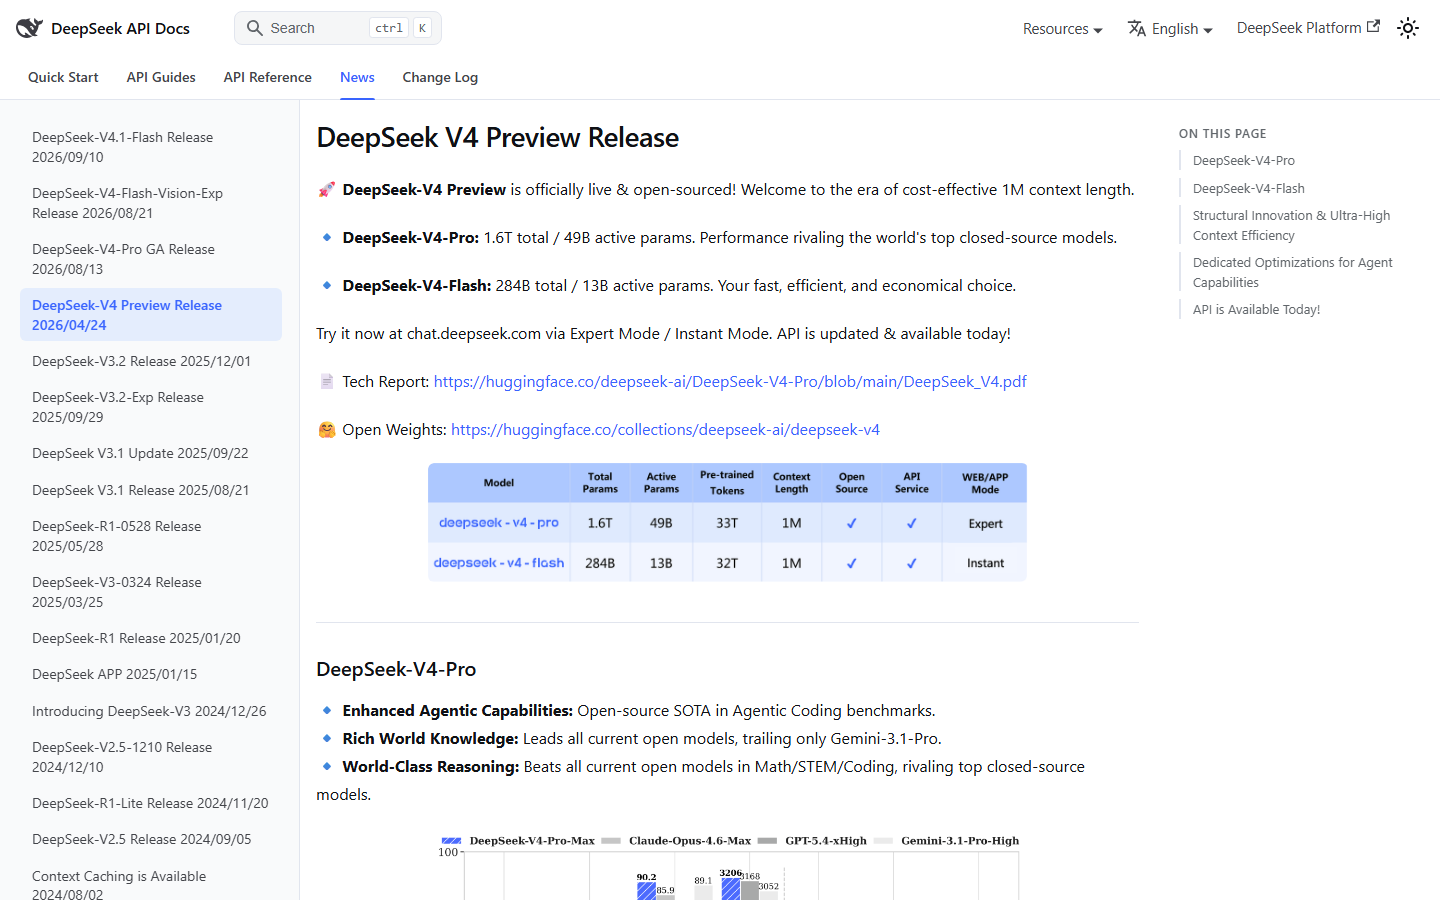

دیپسیک ۴ فلش (آفلاین)
DeepSeek-V4-Flash (offline)
نسخهٔ متنباز DeepSeek-V4-Flash با ۲۸۴ میلیارد پارامتر و متن تا یک میلیون توکن، برای برنامهنویسی و کار ایجنتی؛ روی سرور چندکارته یا دستگاه ۱۲۸ گیگابایتی، با مجوز MIT.
اوپن وبیوآی
Open WebUI
رابطی شبیه ChatGPT که روی لپتاپ یا سرور خودتان نصب میشود و به Ollama یا هر API سازگار با OpenAI وصل میشود؛ با گفتوگو با اسناد، مدیریت کاربران، LDAP و ورود یکپارچه (SSO).
کوئن ۳.۸ 27B (آفلاین)
Qwen3.8-27B (offline)
قویترین مدل ۲۷ میلیاردی Qwen (اوت ۲۰۲۶) برای کارت گرافیک ۲۴ گیگابایتی: کدنویسی ایجنتی، کار با سند و تصویر و استدلال، طبق جدول Qwen نزدیک به Qwen3.7-Plus آنلاین، با مجوز Apache 2.0.