مینیسیپیام ۵ (آفلاین)
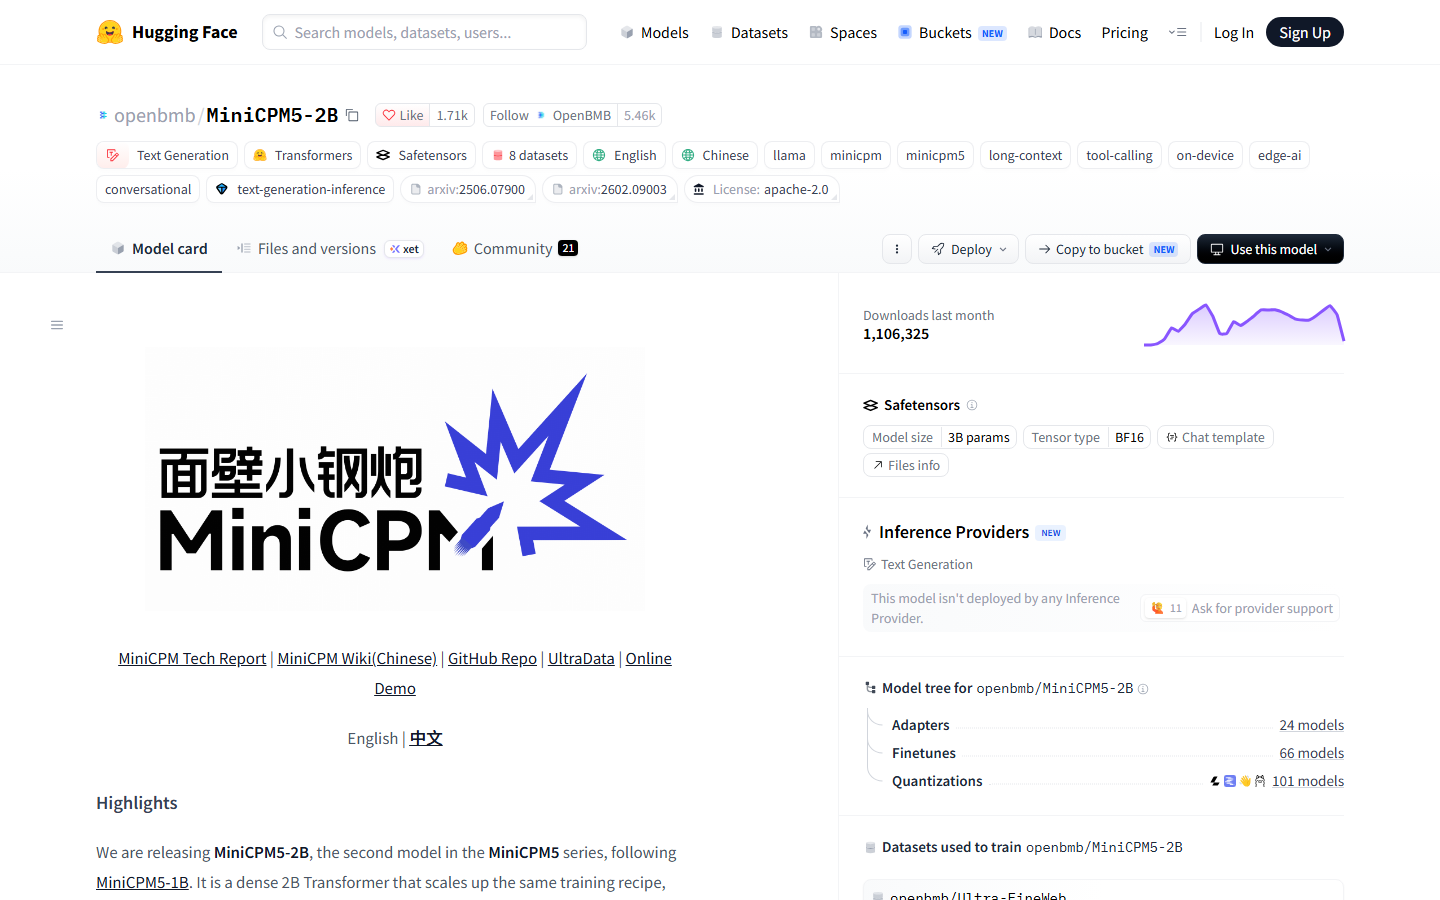
MiniCPM5 (offline)مدلهای خیلی کوچک OpenBMB برای اجرا روی خود دستگاه (۲۰۲۶، مجوز Apache-2.0): MiniCPM5-2B با فایل ۱٫۵۶ گیگابایتی روی ۴ گیگابایت رم و MiniCPM5-1B با کمتر از ۷۰۰ مگابایت، با حافظهٔ متنی ۱۲۸ هزار توکنی و فراخوانی ابزار؛ نسخهٔ گوشی هم دارد، ولی فهرست رسمی زبانهایش فقط انگلیسی و چینی است.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- Apache-2.0 — استفادهٔ تجاری آزاد
- فارسی: نامعلوم
بعد از دانلود کاملاً بدون اینترنت کار میکند. برای سیستم آفلاین، فایل GGUF رسمی (۱٫۵۶ گیگابایت) را منتقل کنید یا پوشهٔ مدلهای Ollama را از سیستمی که مدل را گرفته کپی کنید.
استفادهٔ تجاری، تغییر و بازنشر آزاد است؛ اگر مدل را بازنشر میکنید، متن مجوز را همراهش بگذارید.
نسخهها و سختافزار لازم
- 2B۲٫۵Bطول متن ۱۲۸ هزار توکن
- حجم دانلود:
- ۱٫۶ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۲ گیگ یا رم ۴ گیگ
ollama run hf.co/openbmb/MiniCPM5-2B-GGUF:Q4_K_M۶ سپتامبر ۲۰۲۶. حجمها از GGUF رسمی است (حجم ۱۶ بیتی برای F16). Ollama برچسب رسمی 2B ندارد و این دستور فایل GGUF رسمی را مستقیم از Hugging Face میگیرد. نسخهٔ MLX برای مک، GPTQ چهار بیتی و LiteRT برای گوشی هم هست.
- 1B۱٫۱Bطول متن ۱۲۸ هزار توکن
- حجم دانلود:
- ۰٫۷ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۱ گیگ یا رم ۳ گیگ
ollama run openbmb/minicpm5۲۱ مه ۲۰۲۶. برچسب Ollama در فضای خود سازنده، ۶۸۸ مگابایت. برای سیستمهای خیلی ضعیف و کارهای ساده.
نصب و اجرا
- ۱
Ollama را روی ویندوز نصب کنیدویندوز
irm https://ollama.com/install.ps1 | iexاین دستور را در PowerShell بزنید (ویندوز ۱۰ به بعد). فایل نصبی OllamaSetup.exe هم در صفحهٔ دانلود Ollama و بخش Releases گیتهاب آن هست.
- ۲
Ollama را روی لینوکس یا مک نصب کنیدلینوکس
curl -fsSL https://ollama.com/install.sh | shهمین دستور روی مک (macOS 14 به بعد) هم کار میکند؛ روی مک میتوانید فایل نصبی را هم از سایت Ollama بگیرید.
- ۳
نسخهٔ 2B را دانلود و اجرا کنید
ollama run hf.co/openbmb/MiniCPM5-2B-GGUF:Q4_K_Mحدود ۱٫۶ گیگابایت دانلود میشود و بعد آفلاین کار میکند. Ollama برچسب رسمی 2B ندارد و این دستور فایل GGUF رسمی OpenBMB را از Hugging Face میگیرد.
- ۴
برای سیستم خیلی ضعیف: نسخهٔ 1B
ollama run openbmb/minicpm5۶۸۸ مگابایت، در فضای خود سازنده در Ollama.
- ۵
یا با LM Studio
LM Studio را از lmstudio.ai نصب کنید و MiniCPM5-2B را جستوجو کنید (GGUF رسمی؛ روی مک نسخهٔ MLX).
- ۶
یا با llama.cpp
llama serve -hf openbmb/MiniCPM5-2B-GGUF:Q4_K_Mپشتیبانی توکنایزر و parser این مدل از مه و ژوئن به llama.cpp اضافه شده؛ نسخهٔ تازه بگیرید. رابط وب روی http://127.0.0.1:8080 باز میشود.
دانلود
- openbmb/MiniCPM5-2B-GGUF ↗رسمی
GGUF رسمی از Q4_K_M (۱٫۵۶ گیگابایت) تا F16.
- openbmb/MiniCPM5-2B ↗رسمی
وزنهای اصلی و کارت مدل.
- Ollama: openbmb/minicpm5 (1B) ↗رسمی
نسخهٔ 1B در فضای خود سازنده.
- openbmb/MiniCPM5-2B-MLX ↗رسمی
نسخهٔ رسمی برای مکهای اپل سیلیکون.
- litert-community/MiniCPM5-2B ↗غیررسمی
نسخهٔ LiteRT برای گوشی، برای اجرا با LiteRT-LM.
- GitHub: OpenBMB/MiniCPM ↗رسمی
راهنمای اجرا با Transformers، vLLM، SGLang و llama.cpp.
نکات امنیتی
- پورت 11434 را روی اینترنت باز نکنید: Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و API آن رمز ندارد. سرورهای llama.cpp و vLLM را هم بدون کلید دسترسی (--api-key) روی شبکه باز نکنید.
- فایل مدل را فقط از مخزن رسمی سازنده یا منبع شناختهشده بگیرید، GGUF یا safetensors را به فایلهای pickle (.bin یا .pt) ترجیح دهید و هش SHA256 فایل را با صفحهٔ دانلود مقایسه کنید.
برای شرکتها و سازمانها
برای گذاشتن داخل برنامه یا سرور سبک، vLLM (0.21 به بعد) و SGLang (0.5.16 به بعد) پشتیبانی میکنند؛ نسخهٔ GPTQ چهار بیتی و مدل کمکی DSpark برای پیشبینی سریعتر هم منتشر شده است.
برنامههایی که این مدل را اجرا میکنند
 اولاما
 الام استودیو
 لاما سیپیپی
 ویالالام
همسطح ابری
آخرین بررسی: ۱۲ مهر ۱۴۰۵ · انتشار: ۲۵ اردیبهشت ۱۴۰۵
معرفی: مینیسیپیام ۵ (آفلاین)
MiniCPM5 مدلهای کوچک OpenBMB (از ModelBest و گروه NLP دانشگاه Tsinghua) برای اجرا روی خود دستگاهاند. MiniCPM5-1B ۲۱ مه ۲۰۲۶ و MiniCPM5-2B ۶ سپتامبر ۲۰۲۶ منتشر شد. هر دو متراکماند، مجوز Apache-2.0 دارند، فقط متن میگیرند و متن میدهند و حافظهٔ متنی ۱۲۸ هزار توکنی دارند. 2B حدود ۱٫۱ میلیون بار دانلود شده است.
کاربرد: دستیار محلی جمعوجور، فراخوانی ابزار، و کدنویسی و ریاضی در حد اندازهاش. در جدول مقایسهٔ خود سازنده میانگین 2B ۵۳٫۹ است، بالاتر از Qwen3.5-4B (۵۱٫۱) و granite-4.2-3B (۴۲٫۷).
سختافزار: فایل ۴ بیتی 2B ۱٫۵۶ گیگابایت است و با ۴ گیگابایت رم اجرا میشود؛ 1B در ۴ بیتی ۰٫۶۹ گیگابایت است. برای لپتاپهای ضعیف و قدیمی ساخته شدهاند و کارت گرافیک برایشان ضروری نیست. نسخهٔ LiteRT مخصوص گوشی هم در مخزن litert-community منتشر شده است.
شروع: 2B در Ollama برچسب رسمی ندارد؛ بزنید ollama run hf.co/openbmb/MiniCPM5-2B-GGUF:Q4_K_M. نسخهٔ 1B در فضای خود سازنده در Ollama است: ollama run openbmb/minicpm5. در LM Studio هم MiniCPM5-2B را جستوجو کنید. llama.cpp، MLX، vLLM و SGLang هم پشتیبانی میکنند.
محدودیت: فهرست رسمی زبانها فقط انگلیسی و چینی است و فارسی آزموده نشده؛ احتمالاً ضعیف است. برای متن فارسی یا استدلال سنگین، مدل بزرگتری مثل Qwen3.5 لازم است.
بهترین کاربردها
- •روی لپتاپ خیلی ضعیف یا قدیمی یک دستیار هوش مصنوعی آفلاین داشته باشم
- •یک مدل زیر ۲ گیگابایت را روی کامپیوتر یا گوشی خودم بدون اینترنت اجرا کنم
- •داخل برنامهٔ خودم یک مدل زبانی کوچک و تجاریآزاد بگذارم که آفلاین کار کند
- •با ۴ گیگابایت رم یک مدل با فراخوانی ابزار روی سیستم خودم اجرا کنم
- •آفلاین روی کامپیوتر خودم جواب سؤالهای ساده برنامهنویسی و ریاضی را بگیرم
برای این کارها سراغش نروید
- –نوشتن یا ترجمهٔ متن فارسی
- –استدلال سنگین و کارهای پیچیده
- –فهم تصویر
- –کدنویسی ایجنتی جدی
تصاویر محیط ابزار
نقاط قوت
- ✓خیلی سبک: 2B با ۱٫۵۶ و 1B با ۰٫۶۹ گیگابایت در ۴ بیتی
- ✓حافظهٔ متنی ۱۲۸ هزار توکنی و فراخوانی ابزار
- ✓در جدول سازنده بالاتر از Qwen3.5-4B با نصف اندازه
- ✓مجوز Apache-2.0؛ تجاری آزاد
- ✓فایلهای رسمی GGUF، MLX و GPTQ، بهعلاوهٔ نسخهٔ LiteRT برای گوشی
نقاط ضعف
- ✗2B دستکم ۴ گیگابایت رم میخواهد و در این اندازه برای کارهای سبک مناسب است، نه استدلال سنگین
- ✗فهرست رسمی زبانها فقط انگلیسی و چینی است؛ فارسی آزموده نشده و احتمالاً ضعیف است
- ✗فقط متن؛ تصویر نمیفهمد
- ✗2B در Ollama برچسب رسمی ندارد و از مسیر hf.co اجرا میشود
قیمتگذاری
رایگان (وزنهای باز)
Free (open weights)رایگان
- • دانلود و اجرای 1B و 2B روی دستگاه خودتان
- • استفادهٔ تجاری آزاد با مجوز Apache-2.0
قیمتها تقریبی و بر اساس آخرین بازبینی است؛ برای قیمت دقیق به سایت رسمی مراجعه کنید.
پرسشهای پرتکرار
روی کامپیوتر خیلی ضعیف اجرا میشود؟
بله، برای همین ساخته شده. فایل ۴ بیتی 2B ۱٫۵۶ گیگابایت است و با ۴ گیگابایت رم اجرا میشود؛ 1B فقط ۰٫۶۹ گیگابایت است. کارت گرافیک برایشان ضروری نیست. در این اندازه برای کارهای سبک مثل جواب کوتاه، دستهبندی متن و فراخوانی ابزار مناسباند.
فارسی بلد است؟
فهرست رسمی زبانها فقط انگلیسی و چینی است و فارسی آزموده نشده؛ احتمالاً ضعیف است. برای متن فارسی روی لپتاپ، Qwen3.5 (مثلاً 4B یا 9B) گزینهٔ بهتری است.
روی گوشی اجرا میشود؟
نسخهٔ LiteRT آن (litert-community/MiniCPM5-2B) برای گوشی منتشر شده و با موتور LiteRT-LM اجرا میشود. اینکه کدام برنامهٔ گوشی آن را مستقیم بارگذاری میکند در این بررسی تأیید نشده است.
چطور نصبش کنم؟
Ollama را نصب کنید و بزنید ollama run hf.co/openbmb/MiniCPM5-2B-GGUF:Q4_K_M، یا برای 1B بزنید ollama run openbmb/minicpm5. در LM Studio هم MiniCPM5-2B را جستوجو کنید. برای سیستم بدون اینترنت، فایل GGUF رسمی را منتقل کنید و با Modelfile و ollama create وارد کنید.
برای کار تجاری آزاد است؟
بله. مجوز Apache-2.0 است و میتوانید آن را داخل محصول یا برنامهٔ خودتان بگذارید؛ فقط هنگام بازنشر متن مجوز را همراه کنید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
کوئن ۳.۸ 27B (آفلاین)
Qwen3.8-27B (offline)
قویترین مدل ۲۷ میلیاردی Qwen (اوت ۲۰۲۶) برای کارت گرافیک ۲۴ گیگابایتی: کدنویسی ایجنتی، کار با سند و تصویر و استدلال، طبق جدول Qwen نزدیک به Qwen3.7-Plus آنلاین، با مجوز Apache 2.0.
میمو ۲.۶ (آفلاین)
MiMo-V2.6 (offline)
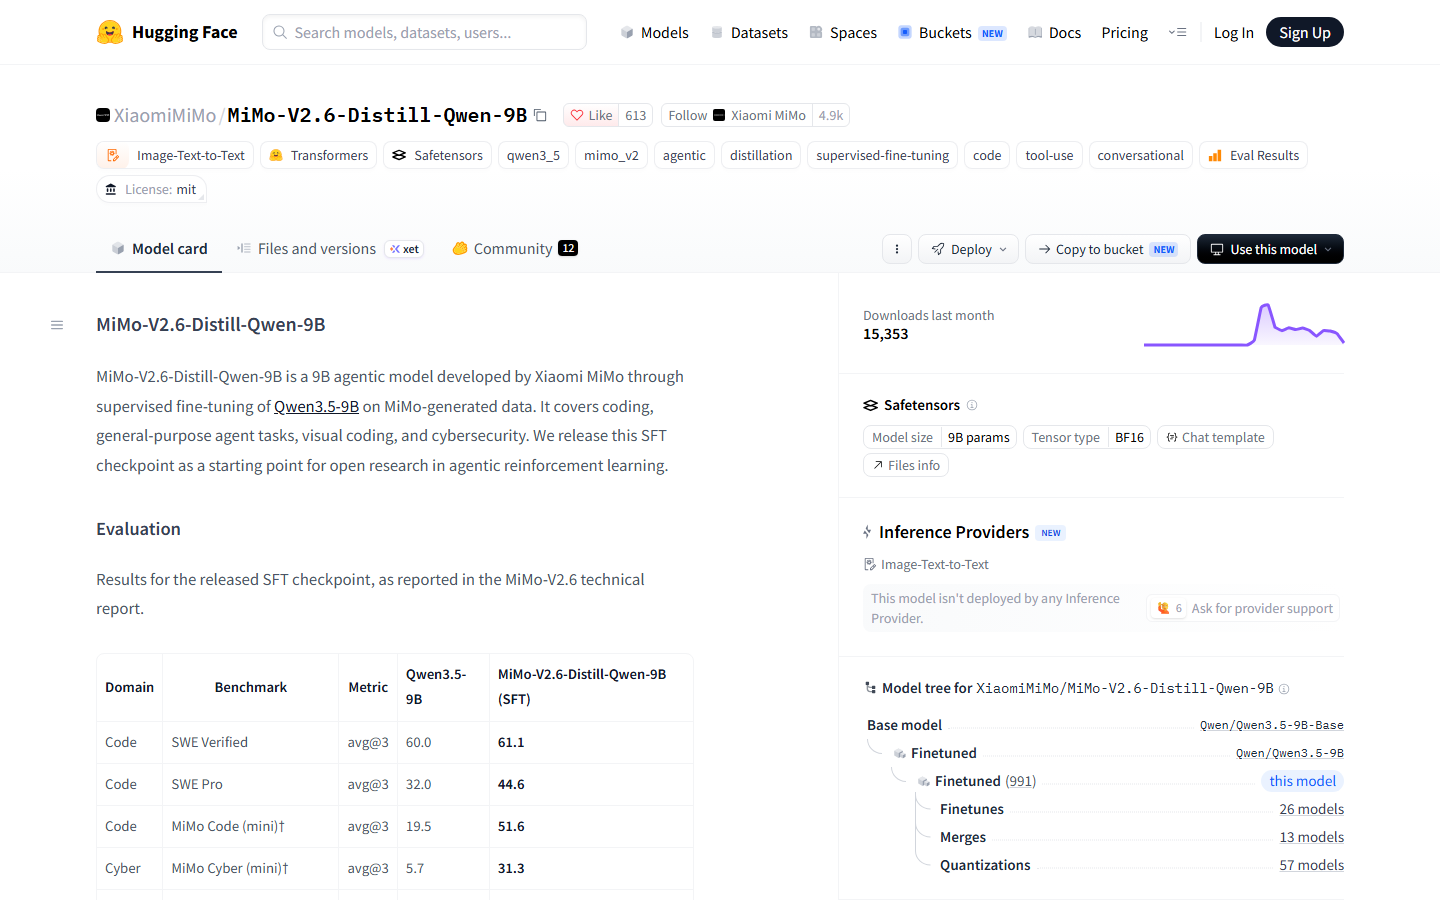
خانوادهٔ مدلهای باز شیائومی (سپتامبر ۲۰۲۶، مجوز MIT) برای کدنویسی ایجنتی و کار با ابزار: نسخهٔ Distill-Qwen-9B با فایل ۵٫۸ گیگابایتی روی لپتاپ ۱۶ گیگابایتی اجرا میشود و Flash و Pro (به گزارش eWeek، Pro بالاترین مدل باز در شاخص Artificial Analysis) سرور چندکارته میخواهند؛ فارسی آزموده نشده است.
جما ۴ (آفلاین)
Gemma 4 (offline)
خانوادهٔ مدل باز گوگل که روی لپتاپ یا کامپیوتر خودتان و بدون اینترنت اجرا میشود: چت، خلاصهنویسی، کدنویسی و فهم تصویر در پنج اندازه از E2B تا 31B، با مجوز آزاد Apache 2.0.