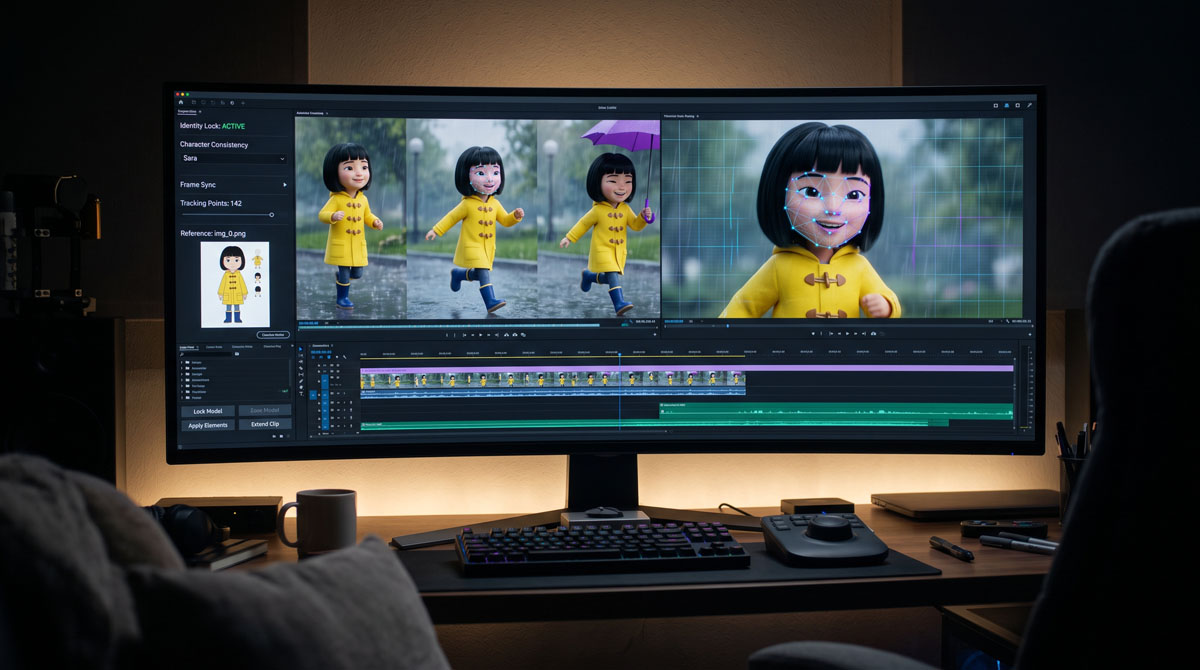
ریل سیثانیهایتان تقریباً آماده است. در نمای اول، سارا، دختر نهسالهای با بارانی زرد، زیر باران میدود. در نمای سوم صورتش گردتر شده و بارانیاش به نارنجی میزند و در نمای آخر بیشتر شبیه خالهاش است تا خودش. اگر ساخت ویدئو با هوش مصنوعی را برای قصهگویی امتحان کرده باشید، این صحنه را میشناسید: هر کلیپ بهتنهایی قشنگ است، اما کنار هم که بگذاریدشان، داستان نمیشوند.
راهحل پرامپت بلندتر نیست، روش تولید است. شخصیت را یک بار با تصویر طراحی کنید (یک «کاراکتر شیت» از چند زاویه)، همان تصویرها را در هر نما بهعنوان مرجع به ابزار ویدئو بدهید و لباس، وسیله، مکان و صدا را در یک شاتلیست ثابت نگه دارید. ابزارهایی مثل Google Flow (گوگل فلو) و Kling (کلینگ) با تصویر مرجع چهره را خیلی بهتر از متن خالی نگه میدارند، اما هیچکدام تضمین صددرصد نمیدهند؛ لغزش باقیمانده را با کلیپ کوتاهتر، اصلاح فریم و تدوین میگیرید.
در ادامه میخوانید چرا چهره عوض میشود، روشی هفتقدمی که از استودیوهای انیمیشن وام گرفته شده، امکانات هر ابزار ویدئوساز تا شهریور ۱۴۰۵، سه پرامپت آمادهٔ کپی و راه درمان خطاهای رایج.
چرا چهرهٔ شخصیت در ویدئوی هوش مصنوعی عوض میشود؟
مدل ویدئو بازیگری ندارد که هر روز سر صحنه بیاید؛ هر بار شخصیت را از نو میکشد. چهار دلیل اصلی لغزش چهره اینهاست:
- هر کلیپ یک قرعهٔ تازه است. مدلهای تصویر و ویدئو هر ساخت را از نقطهٔ شروعی تصادفی (نویز) آغاز میکنند و هرچه را پرامپت دقیق تعیین نکرده، هر بار جور دیگری پر میکنند. از کلیپ قبلی هم حافظهای ندارند، مگر اینکه تصویری از آن را مرجع بدهید.
- کلمه برای یک چهره کم است. «دختر نهسالهٔ مومشکی» با میلیونها صورت جور درمیآید. هویت چهره در شکل بینی، فاصلهٔ چشمها و خط فک است و یک عکس مرجع همهٔ اینها را یکجا منتقل میکند.
- کلیپ بلندتر، زاویهٔ تندتر و نور متفاوتتر یعنی لغزش بیشتر. وقتی شخصیت رو برمیگرداند یا از نور روز به نور نئون میرود، مدل باید بخشی از صورت را که در مرجع نبوده حدس بزند. در کلیپهای بلند و صحنههای ادامهدار هم خطاهای کوچک روی هم جمع میشوند؛ پژوهشگران به این پدیده drift (رانش) میگویند.
- دو شخصیت در یک قاب با هم رقابت میکنند. بارانی زرد سارا تن برادرش میرود یا دو صورت شبیه هم میشوند. پژوهش ConceptMaster دربارهٔ ویدئوهای چندشخصیتی همین درهمآمیختن ویژگیهای هویتی را چالشی اصلی میداند.
نتیجهٔ عملی: هرچه باید ثابت بماند، بهجای توصیف، نشانش بدهید؛ کلیپها را کوتاه نگه دارید و شخصیتها را جدا از هم مرجع کنید.
ساخت ویدئو با هوش مصنوعی با شخصیت ثابت: روش هفتقدمی
استودیوهای انیمیشن سالهاست پیش از ساخت صحنه، «مدلشیت» شخصیت و استوریبرد را آماده میکنند و همین منطق اینجا هم جواب میدهد. ترتیب قدمها مهم است: هرچه خطا را زودتر، یعنی در مرحلهٔ عکس، بگیرید، ارزانتر تمام میشود.
۱. شناسنامهٔ شخصیت را بنویسید
یک پاراگراف ثابت بنویسید که فقط ویژگیهای تغییرناپذیر را دارد: سن دقیق، شکل صورت، چشمها، مو، یک نشانهٔ خاص، یک تکه لباس امضایی و پالت سهرنگی. همین پاراگراف را کلمهبهکلمه در همهٔ پرامپتها کپی کنید؛ هر بازنویسی یعنی یک شخصیت تازه.
مثلاً بهجای «یک دختربچهٔ بامزه با بارانی» بنویسید: «سارا، نهساله، صورت گرد، ککومک روی بینی، موی مشکی صاف تا چانه با چتری، بارانی زرد لیمویی با دکمههای چوبی، چکمهٔ سرمهای؛ پالت: زرد، سرمهای، کرم». جملهٔ اول با هزار دختربچه جور درمیآید، دومی تقریباً فقط با سارا.
۲. کاراکتر شیت بسازید: یک چهره، چند زاویه
کاراکتر شیت (برگهٔ مرجع شخصیت) همان شخصیت را از روبهرو، سهرخ، نیمرخ و پشت، بهعلاوهٔ چند حالت چهره، روی زمینهٔ ساده و با نور یکنواخت نشان میدهد. انتخاب اول هوش یاب برای تصویر ChatGPT (چت جی پی تی) است؛ طبق اعلام OpenAI، نسخهٔ Images 2.5 (عرضه در ۱۷ شهریور ۱۴۰۵) سوژهٔ عکس مرجع را بهتر حفظ میکند و در ویرایشهای پشتسرهم تغییرهای قبلی را کمتر به هم میریزد. گزینهٔ قوی دیگر Nano Banana (نانو بنانا)، مدل تصویر Gemini (جمینای)، است که در اپ Gemini سهمیهٔ روزانهٔ رایگان دارد؛ به گفتهٔ گوگل نسخهٔ Pro آن تا ۱۴ تصویر را ترکیب میکند و شباهت تا ۵ نفر را نگه میدارد.
بعد از ساختن شیت، هر نما را جدا برش بزنید و ذخیره کنید؛ ابزارهای ویدئو تعداد محدودی مرجع میگیرند و راهنمای Kling توصیه میکند تصویر اصلی نمای روبهرو باشد. تا وقتی شیت ایراد دارد جلو نروید، چون هر ایرادش در همهٔ کلیپها تکثیر میشود. پرامپت شیت دوازدهزاویهای از یک چهره در کتابخانهٔ پرامپت هوش یاب هم نقطهٔ شروع خوبی است.
۳. برای هر نما یک فریم کلیدی بسازید
پیش از خرج کردن اعتبار ویدئو، هر نما را اول بهصورت عکس بسازید: شخصیت از روی شیت، در همان مکان، با قاب و ژستی که ابتدای کلیپ میخواهید. عکس ارزانتر است؛ در Google Flow ساخت تصویر با Nano Banana 2 Lite اعتبار کم نمیکند، اما هر کلیپ Veo 3.1 Fast بیست اعتبار از سهمیهٔ ۵۰تایی روزانه برمیدارد. چهرهای که در فریم کلیدی درست نیست، در ویدئو هم درست نمیشود.
۴. فریم را با مرجع به ویدئو تبدیل کنید
- فریم اول و آخر: فریم کلیدی تأییدشده را فریم شروع کلیپ کنید و اگر ابزار اجازه میدهد، فریم پایانی را هم بدهید تا مدل مجبور شود به همان چهره برگردد (در Flow با گزینهٔ Frames to Video).
- مرجع شخصیت: برای صحنهای که فریم آماده ندارد، تصویرهای شیت را مرجع کنید: Ingredients (مواد اولیه) در Flow، Elements در Kling یا Reference to Video در Vidu (ویدو). در پرامپت هم به مرجع اشاره کنید؛ Kling و PixVerse با علامت @ و Wan با نامهایی مثل Image 1.
کلیپها را چهار تا هشت ثانیهای بسازید و برای نمای طولانی زنجیره درست کنید: آخرین فریم خوبِ کلیپ قبلی را فریم اول کلیپ بعدی کنید. اگر چهره در همان فریم کمی لغزیده، از فریم کلیدی تأییدشده شروع کنید تا لغزش به کلیپ بعد ارث نرسد. گزینهٔ Extend در Flow هم صحنه را ادامه میدهد؛ طبق راهنمای گوگل، فعلاً با Veo 3.1 Lite.
۵. شاتلیست بنویسید و لباس، وسیله و مکان را قفل کنید
شاتلیست جدولی ساده است: شمارهٔ نما، نوع نما، کنش، مکان، لباس، وسیلهها، نور و ساعت روز، مدت. هرچه در آن ثابت است، در پرامپتها هم باید با همان کلمهها بیاید؛ «بارانی زرد لیمویی» در نمای دوم نباید «کاپشن زرد» شود. صفحهٔ رسمی PixVerse V6 هم همین را توصیه میکند: نشانههای هویتی را در توصیف هر نما عیناً تکرار کنید. ساعت روز را بیدلیل عوض نکنید و تغییر زاویه بین دو نمای پشتسرهم را ملایم نگه دارید.
۶. صدا را هم مثل چهره ثابت نگه دارید
برای هر شخصیت یک صدا انتخاب کنید و تا آخر پروژه عوضش نکنید. انتخاب اول هوش یاب برای گفتار Google AI Studio (گوگل ایآی استودیو) است: مدلهای TTS جمینای ۳۰ صدای آماده با اسم ثابت دارند (مثل Kore و Puck) و طبق مستندات گوگل فارسی را پشتیبانی میکنند. برای کیفیت بالاتر ElevenLabs هست که Eleven v3 آن فارسی را پوشش میدهد.
بعضی ابزارها صدا را به شخصیت میچسبانند؛ مثلاً در Kling 3.0 Omni، ۵ تا ۳۰ ثانیه صدای یک گوینده کافی است تا صدای شخصیت ثابت شود. اما گفتار بومی Kling فارسی ندارد، پس برای دیالوگ فارسی صدا را جدا بسازید و بعد لبها را هماهنگ کنید. ابزار Lip Sync کلینگ فایل صوتی آپلودی را میپذیرد، ولی طبق راهنمایش فقط روی شخصیت انسانی کار میکند. جزئیات را در راهنمای دوبلهٔ فارسی با هوش مصنوعی بخوانید.
۷. در تدوین، پیوستگی را کامل کنید
تدوین آخرین صافی لغزش است. کلیپها را در CapCut (کپکات) کنار هم بگذارید؛ برای ویدئوی پرگفتوگو Descript هم هست که تایملاین را با ویرایش متن رونوشت میبُرد، البته رونویسی خودکار فارسی ندارد. بعد:
- روی حرکت کات بزنید؛ وسط حرکت، چشم بیننده کمتر به جزئیات صورت دقت میکند.
- فقط بهترین تکهٔ هر کلیپ را نگه دارید؛ هرچه از فریم مرجع دورتر شوید، لغزش بیشتر است.
- یک اصلاح رنگ واحد روی همهٔ کلیپها بگذارید و هر کلیپ را به یک نمای مرجع نزدیک کنید؛ خیلی وقتها «بارانی نارنجی» فقط مشکل رنگ است.
- صدای محیط و موسیقی یکسان، نماهای جدا را به هم میدوزد.
نمیدانید برای داستان خودتان از کدام ابزار شروع کنید؟ در هوش یاب بنویسید: «یک ویدئوی داستانی کوتاه با یک شخصیت ثابت بساز» تا نقشهٔ راه قدمبهقدم را با ابزار و پرامپت آمادهٔ هر مرحله بگیرید.
کدام ابزار ویدئوساز شخصیت را بهتر ثابت نگه میدارد؟
تقریباً همهٔ ابزارهای جدی ساخت ویدئو با هوش مصنوعی حالا مرجع میگیرند؛ فرقشان در تعداد و نوع مرجع، طول کلیپ و قیمت است. هوش یاب برای ویدئو اول Google Flow و Google Vids (گوگل ویدز) را پیشنهاد میکند: Flow برای شاتهای سینمایی با Gemini Omni و Veo 3.1، و Vids برای ویدئوی کامل با تایملاین، اسلاید و صداگذاری.
| ابزار | امکان حفظ شخصیت | بیشترین طول کلیپ | پلن رایگان | قیمت از |
|---|---|---|---|---|
| Google Flow | Ingredients (تصویر مرجع)، فریم اول و آخر، Extend، ویرایش ویدئو با پرامپت | ۸ ثانیه با Veo، ۱۰ ثانیه با Gemini Omni | روزانه ۵۰ اعتبار | ۴٫۹۹ دلار (Google AI Plus) |
| Google Vids | تا ۷ تصویر مرجع، آواتار بهعنوان مرجع، ادامهدادن کلیپ | ۱۰ ثانیه | ماهانه ۶ کلیپ یا آواتار | ۱۹٫۹۹ دلار (AI Pro، ۵۰ کلیپ) |
| Kling 3.0 Omni | Elements از ۲ تا ۴ عکس یا ویدئوی کوتاه، تا ۷ مرجع، صدای ثابت برای شخصیت | ۱۵ ثانیه | اعتبار محدود، با واترمارک | ۶٫۹۹ دلار ماه اول، بعد ۱۰ دلار |
| Runway | References برای عکس (تا ۳ مرجع)، Act-Two برای انتقال بازی به شخصیت | ۱۰ ثانیه (Gen-4.5) | ۱۲۵ اعتبار یکباره | ۱۵ دلار (سالانه ۱۲) |
| Vidu Q3 | Reference to Video با ۱ تا ۷ تصویر | ۱۶ ثانیه | اعتبار محدود | حدود ۱۰ دلار |
| Hailuo (MiniMax H3) | تا ۱۲ مرجع: ۹ عکس، ۳ ویدئو، ۳ صدا | ۱۵ ثانیه | اعتبار آزمایشی یکباره | از ۹٫۹۹ دلار |
| Higgsfield | Soul ID (آموزش چهره با حدود ۲۰ عکس)، استوریبرد Popcorn | بسته به مدل | محدود | ۱۹ یورو (سالانه) |
| PixVerse V6 | Fusion با ۱ تا ۳ تصویر مرجع | ۱۵ ثانیه | روزی ۳۰ اعتبار، با واترمارک | ۱۰ دلار |
| Wan (3.0) | تا ۲۰ مرجع: عکس، ویدئو، صدا و سند | ۳۰ ثانیه | اعتبار روزانه با چکاین | ۱۰ دلار (سالانه ۵) |
| Luma Dream Machine | مرجع شخصیت در Ray3، قفل هویت در Modify، فریم اول و آخر | ۱۰ ثانیه | در صفحهٔ قیمت فعلی نیست | ۳۰ دلار (سالانه ۲۵) |
| Midjourney | تا ۴ مرجع در Edit Model (فقط عکس)؛ ویدئو فقط از روی عکس | ۵ ثانیه، با افزایش تا حدود ۲۱ ثانیه | ندارد | ۱۰ دلار |
| Dreamina (Seedance 2.5) | تا ۵۰ مرجع تصویر، ویدئو و صدا | ۳۰ ثانیه | اعتبار روزانه (Seedance 2.5 فقط با اشتراک) | منطقهای |
اگر اسم Sora را در این جدول نمیبینید، دلیلش ساده است: OpenAI اپ آن را آوریل ۲۰۲۶ (بهار ۱۴۰۵) بست و API آن هم ۲ مهر ۱۴۰۵ (۲۴ سپتامبر ۲۰۲۶) خاموش میشود؛ جزئیات در اطلاعیهٔ OpenAI دربارهٔ توقف Sora آمده است.
- تعداد مرجع همهچیز نیست. بیست یا پنجاه مرجع به کار صحنهٔ شلوغ میآید؛ برای یک قهرمان تنها، Kling خودش فقط ۲ تا ۴ عکس برای ساختن Element میخواهد.
- رتبهبندیها ثبات شخصیت را نمیسنجند. جدولهایی مثل Arena کیفیت کلی کلیپ را با رأی کاربران میسنجند، نه اینکه قهرمان شما در ده نما همان بماند؛ پیش از تکیه بر رتبهها، نمودار بنچمارک را درست بخوانید.
- فارسی و پرداخت. همهٔ این سرویسها خارجیاند: بیشترشان پرامپت فارسی را پشتیبانی نمیکنند و اشتراکشان کارت بینالمللی میخواهد. گزینههای دیگر را در ابزارهای ویدئوی هوش یاب ببینید.
پرامپتهای آماده برای کاراکتر شیت، هر نما و درمان لغزش
جاهای داخل کروشه را با شناسنامهٔ شخصیت پر کنید. ابزارهای عکس مثل ChatGPT و Nano Banana فارسی را میفهمند؛ برای ابزارهای ویدئو نسخهٔ انگلیسی مطمئنتر است.
پرامپت ۱: کاراکتر شیت
یک کاراکتر شیت (برگهٔ مرجع شخصیت) برای ساخت ویدئو بساز. شخصیت: [نام]، [سن دقیق]، صورت [گرد/بیضی/کشیده]، چشمهای [رنگ و حالت]، موی [رنگ، طول و مدل]، نشانهٔ خاص: [مثلاً ککومک روی بینی]. لباس ثابت: [تکهٔ امضایی، مثلاً بارانی زرد لیمویی با دکمههای چوبی] و [بقیهٔ لباس]. پالت رنگ: [سه رنگ]. سبک: [مثلاً انیمیشن سهبعدی نرم یا عکس سینمایی واقعگرا]. ردیف بالا: تمامقد از روبهرو، سهرخ، نیمرخ و پشت. ردیف پایین: چهار نمای نزدیک از چهره با حالتهای شاد، نگران، عصبانی و متعجب. زمینهٔ خاکستری روشن و ساده، نور یکنواخت استودیویی. همهٔ نماها دقیقاً یک نفرند، با نسبتها، مو و لباس یکسان. هیچ متن، برچسب یا واترمارکی نگذار.
Character reference sheet for animation and video. Character: [name], [exact age], [face shape], [eye colour and shape], [hair colour, length and style], distinctive mark: [e.g. freckles across the nose]. Fixed outfit: [signature item, e.g. lemon-yellow raincoat with wooden buttons], [rest of outfit]. Colour palette: [three colours]. Style: [e.g. soft 3D animation / photoreal cinematic]. Top row: full-body front view, three-quarter view, side profile, back view. Bottom row: four close-up expressions: happy, worried, angry, surprised. Plain light-grey background, even studio lighting. Every view shows the exact same person with identical proportions, hair and clothing. No text, no labels, no watermark.
اگر شیت یکدست درنیامد، بهجای ساختن از نو، همان تصویر را با یک جمله اصلاح کنید؛ مثلاً «در نمای نیمرخ، دکمهها را مثل نمای روبهرو چوبی کن».
پرامپت ۲: قالب هر نما
شخصیتِ تصویر ۱ را دقیقاً با همان چهره، مو، لباس و رنگها نگه دار. کنش: [در یک جمله، شخصیت چه میکند]. دوربین: [نما: کلوزآپ، مدیوم یا لانگشات]، [حرکت: ثابت، دالی آرام به جلو یا حرکت همراه]، [زاویه: همسطح چشم]. لنز: [مثلاً ۵۰ میلیمتری با عمق میدان کم]. نور: [منبع و سمت، مثلاً نور نرم پنجره از چپ، عصر]. حالوهوا: [مثلاً گرم و نوستالژیک]. صدا: [صدای محیط یا افکت]. ثابت بماند: شکل صورت، رنگ و مدل مو، [تکهٔ امضایی لباس]، [وسیلهٔ همراه]، سن و قد. هیچ متن یا زیرنویسی روی تصویر نیاید.
The character in image 1 keeps exactly the same face, hair, outfit and colours. Action: [one sentence]. Camera: [close-up / medium / wide shot], [static / slow dolly-in / tracking], [eye level]. Lens: [e.g. 50mm, shallow depth of field]. Light: [source and direction, e.g. soft window light from the left, late afternoon]. Mood: [e.g. warm, nostalgic]. Sound: [ambience or effects]. Keep unchanged: face shape, hair colour and style, [signature clothing item], [prop], age and height. No on-screen text or subtitles.
این قالب همان پنج جزئی را دارد که گوگل در راهنمای پرامپتنویسی Veo 3.1 (دوربین، سوژه، کنش، فضا و سبک) پیشنهاد میکند، بهعلاوهٔ بند «ثابت بماند». دیالوگ را فقط اگر ابزار زبانش را پشتیبانی میکند داخل گیومه بنویسید و «تصویر ۱» را با نامگذاری ابزارتان عوض کنید (مثلاً @ و نام Element در Kling).
پرامپت ۳: درمان چهرهای که لغزیده
این پرامپت برای ویرایش یک فریم در ChatGPT یا Nano Banana است؛ فریم مشکلدار را همراه نمای روبهروی شیت بدهید:
تصویر اول فریمی از ویدئوی من است و تصویر دوم مرجع شخصیت. فقط چهره و مو را در تصویر اول به مرجع برگردان: [شکل صورت، فاصلهٔ چشمها، رنگ و مدل مو، نشانهٔ خاص]. ژست، حالت چهره، لباس، نور، پسزمینه، زاویهٔ دوربین و قاببندی را دست نزن. سن را [نه سال] نگه دار. خروجی را در همان ابعاد تصویر اول بده.
بعد فریم اصلاحشده را فریم اول (یا آخر) کلیپ کنید و کلیپ را دوباره بسازید. نمونههای ویدئویی، مثل پرامپت جایگزینی شخصیت در ویدئوی مرجع برای Kling، در کتابخانهٔ پرامپت هوش یاب هست.
وقتی باز هم چیزی عوض شد: خطاهای رایج و درمانشان
حتی با همهٔ این قدمها، بعضی نماها خراب درمیآیند. قبل از خرج کردن اعتبار تازه، ببینید مشکل از کدام نوع است:
| مشکل | علت محتمل | درمان |
|---|---|---|
| دو شخصیت ویژگیهایشان را عوض کردهاند | مرجعها یا توصیفها در یک قاب درهم رفته | هر شخصیت را با مرجع و نام جدا بدهید و جایش را بگویید («سارا سمت چپ»)؛ اگر نشد، هر نفر را در نمای جدا بسازید |
| دست یا وسیله وسط کلیپ عوض میشود | وسیله در مرجع نبوده یا حرکت پیچیده است | وسیله را هم مرجع کنید، کنش را ساده و کلیپ را کوتاه کنید یا روی آن لحظه کات بزنید |
| رنگ لباس کمکم عوض میشود | نور صحنه یا اسم رنگ در پرامپتها فرق میکند | اسم رنگ را همهجا یکسان بنویسید؛ تهرنگ را در تدوین اصلاح کنید |
| شخصیت پیرتر یا جوانتر میشود | سن به عدد نیامده یا کلیپ بلند است | سن دقیق را در بند «ثابت بماند» بنویسید و از فریم کلیدی شروع کنید |
| چهره وقت چرخیدن سر میلغزد | آن زاویه در مرجع نبوده | نمای سهرخ و نیمرخ شیت را هم مرجع کنید یا فریم پایانی بدهید |
| سبک نماها با هم نمیخواند | نماها با ابزارها یا مدلهای مختلف ساخته شدهاند | هر سکانس را با یک مدل بسازید و همهٔ فریمهای کلیدی را از یک ابزار تصویر بگیرید |
کِی از نو بسازید و کِی ویرایش کنید؟ اگر ایراد در فریم اول است یا در کل کلیپ پخش شده، فریم کلیدی را درست کنید و کلیپ را از نو بسازید. اگر ایراد کوتاه و محلی است، ویرایش ارزانتر است: کات، اصلاح رنگ یا ویرایش ویدئو با پرامپت. در Flow، مدل Gemini Omni Flash 1.1 (تا ۱۰ ثانیه) ویدئو را با پرامپت ویرایش میکند و Hailuo هم آدم یا شیء را در ویدئو جایگزین یا حذف میکند. اگر همان ایراد سه بار پشتسرهم تکرار شد، احتمالاً مشکل از پرامپت یا مرجع است، نه از بدشانسی.
چهرهٔ آدم واقعی، برچسب هوش مصنوعی و حق انتشار
اگر شخصیت ثابت شما چهرهٔ آدمی واقعی است، پای حق دیگران وسط است:
- رضایت روشن بگیرید. از صاحب چهره (و برای کودک، از والدینش) اجازهٔ صریح و ترجیحاً کتبی بگیرید و بگویید ویدئو کجا منتشر میشود. بعضی سرویسها خودشان هم سختگیرند؛ مثلاً مستندات Gemini Omni بارگذاری و ویرایش تصویر بعضی افراد شناختهشده را مجاز نمیداند.
- برچسب هوش مصنوعی را جدی بگیرید. طبق راهنمای یوتیوب دربارهٔ اعلام محتوای ساختهشده با هوش مصنوعی، ویدئوی واقعنما را باید اعلام کنید اگر آدم واقعی را در حال کاری نشان دهد که نکرده، رویداد یا مکانی واقعی را دستکاری کند یا صحنهای واقعنما بسازد که رخ نداده؛ انیمیشن و محتوای آشکارا خیالی مشمول نیست، اما یوتیوب ممکن است خودش برچسب بزند. قواعد تیکتاک برای برچسب محتوای هوش مصنوعی هم تصویر، صدا و ویدئوی واقعنما را مشمول میداند و ساختن چنین محتوایی از چهرهٔ افراد عادی، یا نمایش چهرههای مشهور در حال تأیید یک محصول، را محدود کرده است.
- موسیقی و شرایط پلن. آهنگ روی ویدئو هم صاحب دارد، چه ساختهٔ آدم باشد چه هوش مصنوعی؛ بحثش را در مطلب آهنگی که با هوش مصنوعی ساختید مال کیست؟ بخوانید. پلن رایگان خیلی از ویدئوسازها هم واترمارک دارد یا استفادهٔ تجاری را مجاز نمیداند.
جمعبندی: شخصیت را یک بار بسازید، بارها بازیاش بدهید
ثبات شخصیت در ساخت ویدئو با هوش مصنوعی از پرامپت جادویی نمیآید، از روش میآید: شناسنامه و کاراکتر شیت را یک بار درست بسازید، هر نما را با فریم کلیدی و مرجع شروع کنید، کلیپها را کوتاه نگه دارید، صدا را ثابت کنید و باقیماندهٔ لغزش را در تدوین بپوشانید.
قدم بعدی: قصهٔ یکدقیقهایتان را در شش تا هشت نما بنویسید و در هوش یاب بپرسید «از کاراکتر شیت یک انیمیشن کوتاه کودکانه بساز» تا ابزار و پرامپت هر مرحله را بگیرید.
پرسشهای پرتکرار
آیا فقط با پرامپت متنی میشود شخصیت را در همهٔ صحنهها ثابت نگه داشت؟
تا حدی، نه کامل. توصیف دقیق و تکرار عین همان جملهها در هر پرامپت (سن به عدد، مو، لباس امضایی، پالت رنگ) لغزش را کم میکند، اما کلمه برای جزئیات صورت دقت کافی ندارد و هر ساخت از نقطهٔ تصادفی تازهای شروع میشود. برای داستان چندصحنهای، کاراکتر شیت تصویری و شروع هر کلیپ از یک فریم کلیدی تأییدشده عملاً لازم است.
ارزانترین راه ساخت ویدئوی داستانی با شخصیت ثابت چیست؟
تا شهریور ۱۴۰۵، Google Flow به همهٔ کاربران، حتی بدون اشتراک، روزانه ۵۰ اعتبار میدهد؛ مثلاً برای دو کلیپ Veo 3.1 Fast یا سه کلیپ دهثانیهای Gemini Omni در ۷۲۰p. شیت و فریمها را با سهمیهٔ رایگان ChatGPT یا Nano Banana بسازید و در CapCut تدوین کنید. فقط بدانید اعتبار روزانه جمع نمیشود و کاربر رایگان در ساعتهای شلوغ ممکن است نتواند ویدئو بسازد.
برای ساخت انیمیشن کودکانه با هوش مصنوعی کدام ابزار مناسبتر است؟
ثابت ماندن سبک از انتخاب ابزار مهمتر است: سبک (مثلاً «انیمیشن سهبعدی نرم») را جزو شناسنامهٔ شخصیت کنید و کل سکانس را با یک مدل بسازید. Google Flow انتخاب اول هوش یاب برای ویدئوست؛ Vidu روی انیمیشن دوبعدی و انیمه تمرکز دارد و تا ۷ تصویر مرجع میگیرد و Kling با Elements برای شخصیتهای تکرارشونده مناسب است. اگر قهرمان قصه حیوان است، ببینید ابزار لبخوانیتان شخصیت غیرانسانی را پشتیبانی میکند یا نه.
آیا میتوانم از عکس خودم یا دیگران بهعنوان شخصیت ویدئو استفاده کنم؟
از عکس خودتان بله، اگر قوانین ابزار اجازه بدهد؛ بعضی سرویسها برای چهرههای شناختهشده یا کودکان محدودیت دارند. برای عکس دیگران رضایت روشن و ترجیحاً کتبی بگیرید و بگویید ویدئو کجا منتشر میشود. اگر نتیجه واقعنماست و آدمی واقعی را در حال کاری نشان میدهد که نکرده، یوتیوب اعلامش را لازم میداند و تیکتاک ساختن چنین محتوایی از چهرهٔ افراد عادی را محدود کرده است.
دیالوگ فارسی را چطور با لبخوانی درست بسازم؟
بیشتر ویدئوسازها دیالوگ بومی فارسی نمیسازند؛ مثلاً گفتار بومی Kling فقط پنج زبان دارد. صدای هر شخصیت را جدا بسازید، مثلاً با TTS جمینای در Google AI Studio که فارسی را پشتیبانی میکند یا با ElevenLabs، و همیشه همان صدا را به همان شخصیت بدهید. بعد با ابزار لبخوانی، مثل Lip Sync کلینگ که فایل صوتی آپلودی را میپذیرد، لبها را هماهنگ کنید و نماهای نزدیک را با دقت ببینید.
هر کلیپ ویدئوی هوش مصنوعی حداکثر چند ثانیه است؟
تا شهریور ۱۴۰۵ بیشتر ابزارها کلیپ ۵ تا ۱۵ ثانیهای میسازند: ۸ ثانیه در Veo 3.1، ۱۰ ثانیه در Gemini Omni و ۱۵ ثانیه در Kling 3.0؛ Wan و Seedance در نسخههای تازه تا ۳۰ ثانیه هم میروند. برای داستانی با شخصیت ثابت، کلیپ کوتاهتر امنتر است، چون لغزش با طول کلیپ بیشتر میشود. ویدئوی چنددقیقهای را از کنار هم گذاشتن نماهای کوتاه در تدوین بسازید.
منابع
- راهنمای Google Flow: مدلها و امکانات هرکدام
- راهنمای Google Flow: اعتبار روزانه و هزینهٔ هر ساخت
- راهنمای رسمی Kling VIDEO 3.0 Omni
- راهنمای پرامپتنویسی مدل ویدئوی گوگل (Veo 3.1)
- اطلاعیهٔ OpenAI دربارهٔ توقف Sora
- راهنمای یوتیوب دربارهٔ اعلام محتوای ساختهشده با هوش مصنوعی
- قواعد تیکتاک برای برچسب محتوای هوش مصنوعی
- مقالهٔ ConceptMaster دربارهٔ درهمآمیختن هویتها در ویدئوی چندشخصیتی