عکسهای جزوه در گالری گوشی صف کشیدهاند، یا PDF چهارصدصفحهای دارید که از روی عکس جزوه ساخته شده، یا کتاب هزارصفحهای اسکنشدهای که باید Word شود؛ نه خلاصهاش را میخواهید و نه نسخهٔ «بهترشدهاش»، همان متن را کلمهبهکلمه. تبدیل عکس به متن فارسی با هوش مصنوعی شدنی است، اما اگر سطری جا بیفتد یا چتبات جملهای را «روانتر» کند، وقتی که صرفهجویی کردهاید صرف پیدا کردن همان سطر میشود. اینجا میخوانید هر کار را با کدام ابزار انجام دهید و با یک پرامپت و یک وارسی ساده، از کامل بودن متن مطمئن شوید.
جواب کوتاه: برای یک عکس، Google Lens (گوگل لنز) یا تبدیل رایگان ایبو کافی است. برای چند صفحهٔ تایپی، باز کردن فایل با Google Docs در Google Drive رایگان است و فارسی را در فهرست زبانهایش دارد. برای PDF اسکنشدهٔ طولانی، ایبو صفحهای ۲۲۰ تا ۲۸۰ تومان فایل Word میدهد و مسیر رایگانش Claude (کلود) یا Gemini (جمنای) با پرامپت رونویسی و حدود ده صفحه در هر پیام است. سند محرمانه را با مدل آفلاین روی کامپیوتر خودتان تبدیل کنید.
تبدیل عکس به متن فارسی: برای هر کار کدام ابزار؟
جدول بر پایهٔ صفحههای رسمی ابزارها در ۱۷ مهر ۱۴۰۵ است.
| کار | مسیر | رایگان؟ | نکتهٔ فارسی | خروجی |
|---|---|---|---|---|
| یک عکس، چند خط | Google Lens یا تبدیل عکس به متن ایبو | بله؛ ایبو هر دقیقه یک صفحه | برای متن چاپی؛ نتیجه را بخوانید | متن برای کپی |
| چند صفحهٔ تایپی، با کامپیوتر | Google Drive، باز کردن با Google Docs | بله | فارسی در فهرست رسمی؛ جدول و ستون معمولاً میریزد | Google Doc، قابل دانلود به Word |
| چند صفحه، خطبهخط و دقیق | Claude، ChatGPT یا Gemini با پرامپت رونویسی | با سقف؛ ChatGPT رایگان روزی ۳ فایل | فقط با پرامپت سختگیر | متن برای Word |
| PDF اسکنشدهٔ ۴۰۰ تا ۱۰۰۰ صفحه | ایبو؛ یا Gemini و Claude دستهبهدسته | ایبو یک صفحهٔ آزمایشی، بعد پولی | ایبو حفظ جدول و ستون را وعده میدهد | Word |
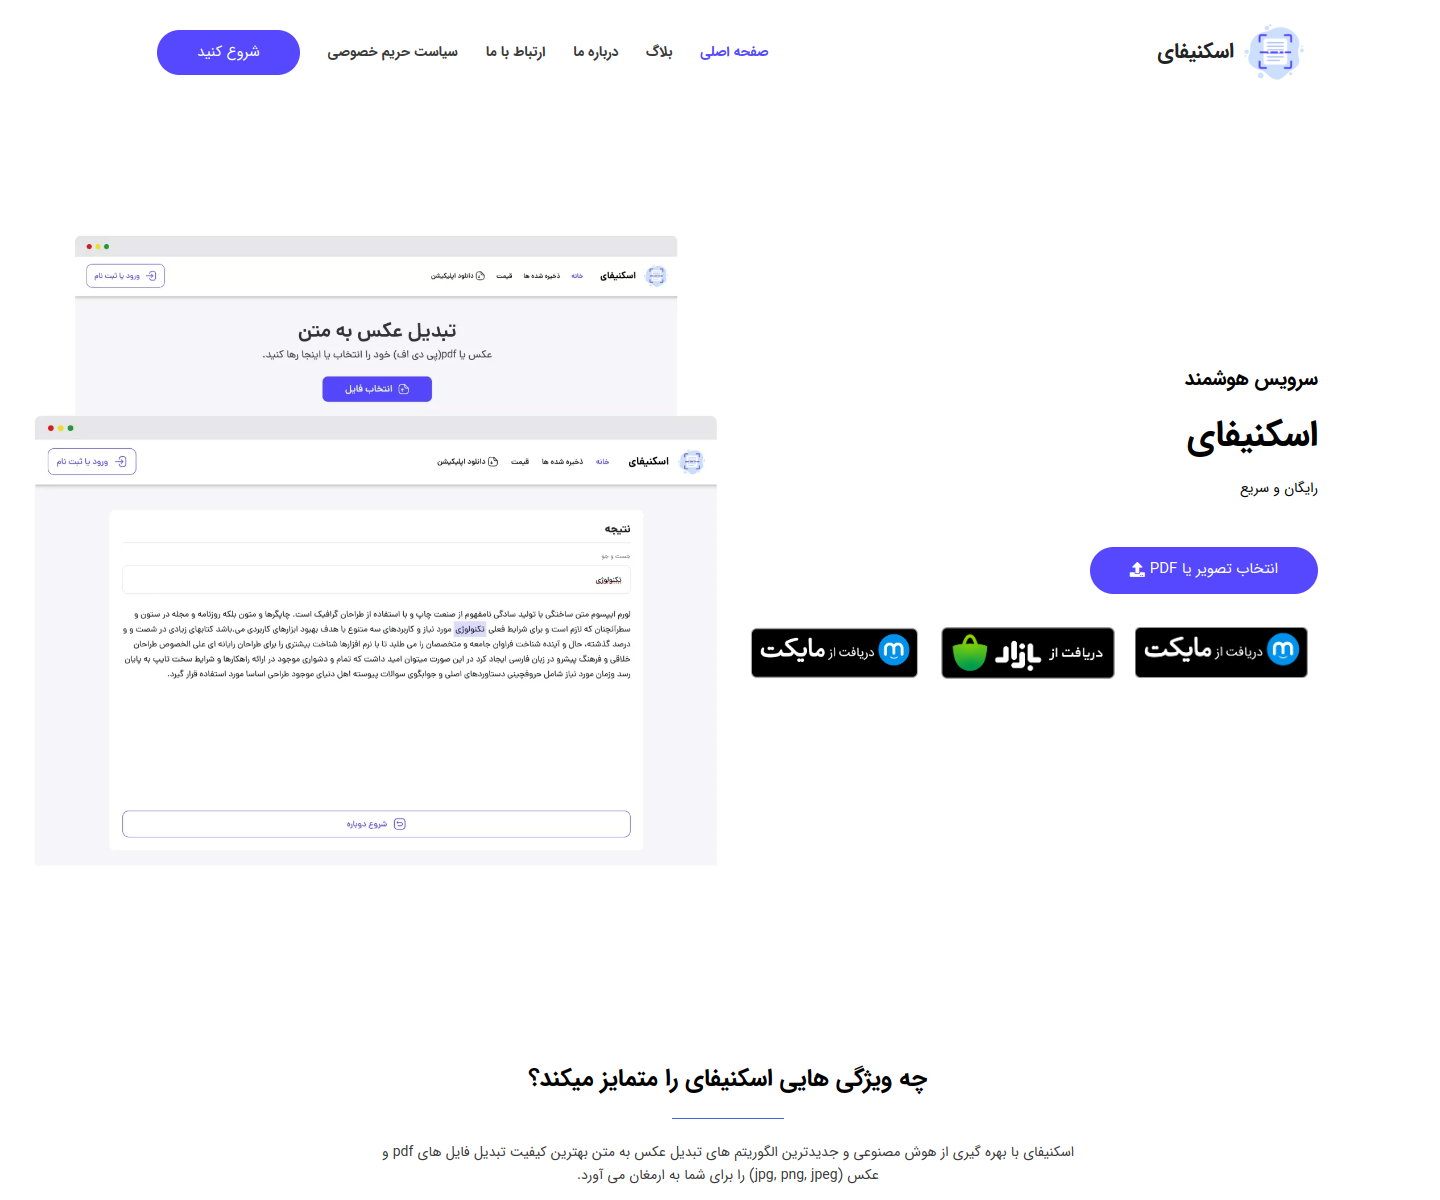
| PDF تا ۵۰ صفحه | اسکنیفای (Scanify) | شروع رایگان | سرویس فارسیمحور | Word |
| دستخط | Claude، Gemini یا ChatGPT؛ ایبو | بسته به ابزار | تابع خوانایی خط | متن |
| عربی اعرابدار | چتبات با دستور «اعراب عیناً»؛ آیهها از Tanzil | بله | اعراب را خطبهخط چک کنید | متن |
| قرارداد، مدرک هویتی، پروندهٔ پزشکی | LM Studio با Qwen3-VL روی کامپیوتر خودتان | بله | فارسی جزو زبانهای OCR مدل | متن، بیآنکه فایل بیرون برود |
چهار سقف که پیش از شروع باید بدانید:
- Google Drive: طبق راهنمای گوگل، فقط از drive.google.com روی کامپیوتر؛ فایل حداکثر ۲ مگابایت، ارتفاع حروف دستکم ۱۰ پیکسل و صفحه سرراست. شکستن خطها و قالب حروف احتمالاً میماند، اما فهرست، جدول، ستون و پانویس معمولاً تشخیص داده نمیشود.
- ChatGPT (چتجیپیتی): طبق راهنمای OpenAI، جز در پلن Enterprise از PDF فقط متن دیجیتال را میخواند، نه تصویر صفحهها. برای اسکن، عکس صفحهها را بفرستید (هر عکس تا ۲۰ مگابایت)؛ کاربر رایگان روزی ۳ فایل.
- Claude: تا ۲۰ فایل در هر گفتگو. تصویر صفحهها را فقط در PDF تا ۱۰۰ صفحه میبیند و بالاتر از آن (تا ۱۰۰۰ صفحه) فقط متن میخواند، یعنی از اسکن چیزی نمیماند.
- Gemini: در هر پیام تا ۱۰ فایل، هر کدام تا ۱۰۰ مگابایت.
همین حالا: سه صفحهٔ سخت جدا کنید: یکی با جدول، یکی کمرنگ و یکی با پانویس یا عبارت عربی. ابزارها را با همین سه صفحه میسنجید.
چرا چتبات متن را خلاصه میکند یا خط جا میاندازد؟
سه علت دارد و هر سه قابل پیشگیری است:
- تصویر را نمیبیند. PDF اسکنشده در ChatGPT (جز Enterprise) و PDF بالای ۱۰۰ صفحه در Claude متنی برای خواندن ندارند. جواب کلی گرفتید؟ اول همین را چک کنید.
- سقف طول پاسخ. هر پاسخ سقفی دارد؛ پنجاه صفحه در یک پیام یا وسط کار قطع میشود یا کوتاهشده برمیگردد.
- عادت ویراستاری. چتبات برای «کمک کردن» ساخته شده و اگر صریح نگویید، ممکن است غلط املایی را درست کند، جمله را صاف کند یا کلمهٔ ناخوانا را از روی معنی حدس بزند.
این پرامپت هر سه را میبندد. آن را همراه عکسها یا PDF در Claude، ChatGPT یا Gemini بچسبانید:
تو رونویس دقیق هستی، نه ویراستار. متن تصویرهای پیوست را کلمهبهکلمه تایپ کن.
۱. هیچ چیز را خلاصه، بازنویسی، اصلاح یا جابهجا نکن؛ غلط املایی و تکرار را هم همانطور که هست بنویس.
۲. هر خط تصویر یک خط خروجی باشد؛ تیترها، شمارهگذاریها، پاراگرافها و پانویسها سر جایشان بمانند.
۳. کلمهای را که نمیتوانی بخوانی حدس نزن؛ به جایش بنویس [ناخوانا]. اگر حدسی داری، بنویس [ناخوانا: حدس].
۴. عبارت عربی را با همان اعرابی که در تصویر هست بنویس؛ اعرابی اضافه یا کم نکن.
۵. کلمهٔ انگلیسی، عدد و فرمول را عیناً بنویس؛ رقم فارسی فارسی بماند و رقم لاتین لاتین.
۶. اول هر صفحه بنویس [صفحهٔ N] با شمارهٔ صفحه در فایل.
۷. جدول را با | جدا کن و جای تصویر یا نمودار بنویس [تصویر].
۸. هیچ مقدمه و توضیحی ننویس. اگر به سقف طول پاسخ رسیدی، همانجا بنویس [ادامه دارد] و بایست تا «ادامه» را بفرستم.
وارسی کامل بودن متن در پنج دقیقه
- تعداد نشانههای [صفحهٔ N] را با تعداد صفحههایی که فرستادهاید مقایسه کنید.
- از هر ده صفحه، خطهای یک صفحه را خودتان بشمارید و با خروجی تطبیق دهید. سطر اول و آخر، پانویس و حاشیه را جدا نگاه کنید.
- در خروجی دنبال «خلاصه»، «به طور کلی»، «و غیره»، سهنقطه و [ادامه دارد] بگردید.
- همه را در Word بچسبانید و با Find and Replace حرفها و رقمهای عربی را فارسی کنید: یای دونقطهدار عربی را «ی»، کاف عربی را «ک» و رقمهای عربی «٤٥٦» را «۴۵۶». سادهترین راه این است که خود حرف را از متن کپی کنید و در کادر Find بگذارید؛ وگرنه جستجوی «کتاب» نسخهای را که با کاف عربی آمده پیدا نمیکند.
همین حالا: پرامپت را با سه صفحهٔ آزمون در دو چتبات امتحان کنید و در ده خط از هر کدام، خطاها را بشمارید.
تبدیل PDF اسکنشده به Word فارسی: از جزوهٔ ۴۰۰ صفحهای تا کتاب ۱۰۰۰ صفحهای
هیچ ابزاری را یکباره روی هزار صفحه رها نکنید: دستهدسته بفرستید، شمارهٔ صفحه را نگه دارید و آخر کار سرهم کنید.
مسیر سریع و پولی: ایبو
- ایبو سرویسی ایرانی با پرداخت ریالی است. فایل را در eboo.ir بارگذاری کنید و یک صفحه را رایگان آزمایش کنید، ترجیحاً یکی از صفحههای سخت.
- در «انتخاب صفحات خاص» بازه بدهید، مثلاً ۱ تا ۱۰۰. شمارهها را طبق شمارهٔ صفحه در برنامهٔ PDFخوان بنویسید، نه شمارهای که روی کاغذ چاپ شده.
- هزینه طبق جدول تعرفه در مهر ۱۴۰۵: صفحهای ۲۸۰ تومان تا ۱۰۰ صفحه، ۲۵۰ تومان از ۱۰۱ تا ۲۰۰ و ۲۲۰ تومان از ۲۰۱ صفحه به بالا. بستهٔ ۱۵۰۰ صفحهای بیتاریخ انقضا ۱۹۵ هزار تومان است و برای کتاب هزارصفحهای بهصرفهتر.
- Word را بگیرید و وارسی را روی هر صد صفحه انجام دهید.
ایبو میگوید جدول، ستون و تصویر در Word حفظ میشود. برای صفحههایی که هیچ OCR از پسشان برنمیآید، سفارش تایپ انسانی فارسی، عربی و انگلیسی هم دارد.
مسیر رایگان و کندتر: Claude یا Gemini، حدود ده صفحه در هر پیام
- PDF را به فایلهای حداکثر ۱۰۰ صفحهای ببرید تا Claude تصویر صفحهها را ببیند و فایل زیر سقف ۱۰۰ مگابایتی Gemini بماند: PDF را در کروم باز کنید، Ctrl+P بزنید، مقصد را Save as PDF بگذارید و در Pages بازه بدهید، مثلاً 1-100.
- فایل اول را با پرامپت رونویسی بفرستید و یک خط اضافه کنید: «فقط صفحههای ۱ تا ۱۰ این PDF».
- در همان گفتگو بنویسید «ادامه: صفحههای ۱۱ تا ۲۰» و همینطور تا آخر فایل.
- هر پاسخ را بلافاصله در یک فایل Word بچسبانید و هر ده صفحه وارسی را انجام دهید.
حساب واقعبینانه: هزار صفحه یعنی حدود صد پیام، و با سهمیهٔ پلن رایگان احتمالاً در چند نوبت و چند روز تمام میشود. در ChatGPT بهجای PDF، عکس صفحهها را بفرستید.
نمیدانید از کدام مسیر شروع کنید؟ کارتان را در جستجوی هوش یاب بنویسید تا ابزارها و نقشهٔ قدمبهقدم با پرامپت آماده بگیرید.
اسکن بد را پیش از OCR درست کنید
اسکنیفای در صفحهٔ بارگذاریاش اینها را تصویر نامناسب میداند: پسزمینهٔ تیره یا رنگی، سایه روی متن، حاشیهٔ اضافه، انحنای کتاب و عکس بیکیفیت از خط نسخ یا نستعلیق. گوگل صفحهٔ سرراست و واضح میخواهد و راهنمای Claude عکس دستکم ۱۰۰۰ در ۱۰۰۰ پیکسل را پیشنهاد میکند. صفحههای خراب را از نو بگیرید:
- در اپ Google Drive اندروید، دکمهٔ دوربین پایین سمت راست را بزنید؛ کادر آبی محل برش است.
- با Crop & Rotate صفحه را صاف کنید، با Filter آن را خاکستری کنید و با Clean لک و جای انگشت را بردارید.
- خروجی را PDF ذخیره کنید و جای صفحهٔ خراب بگذارید.
سرهم کردن: یک فایل Word که بشود در آن گشت
- نشانههای [صفحهٔ N] را نگه دارید؛ با Ctrl+F و نوشتن «صفحهٔ ۲۳۵» به همان صفحهٔ کتاب اصلی میرسید.
- عنوان فصلها را با سبک Heading قالببندی کنید تا فهرست فصلها کنار صفحه بیاید.
- اگر کلمهٔ انگلیسی یا پرانتز وسط خط جابهجا شد، مشکل از متن نیست؛ پاراگراف را راستبهچپ کنید.
- PDF قابل جستجو میخواهید؟ همین Word را PDF ذخیره کنید؛ متنش قابل جستجوست، هرچند ظاهر اسکن را ندارد.
همین حالا: ده صفحهٔ اول را از هر دو مسیر بگیرید و خطاها را مقایسه کنید؛ بعد بقیه را با برنده ادامه دهید.
تبدیل دستخط فارسی به تایپ: کجا کار میکند و کجا نه
جزوهٔ تکستونی با خط مرتب، نور یکنواخت و یک صفحه در هر عکس بهترین ورودی است. Claude، ChatGPT و Gemini عکس میپذیرند و Gemini طبق صفحهٔ حریم خصوصیاش متن داخل عکس را با فناوری Google Lens میخواند. ایبو تبدیل دستخط فارسی و انگلیسی را رایگان معرفی کرده. اسکنیفای در معرفیاش میگوید دستخط را هم میخواند، اما در صفحهٔ بارگذاری «متون دستنویس» را جزو تصویرهای نامناسب آورده است.
محدودیت واقعی: در صفحههای رسمی این ابزارها عددی برای دقت دستخط فارسی پیدا نشد. کوتهنوشت، فلش، یادداشت حاشیه، کلمهٔ خطخورده و فرمول دردسرسازند و خطر اصلی کلمهٔ حدسی است که با جمله جور درمیآید و به چشم نمیآید.
دو خط به پرامپت رونویسی اضافه کنید:
این صفحه جزوهٔ دستنویس درس [نام درس] است و اصطلاحهایی مثل [چند اصطلاح] در آن آمده. هر کلمهای را که از روی معنی جمله حدس زدی، داخل [؟] بگذار و کوتهنوشتها را باز نکن.
همین حالا: از یک صفحهٔ جزوه عکس صاف بگیرید، به دو ابزار بدهید و فقط کلمههای [؟] و [ناخوانا] را با کاغذ مقابله کنید.
سند محرمانه دارید؟ OCR فارسی آفلاین روی کامپیوتر خودتان
قرارداد، کارت شناسایی و پروندهٔ پزشکی را با احتیاط بارگذاری کنید. گوگل میگوید بخشی از گفتگوهای Gemini را بازبین انسانی میخواند و توصیه میکند اطلاعات محرمانه وارد نکنید؛ با خاموش کردن Keep Activity، گفتگوهای بعدی برای بهبود سرویس بازبینی نمیشوند. Anthropic، سازندهٔ Claude، گفتگوها را، جز مواردی که برای بررسی ایمنی علامت میخورند، فقط با اجازهٔ شما برای بهبود مدل به کار میبرد و گفتگوی Incognito را نه. در ChatGPT هم این کار به تنظیمات دادهتان بستگی دارد. اسکنیفای میگوید درخواستها روی سرورهایش ذخیره میشود و مدت نگهداری را نمیگوید.
راه امنتر: فایل از کامپیوترتان بیرون نرود.
- LM Studio (الام استودیو) را از سایت رسمیاش نصب کنید؛ برای استفادهٔ شخصی و کاری رایگان است و روی ویندوز ۱۶ گیگابایت رم (حافظهٔ موقت کامپیوتر) پیشنهاد میشود.
- در بخش Discover مدل Qwen3-VL (کوئن ۳ ویال) نسخهٔ 8B را بگیرید که حدود ۶ گیگابایت است. فارسی جزو زبانهای OCR آن است و در آزمون داخلی تیم Qwen، دقت خواندن متن فارسی حدود ۸۸ درصد آمده؛ پس منتظر خطا باشید.
- عکس صفحه را به پنجرهٔ چت بکشید و پرامپت رونویسی را بچسبانید. بعد از دانلود اول، اینترنت لازم نیست.
جایگزینها: Qwen3.5 نسخهٔ 9B فارسی را در فهرست رسمی زبانهایش دارد و عکس هم میفهمد. مدل سبک GLM-OCR را برای فارسی کنار بگذارید؛ فارسی جزو هشت زبان رسمیاش نیست. موتور آفلاین اپ اندروید اسکنیفای را با حالت هواپیما امتحان کنید؛ سازنده نگفته فارسی را بیاینترنت با همان دقت میخواند. سختافزار لازم را در بخش هوش مصنوعی آفلاین و راهنمای هوش مصنوعی آفلاین روی لپتاپ ببینید.
همین حالا: اگر فقط متن قرارداد را لازم دارید، پیش از عکس گرفتن شمارهٔ ملی، شمارهٔ حساب و امضا را با کاغذ بپوشانید.
متن عربی اعرابدار: اعراب را چطور سالم نگه داریم؟
فتحه، تشدید و تنوین نشانههای کوچکیاند و در OCR زود گم میشوند. چتبات عربیدان خطر دیگری هم دارد: ممکن است از حافظه اعراب بگذارد، نه از روی تصویر. Google Drive عربی را میشناسد، اما دربارهٔ حفظ اعراب چیزی نمیگوید.
- بند ۴ پرامپت را نگه دارید و اضافه کنید: «اگر اعراب کلمهای را مطمئن نیستی، آن را بیاعراب بنویس و [؟] بگذار».
- در هر صفحه پنج خط را با تصویر بزرگشده مقابله کنید؛ تشدید، تنوین و حرکت آخر کلمهها را جدا ببینید.
- آیهٔ قرآن را OCR نکنید؛ از Tanzil بردارید که متن یونیکد قرآن را با دقت بالا منتشر میکند و با اعراب یا بیاعراب میدهد. حدیث را هم از منبع معرب نقل کنید؛ روشش در راهنمای پژوهش حدیث با هوش مصنوعی آمده است.
- اعرابگذاری متن بیاعراب از چتبات برمیآید، اما اعراب تفسیر دستوری و معنایی است؛ خروجی را پیشنویس بدانید و با نسخهٔ معرب یا استاد بسنجید.
همین حالا: یک صفحهٔ عربی را رونویسی کنید و فقط تعداد تشدیدها را در تصویر و خروجی بشمارید؛ اگر یکی نبود، به بقیهٔ اعراب هم اعتماد نکنید.
جمعبندی: دقت از دستههای کوچک میآید
ابزار را بر اساس کار انتخاب کنید: Lens و ایبو برای یک عکس، Google Docs برای چند صفحهٔ تایپی، ایبو یا Claude و Gemini برای PDF طولانی، و مدل آفلاین برای سند محرمانه. هر کدام را برداشتید، پرامپت رونویسی بدهید، کمکم بفرستید و صفحه و خط را بشمارید. برای پرسشوپاسخ و پادکست از جزوهٔ تایپشده با Gemini Notebook، راهنمای PDF درسی تا پادکست و برای صدای کلاس تبدیل صدای کلاس فارسی به متن را ببینید.
قدم بعد: کارتان را در جستجوی هوش یاب بنویسید تا مسیر مناسب را با پرامپت آماده بگیرید.
پرسشهای پرتکرار
بهترین روش رایگان تبدیل عکس به متن فارسی چیست؟
برای استخراج متن از عکسی با چند خط، Google Lens در اپ Google یا تبدیل عکس به متن ایبو که هر دقیقه یک صفحه را رایگان تبدیل میکند. برای چند صفحهٔ تایپی روی کامپیوتر، فایل تا ۲ مگابایت را در Google Drive با Google Docs باز کنید؛ فارسی در فهرست رسمی زبانهایش هست. اگر ترتیب خطها مهم است، Claude یا Gemini را با پرامپت رونویسی بیازمایید.
چطور PDF اسکنشده را بدون بههمریختگی به Word فارسی تبدیل کنم؟
اول یک صفحهٔ آزمایشی بگیرید. ایبو یک صفحه را رایگان تبدیل میکند، بعد صفحهای ۲۲۰ تا ۲۸۰ تومان میگیرد، بازهٔ صفحه را میپذیرد و میگوید جدول و ستون را حفظ میکند. مسیر رایگان، فایلهای تا ۱۰۰ صفحه و حدود ده صفحه در هر پیام به Claude یا Gemini است. در هر دو، حرفها و رقمهای عربی را در Word با Find and Replace فارسی کنید.
هوش مصنوعی دستخط فارسی را درست میخواند؟
خط مرتب و تکستونی شانس بیشتری دارد، اما هیچکدام از ابزارهای این مطلب عدد رسمی برای دقت دستخط فارسی منتشر نکردهاند. خطر اصلی کلمهای است که از روی معنی حدس زده شده و درست به نظر میرسد. در پرامپت بخواهید حدسها را داخل [؟] بگذارد و فقط همانها را با کاغذ مقابله کنید.
چرا ChatGPT متن PDF اسکنشده را نمیخواند؟
طبق راهنمای OpenAI، در همهٔ پلنها جز Enterprise، ChatGPT از PDF فقط متن دیجیتال را استخراج میکند و تصویرهای داخل فایل را نمیخواند، و PDF اسکنشده متن دیجیتال ندارد. راهش فرستادن عکس صفحههاست، هر عکس تا ۲۰ مگابایت؛ کاربر رایگان روزی ۳ فایل میفرستد. برای خود PDF، Claude (تا ۱۰۰ صفحه) یا Gemini را امتحان کنید.
در آیفون چطور عکس را به متن فارسی تبدیل کنم؟
Google Lens داخل اپ Google در اپاستور هست و متن عکس را برای کپی انتخاب میکند. ایبو نسخهٔ وباپ آیفون دارد و صفحهٔ تبدیل عکس به متنش در مرورگر گوشی هم کار میکند. اپهای Claude، ChatGPT و Gemini هم عکس میگیرند و با پرامپت رونویسی میتوانید متن را خطبهخط بخواهید و در Word بچسبانید.
منابع
- راهنمای Google Drive: تبدیل PDF و عکس به متن و فهرست زبانها
- راهنمای OpenAI: بارگذاری فایل در ChatGPT و سقفهایش
- راهنمای Claude: بارگذاری فایل و پردازش PDF
- راهنمای Gemini: سقف بارگذاری فایل
- مرکز حریم خصوصی Gemini
- ایبو: تبدیل عکس و PDF به Word و تعرفهها
- اسکنیفای: صفحهٔ تبدیل و راهنمای تصویر مناسب
- Tanzil: متن یونیکد قرآن