امبدینگ جما ۲ (آفلاین)
EmbeddingGemma 2 (offline)مدل بردارساز (embedding) باز و چندرسانهای گوگل دیپمایند (۶ اکتبر ۲۰۲۶): متن، کد، تصویر، صدا و ویدئو را در یک فضای برداری مشترک میگذارد تا روی گوشی یا لپتاپ و بدون اینترنت، در اسناد، عکسها و یادداشتهای صوتی بر اساس معنی جستوجو کنید؛ از ۳۷۸ مگابایت، با مجوز Apache 2.0.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- Apache-2.0 — استفادهٔ تجاری آزاد
- فارسی: نامعلوم
- API
فقط دانلود اول اینترنت میخواهد؛ بردارسازی و جستوجو کاملاً روی دستگاه خودتان انجام میشود.
استفادهٔ تجاری، تغییر و بازتوزیع آزاد است؛ فقط متن مجوز و اعلانها را همراه نسخهای که پخش میکنید نگه دارید.
نسخهها و سختافزار لازم
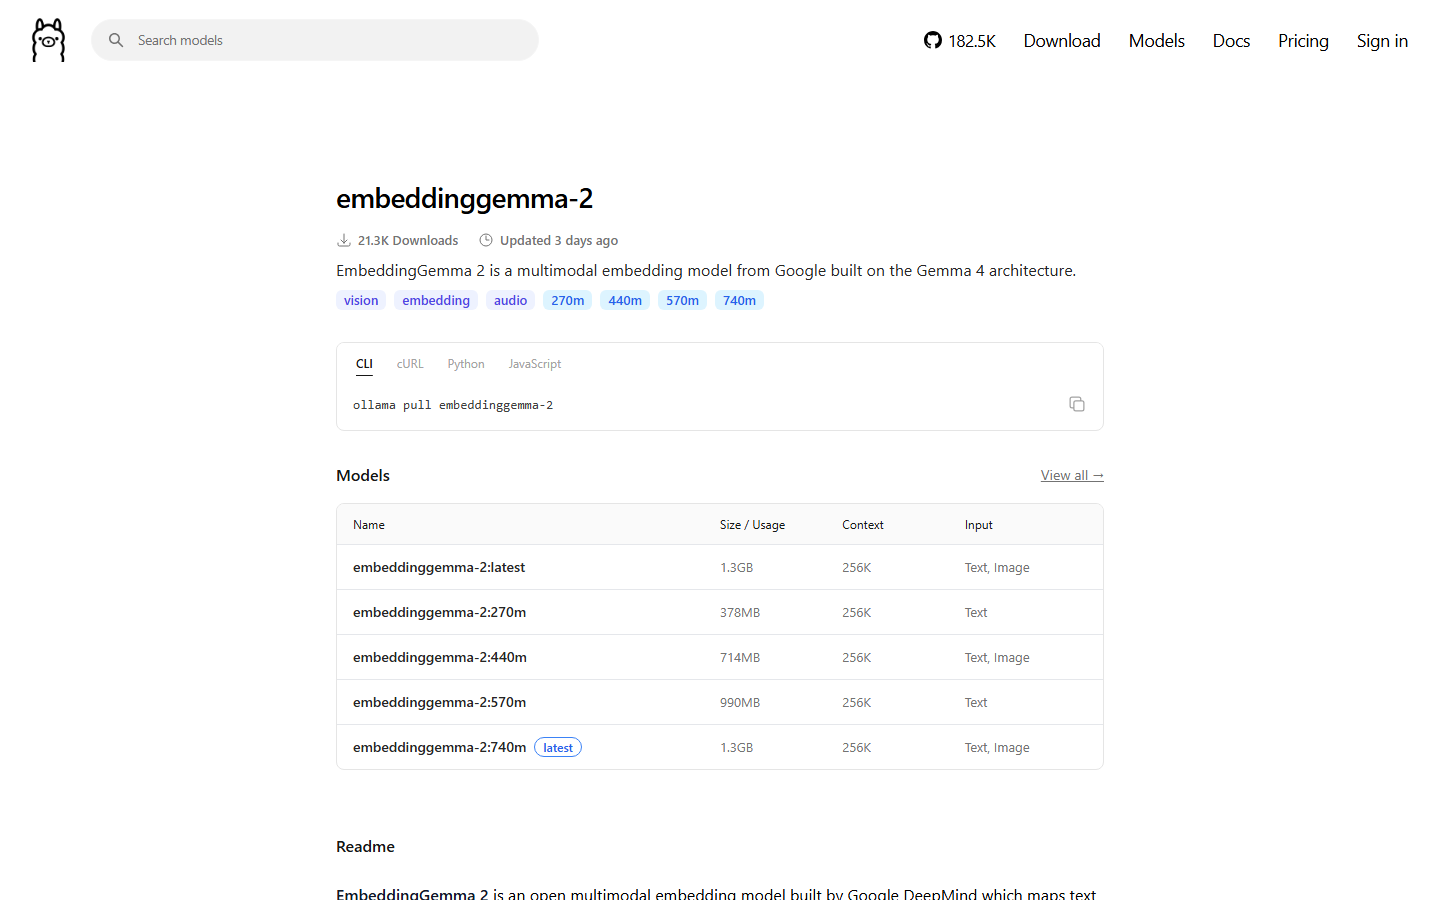
- 270m (فقط متن)۲۷۰Mطول متن ۸ هزار توکن
- حجم دانلود:
- ۰٫۴ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۱ گیگ یا رم ۳ گیگ
ollama run embeddinggemma-2:270m۱۳۰ میلیون پارامتر ستون اصلی و ۱۴۰ میلیون بردارساز؛ برای جستوجوی اسناد متنی و کد. روی گوشی بعد از فشردهسازی حدود ۱۹۱ مگابایت حافظه.
- 440m (متن و تصویر)۴۴۰Mطول متن ۸ هزار توکن
- حجم دانلود:
- ۰٫۷ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۱ گیگ یا رم ۳ گیگ
ollama run embeddinggemma-2:440mبخش بینایی (۱۷۰ میلیون پارامتر) اضافه میشود؛ برای جستوجوی عکس و اسناد تصویری با جملهٔ معمولی.
- 570m (متن و صدا)۵۷۰Mطول متن ۸ هزار توکن
- حجم دانلود:
- ۱ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۲ گیگ یا رم ۴ گیگ
ollama run embeddinggemma-2:570mبخش صدا (۳۰۰ میلیون پارامتر) اضافه میشود؛ برای جستوجوی یادداشتهای صوتی.
- 740m (کامل)۷۴۰Mطول متن ۸ هزار توکن
- حجم دانلود:
- ۱٫۳ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۲ گیگ یا رم ۴ گیگ
ollama run embeddinggemma-2همهٔ بخشها: متن، کد، تصویر، صدا و ویدئو؛ برچسب پیشفرض (latest) در Ollama. روی گوشی حدود ۵۶۷ مگابایت حافظه. نسخههای BF16 و MLX (mxfp8 و nvfp4) هم هست.
نصب و اجرا
- ۱
Ollama را نصب یا بهروز کنیدلینوکس
curl -fsSL https://ollama.com/install.sh | shدر ویندوز و مک برنامهٔ نصب را از ollama.com/download بگیرید. حداقل نسخهٔ Ollama برای این مدل اعلام نشده؛ آخرین نسخه را بگیرید (۰٫۴۰٫۲ در ۸ اکتبر ۲۰۲۶).
- ۲
مدل را بگیرید
ollama pull embeddinggemma-2:270m۳۷۸ مگابایت، فقط متن. برای عکس embeddinggemma-2:440m، برای صدا :570m و برای همهٔ ورودیها embeddinggemma-2 (نسخهٔ کامل، ۱٫۳ گیگابایت).
- ۳
آزمایش کنید که بردار برمیگرداند
curl http://localhost:11434/api/embed -d '{"model": "embeddinggemma-2:270m", "input": "یادداشت جلسهٔ هفتهٔ پیش"}'خروجی یک فهرست عدد است (بردار ۷۶۸ بعدی).
- ۴
در کد پایتون با sentence-transformers
pip install -U sentence-transformersبعد مدل google/embeddinggemma-2 را با SentenceTransformer بار کنید. کارت مدل میگوید با BF16 یا FP32 اجرا کنید، نه FP16.
- ۵
روی گوشی: Google AI Edge Galleryاندروید
https://github.com/google-ai-edge/gallery/releasesپشتیبانی رسمی این مدل از نسخهٔ ۱٫۰٫۲۰ (۶ اکتبر ۲۰۲۶)، همراه با جستوجوی فوری عکسها (Instant Media Search) و پیدا کردن لحظه در ویدئو. از گوگلپلی هم نصب میشود.
دانلود
- Ollama ↗رسمی
چهار اندازه از ۳۷۸ مگابایت تا ۱٫۳ گیگابایت، بهعلاوهٔ نسخههای BF16 و MLX.
- Hugging Face (Google) ↗رسمی
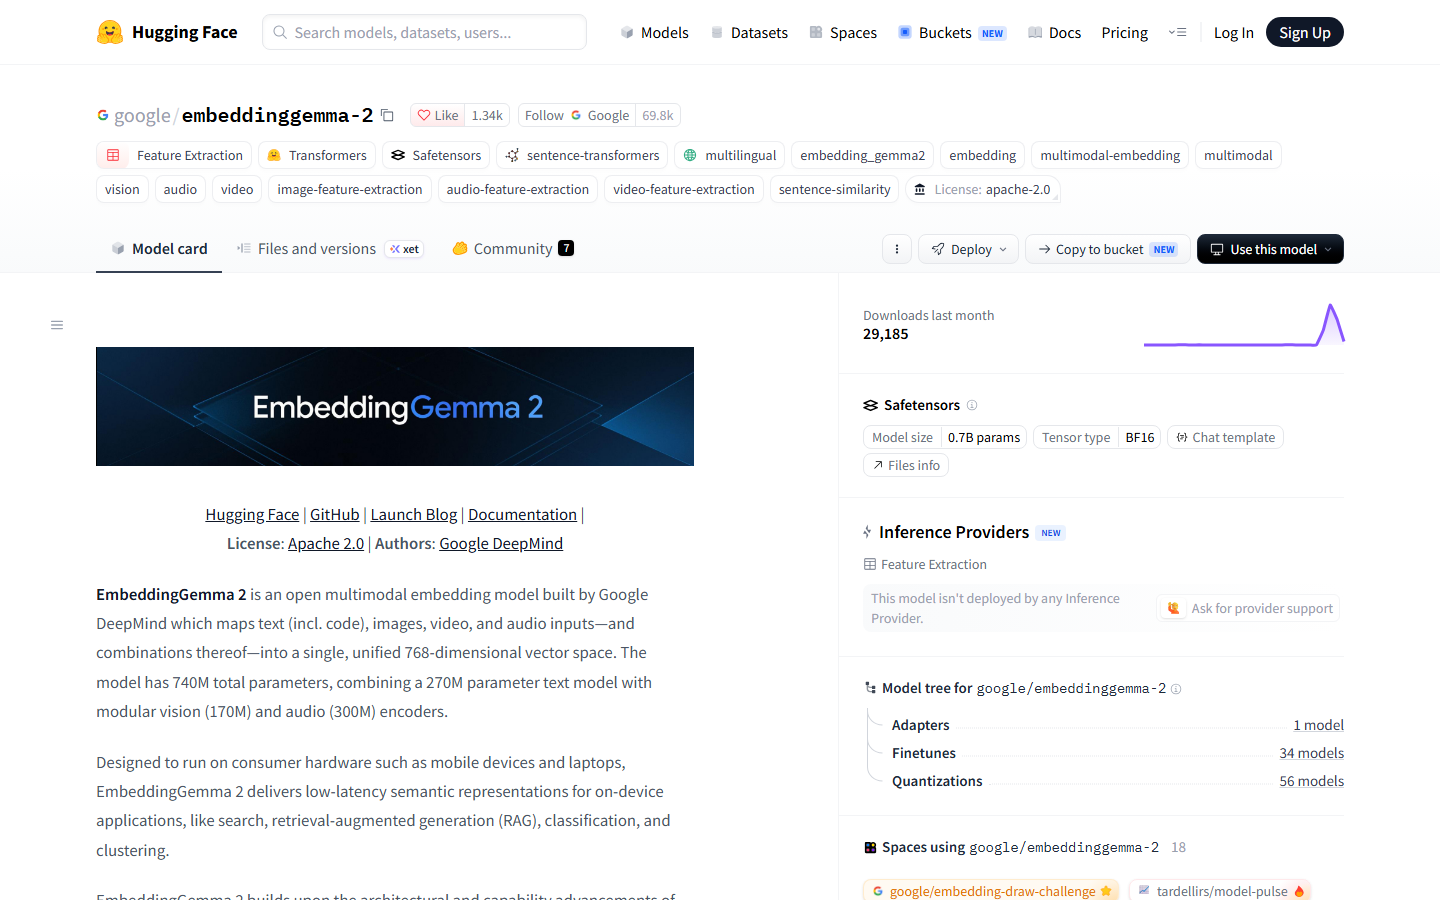
وزنهای اصلی و کارت مدل (sentence-transformers و Transformers)؛ در Kaggle هم هست.
- GGUF (Unsloth) ↗غیررسمی
فایلهای GGUF (۶ اکتبر)؛ ساخت گوگل نیست و پشتیبانی llama.cpp اصلی تأیید نشده.
- Google AI Edge Gallery (GitHub) ↗رسمی
اپ اندروید گوگل؛ پشتیبانی رسمی از این مدل از نسخهٔ ۱٫۰٫۲۰.
نکات امنیتی
- پایگاه برداری را مثل خود فایلها محافظت کنید؛ از روی بردارها میشود بخشی از محتوای اصلی را بازسازی کرد.
- عکسها و یادداشتهای صوتی شخصیاند؛ پایگاه برداریشان را روی همان دستگاه نگه دارید.
- در سیستم RAG سطح دسترسی را رعایت کنید: کسی که به سندی دسترسی ندارد، نباید از راه جستوجو به محتوای آن برسد.
- پورت ۱۱۴۳۴ را روی اینترنت باز نکنید: Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و API آن رمز ندارد؛ اگر روی شبکهٔ داخلی لازمش دارید، پشت پروکسی با احراز هویت یا فایروال بگذارید.
برای شرکتها و سازمانها
برای جستوجوی اسناد شرکت، نسخهٔ 270m روی سرور بدون کارت گرافیک هم اجرا میشود و با کوتاه کردن بردار به ۲۵۶ عدد فضای ذخیره را کم میکنید (امتیاز MTEB چندزبانه از ۶۱٫۳۶ به ۶۰٫۴۱). اگر بیشتر اسناد متن فارسی است، پیش از انتخاب آن را روی چند سند واقعی با Qwen3-Embedding مقایسه کنید. هر وقت مدل بردارساز را عوض کنید، همهٔ اسناد باید دوباره بردارسازی شوند.
برنامههایی که این مدل را اجرا میکنند
 الام استودیو
 لاما سیپیپی
 ویالالام
 گوگل ایآی اج گالری
 آنسلات دسکتاپ
آخرین بررسی: ۱۷ مهر ۱۴۰۵ · انتشار: ۲۳ مهر ۱۴۰۵
معرفی: امبدینگ جما ۲ (آفلاین)
EmbeddingGemma 2 مدل بردارساز (embedding) باز گوگل دیپمایند است که ۶ اکتبر ۲۰۲۶ معرفی شد و روی Gemma 4 ساخته شده. مدل بردارساز متن نمینویسد و به سؤال جواب نمیدهد؛ هر متن، عکس یا تکه صدا را به یک فهرست عدد (بردار) تبدیل میکند، طوری که چیزهای هممعنی بردارهای نزدیک به هم داشته باشند. فرق این نسل این است که متن، کد، تصویر، صدا و ویدئو را در یک فضای ۷۶۸ بعدی مشترک میگذارد؛ پس میشود با یک جملهٔ معمولی یک عکس، یادداشت صوتی یا لحظهای از یک ویدئو را پیدا کرد.
کاربرد اصلیاش جستوجوی معنایی و ساختن یک «از اسنادت بپرس» خصوصی (RAG) روی دستگاه خودتان است. فایلها یک بار بردارسازی و در یک پایگاه برداری نگه داشته میشوند؛ هر پرسش هم بردار میشود، نزدیکترین موارد پیدا میشوند و در صورت نیاز به یک مدل چت آفلاین داده میشوند تا جواب بنویسد. Google AI Edge Gallery در نسخهٔ ۱٫۰٫۲۰ (۶ اکتبر) پشتیبانی رسمی این مدل را آورد، همراه با جستوجوی فوری عکسهای گوشی با جملهٔ معمولی روی خود دستگاه (Instant Media Search) و پیدا کردن لحظه در ویدئو (Video Moment Finder).
اندازهها ماژولار است: فقط متن ۲۷۰ میلیون پارامتر، متن و تصویر ۴۴۰ میلیون، متن و صدا ۵۷۰ میلیون و نسخهٔ کامل با همهٔ ورودیها ۷۴۰ میلیون. در Ollama از ۳۷۸ مگابایت تا ۱٫۳ گیگابایت است و روی گوشی Pixel 11 Pro بعد از فشردهسازی حدود ۱۹۱ مگابایت (فقط متن) تا ۵۶۷ مگابایت (کامل) حافظه گرفته است. حافظهٔ متنی ۸۱۹۲ توکن است که بین همهٔ نوع ورودیها مشترک است، و بردار را میشود به ۵۱۲، ۲۵۶ یا ۱۲۸ عدد کوتاه کرد تا جای کمتری بگیرد.
با چه برنامهای: Ollama (ollama pull embeddinggemma-2)، Google AI Edge Gallery روی گوشی، Unsloth Desktop از نسخهٔ v0.1.903، و برای برنامهنویسها sentence-transformers و Transformers. فایل GGUF را Unsloth منتشر کرده، ولی پشتیبانی llama.cpp اصلی و LM Studio هنوز تأیید نشده است.
فارسی: گوگل از «بیش از ۱۰۰ زبان» حرف میزند ولی فارسی را نام نبرده (نسل اول چندزبانه بود). برای جستوجوی فقط متنی فارسی، Qwen3-Embedding (4B و 8B) و BGE-M3 نتیجهٔ فارسی سنجیدهشده دارند؛ برتری EmbeddingGemma 2 جستوجوی عکس، صدا و ویدئو و حجم خیلی کم آن است.
بهترین کاربردها
- •روی گوشی یا لپتاپ خودم عکسها و ویدیوهایم را آفلاین با یک جملهٔ معمولی جستوجو کنم
- •یک سیستم «از اسنادت بپرس» (RAG) آفلاین روی کامپیوتر خودم بسازم
- •یادداشتهای صوتی را بدون آپلود و روی دستگاه خودم بر اساس معنی پیدا کنم
- •جستوجوی معنایی در اسناد و کد شرکت را روی سرور شرکت و بدون سرویس ابری راه بیندازم
- •یک مدل بردارساز سبک و آفلاین برای Ollama میخواهم
- •بدون اینترنت متن، تصویر و صدا را در یک پایگاه برداری مشترک بگذارم
برای این کارها سراغش نروید
- –چت و نوشتن جواب (مدل بردارساز متن تولید نمیکند)
- –تبدیل گفتار به متن
- –استخراج متن از عکس (OCR)
- –ساخت تصویر یا ویدیو
تصاویر محیط ابزار
نقاط قوت
- ✓متن، کد، تصویر، صدا و ویدئو در یک فضای برداری مشترک؛ جستوجوی عکس و صدا با جملهٔ معمولی
- ✓خیلی سبک: از ۳۷۸ مگابایت (فقط متن) تا ۱٫۳ گیگابایت؛ برای گوشی و لپتاپ ساخته شده
- ✓مجوز Apache 2.0؛ استفادهٔ تجاری آزاد
- ✓بردار قابل کوتاهشدن به ۵۱۲، ۲۵۶ یا ۱۲۸ عدد با افت کم (امتیاز MTEB چندزبانه از ۶۱٫۳۶ به ۶۰٫۴۱ در ۲۵۶)
- ✓پشتیبانی رسمی در Ollama و Google AI Edge Gallery از روز انتشار
- ✓امتیاز MTEB چندزبانه ۶۱٫۳۶ و MTEB کد ۷۸٫۶۸ در گزارش سازنده
نقاط ضعف
- ✗سبک است، ولی بهتنهایی کاری نمیکند: باید کنار پایگاه برداری و برنامه یا کد جستوجو (و برای جواب، یک مدل چت) نصب شود و بردارسازی اولیهٔ هزاران عکس یا ویدئو روی دستگاه ضعیف زمان میبرد
- ✗فارسی در فهرست زبانها نام برده نشده و کیفیتش سنجیده نشده است
- ✗حافظهٔ متنی ۸۱۹۲ توکن؛ متنهای بلند را باید تکهتکه کرد
- ✗پشتیبانی llama.cpp اصلی و LM Studio هنوز تأیید نشده
- ✗نباید با دقت FP16 اجرا شود؛ کارت مدل BF16 یا FP32 را توصیه میکند
قیمتگذاری
رایگان (وزن باز)
Free (open weights)رایگان
- • هر چهار اندازه روی دستگاه خودتان
- • استفادهٔ تجاری آزاد با مجوز Apache 2.0
قیمتها تقریبی و بر اساس آخرین بازبینی است؛ برای قیمت دقیق به سایت رسمی مراجعه کنید.
پرسشهای پرتکرار
مدل بردارساز (embedding) به چه دردی میخورد؟
مدل بردارساز متن نمینویسد؛ هر متن، عکس یا صدا را به یک فهرست عدد (بردار) تبدیل میکند، طوری که چیزهای هممعنی بردارهای نزدیک داشته باشند. با آن جستوجوی معنایی میسازید: فایلها یک بار بردارسازی و در پایگاه برداری نگه داشته میشوند و هر پرسش نزدیکترینها را پیدا میکند، حتی اگر کلمههایش فرق کند. اگر نتیجهها به یک مدل چت آفلاین داده شوند تا جواب بنویسد، به آن RAG میگویند.
با BGE-M3 و Qwen3-Embedding چه فرقی دارد؟
آن دو فقط متن را بردار میکنند و برای متن فارسی نتیجهٔ سنجیدهشده دارند. EmbeddingGemma 2 متن، کد، تصویر، صدا و ویدئو را در یک فضا میگذارد، پس میشود با یک جمله عکس یا یادداشت صوتی پیدا کرد، و خیلی سبکتر است (از ۳۷۸ مگابایت). حافظهٔ متنیاش ۸۱۹۲ توکن است، کمتر از ۳۲ هزار توکن Qwen3-Embedding. برای جستوجوی فقط متنی فارسی، Qwen3-Embedding 4B یا 8B مطمئنتر است.
فارسی بلد است؟
تأیید نشده. گوگل از «بیش از ۱۰۰ زبان» حرف میزند ولی فارسی را نام نبرده و آزمون فارسی منتشر نکرده؛ نسل اول این مدل چندزبانه بود. پیش از ساختن سیستم اصلی، با چند سند و پرسش فارسی واقعی امتحانش کنید.
کدام اندازه را بگیرم؟
برای اسناد متنی و کد 270m (۳۷۸ مگابایت) کافی است. برای جستوجوی عکس 440m (۷۱۴ مگابایت)، برای یادداشتهای صوتی 570m (۹۹۰ مگابایت) و برای ویدئو یا همهٔ ورودیها با هم نسخهٔ کامل 740m (۱٫۳ گیگابایت). هر چهار اندازه روی لپتاپ معمولی اجرا میشوند.
با چه برنامهای استفاده کنم؟
روی کامپیوتر، Ollama را نصب کنید و embeddinggemma-2 را بگیرید؛ برنامههایی که مدل بردارساز را از Ollama میگیرند (مثل Open WebUI و AnythingLLM) معمولاً میتوانند آن را برای متن به کار ببرند، ولی این ترکیب جدا آزموده نشده است. روی گوشی اندروید، Google AI Edge Gallery از نسخهٔ ۱٫۰٫۲۰ این مدل را رسمی پشتیبانی میکند و در همان نسخه جستوجوی عکس با جملهٔ معمولی و پیدا کردن لحظه در ویدئو آمده است. Unsloth Desktop هم از نسخهٔ v0.1.903 آن را دارد و برنامهنویسها از sentence-transformers استفاده میکنند.
استفادهٔ تجاری آزاد است؟
بله؛ مجوز Apache 2.0 است و فقط باید متن مجوز را همراه نسخهای که پخش میکنید نگه دارید.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
بیجیای ام۳ (آفلاین)
BGE-M3 (offline)
مدل بردارساز سبک و پرکاربرد BAAI با ۵۶۸ میلیون پارامتر برای جستوجوی معنایی و «از اسنادت بپرس» خصوصی؛ در سنجههای فارسی نتیجهٔ خوبی دارد، بدون کارت گرافیک اجرا میشود و مجوز MIT دارد.
کوئن ۳ امبدینگ (آفلاین)
Qwen3-Embedding (offline)
مدل بردارساز متن علیبابا در سه اندازه (0.6B، 4B و 8B) برای جستوجوی معنایی و ساخت «از اسنادت بپرس» خصوصی؛ در بازیابی متن فارسی نتیجهٔ خوبی دارد و مجوزش Apache 2.0 است.
اولاما
Ollama
ابزار متنباز و رایگان برای اجرای مدلهای باز مثل Qwen3.5 و Gemma 4 روی ویندوز، مک و لینوکس: با یک دستور مدل را میگیرد و اجرا میکند، برنامهٔ چت دارد و API محلی روی پورت ۱۱۴۳۴ میدهد.