ساعت دو بامداد است و فصل دوم پایاننامه باید صبح به دست استاد راهنما برسد. از ChatGPT (چت جی پی تی) ده منبع تازه خواستهاید و فهرستی بینقص گرفتهاید: نویسندههایی با اسمهای آشنا، مجلههای معتبر، سال، شمارهٔ صفحه و حتی DOI. هفتهٔ بعد استاد روی منبع سوم کلیک میکند و به صفحهٔ «پیدا نشد» میرسد. منابع جعلی هوش مصنوعی معمولاً همینقدر بیسروصدا وارد متن علمی میشوند.
منبع جعلی از آنجا میآید که مدل زبانی، تا وقتی واقعاً جستوجو نکند، ارجاع را از روی الگوهایی که دیده میسازد: گاهی مقالهای که هرگز منتشر نشده و گاهی مقالهٔ واقعی با سال، صفحه یا DOI غلط. ابزارهای مجهز به جستوجو این خطر را کم میکنند، اما گاهی ادعایی را به مقالهای نسبت میدهند که چنین حرفی نزده. راهحل کنار گذاشتن هوش مصنوعی نیست: منبع را از پایگاههای واقعی بردارید و هر ارجاع را پیش از ورود به متن بسنجید؛ کاری که برای بیشتر منابع حدود پنج دقیقه وقت میگیرد.
در ادامه میبینید ارجاع ساختگی چه شکلهایی دارد و چرا پیش میآید، کدام ابزارها منبع واقعی پیدا میکنند، هر رفرنس را چطور در پنج مرحله چک کنید و قواعد استفاده از هوش مصنوعی در پایاننامه چیست.
منابع جعلی هوش مصنوعی چه شکلیاند؟
ارجاع ساختگی همیشه مقالهای خیالی نیست. چهار شکل رایج دارد که از آسانیاب به سختیاب مرتب شدهاند:
مقالهٔ ناموجود با ظاهر واقعی. نام پژوهشگرانی که واقعاً در آن حوزه کار میکنند، مجلهای معتبر و واقعی، سال و جلد و صفحهٔ باورپذیر و عنوانی که انگار برای موضوع شما نوشته شده؛ اما چنین مقالهای هرگز منتشر نشده. در یکی از نخستین پژوهشها دربارهٔ همین مسئله، بیشتر ارجاعهای ساختگی ChatGPT نام مجلهها و ناشرهای واقعی را داشتند.
مقالهٔ واقعی با مشخصات غلط. مقاله وجود دارد، اما سال، جلد، صفحه یا DOI اشتباه است یا نام نویسندهای جابهجا شده. DOI غلط گاهی به هیچجا نمیرسد و گاهی مقالهٔ دیگری را باز میکند.
ارجاع دورگه. عنوان از یک مقاله، نویسندگان از مقالهٔ دیگر و مجله از سومی. هر تکه جداگانه در جستوجو پیدا میشود و همین فریبندهاش میکند.
مقالهٔ واقعی برای حرفی که نزده. ارجاع بیعیب است و DOI هم باز میشود، اما مقاله آن ادعا را نمیکند، برعکسش را میگوید یا دربارهٔ جمعیت و شرایط دیگری است. خطرناکترین نوع همین است، چون از همهٔ آزمونهای ظاهری سالم بیرون میآید و فقط با خواندن خود مقاله لو میرود.
چقدر جدی است؟ از دادگاه نیویورک تا کنفرانسهای هوش مصنوعی
نخستین اندازهگیریهای جدی به سال ۲۰۲۳ برمیگردند. ویلیام والترز و استر وایلدر از ChatGPT خواستند دربارهٔ ۴۲ موضوع مرور ادبیات کوتاه بنویسد و ۶۳۶ ارجاع حاصل را یکییکی وارسی کردند. طبق گزارششان در مجلهٔ Scientific Reports، ۵۵ درصد ارجاعهای GPT-3.5 و ۱۸ درصد ارجاعهای GPT-4 ساختگی بودند و از ارجاعهای واقعی هم بهترتیب ۴۳ و ۲۴ درصد خطای جدی داشتند. در همان سال پژوهشی در مجلهٔ Cureus از ۱۱۵ ارجاعی که ChatGPT با GPT-3.5 برای ۳۰ متن کوتاه پزشکی نوشته بود، ۴۷ درصد را ساختگی و ۴۶ درصد را واقعی اما نادرست یافت؛ فقط ۷ درصد کاملاً درست بودند.
مدلها از آن زمان بهتر شدهاند، اما مسئله حل نشده و از تمرین دانشجویی به دادگاه، گزارش دولتی و کنفرانسهای معتبر رسیده است:
زمان | کجا | چه شد |
|---|---|---|
تیر ۱۴۰۲ | دادگاه فدرال نیویورک، پروندهٔ Mata v. Avianca | دو وکیل برای شش رأی قضایی ساختگی که ChatGPT ساخته بود ۵ هزار دلار جریمه شدند. |
خرداد ۱۴۰۴ | گزارش کمیسیون MAHA دولت آمریکا دربارهٔ سلامت کودکان | دستکم هفت مطالعهٔ ارجاعشده هرگز منتشر نشده بود و برخی مطالعههای واقعی نادرست نقل شده بود. |
مهر ۱۴۰۴ | گزارش Deloitte برای دولت استرالیا، با قراردادی حدود ۴۴۰ هزار دلار استرالیا | ارجاع به مقالههای ناموجود و نقلقولی ساختگی از رأی یک دادگاه. Deloitte استفاده از GPT-4o را اعلام کرد و حدود ۹۷ هزار دلار استرالیا پس داد. |
آذر ۱۴۰۴ | مقالههای در حال داوری کنفرانس ICLR برای دورهٔ ۲۰۲۶ | شرکت GPTZero در نمونهای ۳۰۰تایی، ۵۰ مقاله با دستکم یک ارجاع ساختگی یافت که از چشم بیشتر داوران گذشته بود. |
بهمن ۱۴۰۴ | مقالههای پذیرفتهشدهٔ کنفرانس NeurIPS در سال ۲۰۲۵ | دستکم ۱۰۰ ارجاع ساختگی در ۵۳ مقاله؛ حدود یک درصد کل مقالههای پذیرفتهشده. |
اردیبهشت ۱۴۰۵ | arXiv، مخزن مشهور پیشانتشار مقالهها، بخش علوم کامپیوتر | قاعدهٔ تازه: اگر ارجاع ساختگی یا متن کنترلنشدهٔ هوش مصنوعی در مقالهای ثابت شود، نویسنده یک سال از ارسال مقاله محروم میشود. |
مقیاس ماجرا هم کوچک نیست. پایگاهی که دیمین شارلوتن از پروندههای دادگاهی مربوط به محتوای ساختگی هوش مصنوعی گردآوری میکند، تا تابستان ۱۴۰۵ از ۱۶۰۰ پرونده گذشته بود و مبلغ محکومیتها از ۵ هزار دلار پروندهٔ Avianca به بیش از ۱۰۰ هزار دلار در پروندهای در ایالت اورگن رسیده است. پیشانتشاری در بهار ۱۴۰۵ هم با بررسی ۱۱۱ میلیون ارجاع در ۲٫۵ میلیون مقاله، فقط برای سال ۲۰۲۵ و با برآوردی محتاطانه، حدود ۱۴۷ هزار ارجاع ساختگی تخمین زد.
در این نمونهها داوران باتجربه، وکیلها و مشاوران گرانقیمت خطا را ندیدند و دیگران پیدایش کردند؛ چون ارجاع ساختگی از بیرون درست شبیه ارجاع واقعی است.
چرا ChatGPT رفرنس ساختگی میسازد؟
مدل زبانی کتابخانه نیست؛ پیشبینیکنندهٔ متن است و تکهبهتکه حدس میزند چه چیزی به احتمال زیاد بعد میآید. ارجاع علمی هم برایش الگویی آشناست: نام خانوادگی، حرف اول نام، سال داخل پرانتز، عنوانی با دونقطه، نام مجله، جلد، صفحه و رشتهای که با 10. شروع میشود. مدلی که میلیونها ارجاع دیده، میتواند ارجاعی بنویسد که از هر نظر شبیه ارجاع است، بیآنکه جایی را جستوجو کرده باشد. ارجاع برای او یک الگوست، نه نتیجهٔ جستوجو.
پژوهشگرانی از OpenAI در مقالهای در شهریور ۱۴۰۴ توضیح دادند که آموزش و ارزیابی مدلها به حدس زدن بیشتر از گفتن «نمیدانم» پاداش میدهد؛ مثل امتحانی که جای خالی نمره ندارد ولی حدس شاید نمره بگیرد. حدس هم بیشتر جایی رخ میدهد که واقعیت در دادههای آموزشی کم تکرار شده، مثل تاریخ تولد آدمها. شمارهٔ جلد، صفحه و DOI یک مقاله هم از همین جنساند.
برای همین، پرسیدن از خود چتبات که «این منبع واقعی است؟» کمکی نمیکند. وکیل پروندهٔ Avianca همین را پرسید و ChatGPT جواب داد این رأیها «واقعاً وجود دارند»؛ والترز و وایلدر هم دیدند ChatGPT وقتی درستی ارجاعهای خودش را میسنجد، اغلب جواب نادرست میدهد. نقطههای کور دیگر دستیارهای عمومی را در مقالهٔ هر دستیار یک نقطه کور دارد مرور کردهایم.
ابزارهای مجهز به جستوجو چطور؟
وقتی ابزار واقعاً جستوجو میکند و متن منبع را جلوی مدل میگذارد (به این پاسخ «مستند» میگویند)، مقالهٔ کاملاً خیالی خیلی کمتر پیش میآید، چون ارجاع از سندی واقعی برداشته شده. اما جملهٔ پاسخ را هنوز مدل مینویسد و ممکن است سند را بد بخواند. پژوهشگران استنفورد ابزارهای حقوقی مجهز به جستوجوی LexisNexis و Thomson Reuters را آزمودند و هر کدام در ۱۷ تا ۳۳ درصد موارد خطا داشتند؛ در تعریف آنها، نسبت دادن ادعا به منبعی که پشتیبانیاش نمیکند هم خطا بود. پیشانتشار دیگری در همان بهار هم نشان داد ۳ تا ۱۳ درصد نشانیهایی که مدلها و عاملهای «پژوهش عمیق» بهعنوان منبع میدهند، احتمالاً هرگز وجود نداشتهاند.
پس ابزار مستند منبع ناموجود را کم میکند، اما نسبت دادن ادعا به منبع اشتباه همچنان ممکن است.
پیدا کردن منبع با هوش مصنوعی: کدام ابزار برای چه کاری؟
برای دور ماندن از منابع جعلی هوش مصنوعی، قاعده ساده است: منبع را از ابزاری بگیرید که آن را از پایگاهی واقعی بیرون میکشد و لینکش را میدهد، نه از حافظهٔ یک چتبات. ابزارهای زیر همین کار را میکنند، هر کدام برای مرحلهای خاص:
ابزار | به درد چه کاری میخورد | کجا حواستان باشد | پلن رایگان |
|---|---|---|---|
پرسیدن سؤال پژوهشی و گرفتن خلاصهای که هر ادعایش به مقالهٔ داوریشدهٔ واقعی لینک دارد | خلاصه ممکن است مقاله را بد بخواند؛ منبع فارسی و علوم انسانی را کم پوشش میدهد | دارد، با سهمیهٔ محدود | |
مرور ادبیات و مرور نظاممند: جدول روش، نمونه و یافتههای دهها مقاله | فارسی را محدود پشتیبانی میکند؛ هر خانهٔ جدول را با متن مقاله تطبیق دهید | جستوجو و خلاصهٔ نامحدود؛ Pro حدود ۴۹ دلار در ماه با پرداخت سالانه | |
جستوجوی زنده با منبع؛ برای گزارشها، آمار و متنهای تازه | صفحهٔ وب و مقاله را کنار هم میآورد؛ اعتبار هر منبع را خودتان بسنجید | دارد؛ Pro حدود ۲۰ دلار در ماه | |
پیدا کردن مقالههای مرتبط از روی شبکهٔ استنادها، با شروع از چند مقالهٔ کلیدی | کارشان کشف است، نه خلاصه؛ نتیجه به مقالههای شروع بستگی دارد | هر دو دارند؛ نسخهٔ پولی از حدود ۱۰ دلار در ماه با پرداخت سالانه | |
Gemini Notebook (جمنای نوتبوک، همان NotebookLM) و Humata (هوماتا) | پرسیدن از فایلهای PDF خودتان، با ارجاع به همان بخش فایل | فقط به اندازهٔ فایلهایی که به آنها میدهید خوباند | دارند؛ Humata تا ۶۰ صفحه در ماه |
کنار اینها سه ابزار رایگان ستون اصلی بررسیاند: Google Scholar (گوگل اسکالر)؛ Semantic Scholar (سمانتیک اسکالر) با بیش از ۲۰۰ میلیون مقاله، که مؤسسهٔ غیرانتفاعی Ai2 ادارهاش میکند؛ و جستوجوی Crossref، جایی که بسیاری از ناشران علمی DOI مقالههایشان را ثبت میکنند. پلن پولی بیشتر ابزارهای خارجی این فهرست کارت بینالمللی میخواهد.
منابع فارسی را کجا بسنجیم؟
ابزارهای خارجی مقالههای فارسی را کم میشناسند؛ برای منبع فارسی سراغ پایگاههای ایرانی بروید: SID (مرکز اطلاعات علمی جهاد دانشگاهی) و مگیران برای مقالههای نشریهها، نورمگز برای مجلههای علوم انسانی و اسلامی، سیویلیکا برای مقالههای همایش و ژورنال، و «گنج» ایرانداک برای پایاننامهها، رسالهها و طرحهای پژوهشی. در علوم اسلامی و انسانی، چتبات کتابخانهٔ نور (نورلایب) هم جواب را از متن کتابهای همان کتابخانه با نام کتاب، جلد و صفحه میدهد.
نمیدانید برای موضوع خودتان از کدام ابزار شروع کنید؟ در هوش یاب بنویسید: «برای پایاننامهام منابع معتبر پیدا کن و خلاصه کن» تا ابزارهای مناسب و یک نقشهٔ راه مرحلهبهمرحله با پرامپت آماده بگیرید.
چک کردن رفرنس در پنج دقیقه: روال پنجمرحلهای
نشانههای مشکوک در یک نگاه
عنوانی که کلمهبهکلمه همان جملهٔ شما یا عنوان پایاننامهتان است.
نویسندهٔ سرشناسی که این مقاله در فهرست آثارش، مثلاً پروفایل Google Scholar او، نیست.
جلد و سالی که با عمر آن مجله جور درنمیآید.
فهرستی که همهاش از چند سال اخیر است و هر منبعش بیکموکاست به جملهٔ شما میخورد؛ ادبیات واقعی شلختهتر است.
نشریهٔ فارسیای که در هیچ پایگاه ایرانی پیدا نمیشود.
پنج مرحله برای هر منبع
DOI را باز کنید. آن را بعد از
https://doi.org/بچسبانید؛ باید به صفحهٔ ناشر و همان عنوان برسید. اگر به خطا رسیدید یا مقالهٔ دیگری باز شد، ارجاع را کنار بگذارید. بسیاری از مقالههای فارسی و همایشی DOI ندارند؛ برای آنها مستقیم به مرحلهٔ دوم بروید.عنوان دقیق را جستوجو کنید. عنوان کامل را بین دو علامت نقلقول انگلیسی در Google Scholar یا Semantic Scholar بگذارید؛ برای منبع فارسی در SID، مگیران، نورمگز، سیویلیکا یا گنج. اگر هیچجا نتیجهای نیامد، احتمال ساختگی بودن جدی است.
مشخصات را تطبیق دهید. نویسندگان و ترتیبشان، سال، مجله، جلد، شماره و صفحه را با صفحهٔ ناشر مقایسه کنید و ارجاع را از روی همان صفحه درست کنید، نه از روی پاسخ چتبات. راه سادهتر: DOI را در Zotero (زوترو) با دکمهٔ Add Item by Identifier وارد کنید تا مشخصات درست خودش بیاید.
مقاله را باز کنید و ادعا را پیدا کنید. دستکم چکیده و بخشی را که ادعای شما به آن تکیه دارد بخوانید و ببینید مقاله دقیقاً همان را میگوید، دربارهٔ همان جمعیت و با همان قطعیت. فقط این مرحله نوع چهارم را لو میدهد.
وضعیت مقاله را چک کنید. در صفحهٔ ناشر دنبال برچسبهایی مثل Retracted یا Correction بگردید، یا مقاله را در پایگاه Retraction Watch جستوجو کنید که Crossref در سال ۲۰۲۳ خرید و در دسترس همه گذاشت. Zotero هم مقالههای پسگرفتهشدهٔ کتابخانهتان را، اگر DOI یا PMID داشته باشند، خودکار علامت میزند.
برای فهرست بلند، اول همهٔ ارجاعها را در ابزار رایگان Simple Text Query کراسرف بچسبانید؛ تا هزار ارجاع در هر نوبت و بدون ثبتنام برایشان DOI پیدا میکند. ارجاعی که DOI نگرفت لزوماً ساختگی نیست، اما میفهمید بررسی را از کجا شروع کنید.
چه پرامپتی بنویسیم که منبع ساختگی نگیریم؟
پرامپت خوب چتبات بدون جستوجو را کتابخانه نمیکند، اما در ابزاری که جستوجو میکند جلوی حدس زدن را میگیرد. مقایسه کنید:
پیش از: «برای پایاننامهام دربارهٔ اهمالکاری تحصیلی ده منبع معتبر با DOI بده.» این جمله مدل را وادار میکند ده مورد تحویل دهد، چه پیدا کرده باشد چه نه.
بعد از: همان درخواست، بهاضافهٔ «فقط چیزی را بیاور که همین حالا پیدا کردهای و اگر کمتر پیدا شد، بگو». حالا «پیدا نشد» هم جوابی پذیرفتنی است.
۱. منبعیابی: با جستوجو، مقالههای داوریشده دربارهٔ [موضوع] در سالهای [بازه] پیدا کن و فقط منابعی را بیاور که همین حالا پیدا و باز کردهای. برای هر منبع عنوان کامل، نویسندگان، سال، مجله، DOI یا نشانی و یک جمله از چکیدهاش را بنویس. اگر کمتر از [تعداد] منبع مطمئن پیدا کردی، همانها را بده و بنویس «بیشتر پیدا نشد». هر موردی را که مطمئن نیستی، جدا و با برچسب «نیازمند بررسی» بیاور.
۲. بررسی فهرست منابع: این فهرست منابع را یکییکی جستوجو کن و در جدولی با این ستونها گزارش بده: شمارهٔ منبع، وضعیت («پیدا شد»، «با اختلاف پیدا شد»، «پیدا نشد»)، اختلافها (نویسنده، سال، مجله، جلد، صفحه، DOI) و لینک صفحهای که پیدا کردی. چیزی را که پیدا نکردی تأیید نکن و جاهای خالی را از خودت پر نکن. [فهرست منابع]
۳. ادعا و منبع: متن زیر را بخوان و هر ادعای علمی آن را جدا کن؛ یعنی هر جملهای که عدد، نتیجهٔ یک پژوهش یا رابطهٔ علت و معلولی دارد. در جدولی بنویس: عین جملهٔ ادعا، منبعی که برایش ذکر شده، و «بدون منبع» اگر ارجاعی ندارد. منبع تازه پیشنهاد نده و جملهها را بازنویسی نکن. [متن]
موضوع، بازهٔ سال و سبک ارجاع (مثلاً APA 7) را با کار خودتان عوض کنید. پرامپت دوم فقط در ابزاری معنا دارد که جستوجو میکند، مثل Perplexity یا ChatGPT با جستوجوی روشن، و خروجیاش فهرست کار است نه حکم نهایی. جدول پرامپت سوم را کنار PDF منبعها در Gemini Notebook بگذارید و برای هر ادعا بپرسید: «کدام جملهٔ این منبع این را میگوید؟ عین جمله را با شمارهٔ صفحه بیاور.» برای ادبیات انگلیسی، این نسخه از پرامپت اول را به کار ببرید:
Search for peer-reviewed studies on [topic] published in [years].
List only sources you actually retrieved in this session.
For each: full title, authors, year, journal, DOI or URL,
and one sentence quoted from the abstract.
If you find fewer than [n] reliable sources, say so.
Never fill in missing details from memory.
نوشتن پایاننامه با هوش مصنوعی: قانون و دانشگاه چه میگویند؟
آنچه میآید اطلاعرسانی است، نه مشاورهٔ حقوقی؛ آییننامهٔ دانشگاه خودتان را هم بخوانید و از استاد راهنما بپرسید.
قانون ۱۳۹۶ دربارهٔ چه کسی است؟
قانون پیشگیری و مقابله با تقلب در تهیه آثار علمی، مصوب مرداد ۱۳۹۶، پایاننامهفروشی را هدف گرفته است: تهیه، عرضه یا واگذاری پایاننامه، رساله، مقاله و آثار مشابه به قصد انتفاع و بهعنوان حرفه، تا دیگری آن را اثر خودش جا بزند، جرم است. تبصرهٔ ۵ خدمات متعارفی مثل تایپ، ترجمه، کمک به گردآوری داده و ویراستاری را استثنا کرده است. طبق تبصرهٔ ۶، دانشجو یا عضو هیئت علمیای که از چنین اثری استفاده کند، امتیازهایش را از دست میدهد، مدرکش ملغیالاثر میشود و به تخلفش رسیدگی انضباطی میشود. این قانون پیش از هوش مصنوعی مولد نوشته شده و نامی از آن نمیبرد.
راهنمای وزارت علوم برای هوش مصنوعی
مشخصترین قاعده برای دانشجو «راهنمای استفاده از ابزارهای هوش مصنوعی در پژوهش» است که آبان ۱۴۰۴ از سوی وزارت علوم ابلاغ شد:
مجاز، با نظارت و بازبینی خودتان: ویرایش زبانی و ترجمه، ایدهپردازی، خلاصه کردن مقالهها برای فهم بهتر، و کمک در تحلیل داده و کدنویسی.
غیرمجاز: «جعل و تحریف منابع»، که به تصریح راهنما «تولید منابع جعلی» و «ایجاد ارجاعات غیرواقعی» را هم در بر میگیرد؛ ساختن داده و نتیجه؛ سپردن کل پیشنویس یا پژوهش به هوش مصنوعی بدون بازنگری؛ و استفادهٔ پنهان در تکلیفهای درسی بدون تأیید استاد.
اعلام: نام ابزار، نقشش و شیوهٔ بررسی خروجی را در «تقدیر و تشکر» یا بخشی با عنوان «بیانیهٔ استفاده از هوش مصنوعی» بنویسید. هوش مصنوعی هیچوقت پدیدآورندهٔ اثر شناخته نمیشود و مسئولیت درستی ارجاعها با خود شماست.
راهنما از پژوهشگر میخواهد پیش از ارسال اثر، قواعد هوش مصنوعی ناشر یا مجلهٔ مقصد را هم بداند و رعایت کند؛ رعایت نکردنشان میتواند به رد اثر، ابطال انتشار یا پیامد حقوقی برسد و ناآگاهی رافع مسئولیت نیست.
مجلهها و ناشران بینالمللی
کمیتهٔ اخلاق نشر (COPE) و ناشرانی مثل Springer Nature و Elsevier در اصل ماجرا همنظرند: هوش مصنوعی نمیتواند نویسنده باشد، چون نمیتواند مسئولیت اثر را بپذیرد، و استفاده از آن باید اعلام شود؛ ویرایش سادهٔ املایی و دستوری معمولاً اعلام لازم ندارد. سیاست Elsevier صریحاً میگوید ارجاعهای ساخت هوش مصنوعی ممکن است نادرست یا ساختگی باشند و وجود ارجاع ساختگی میتواند به رد مقاله برسد.
گردشکار امن: از موضوع پژوهش تا Zotero
سؤال را دقیق کنید. با یک چتبات عمومی مثل ChatGPT موضوع را بشکنید و کلیدواژههای فارسی و انگلیسی بسازید؛ در این مرحله منبع نخواهید.
منبع را از پایگاه بگیرید. سؤال را در Consensus یا Elicit مطرح کنید، کلیدواژهها را در Google Scholar و Semantic Scholar بگردید و برای ادبیات فارسی سراغ SID، مگیران و گنج بروید.
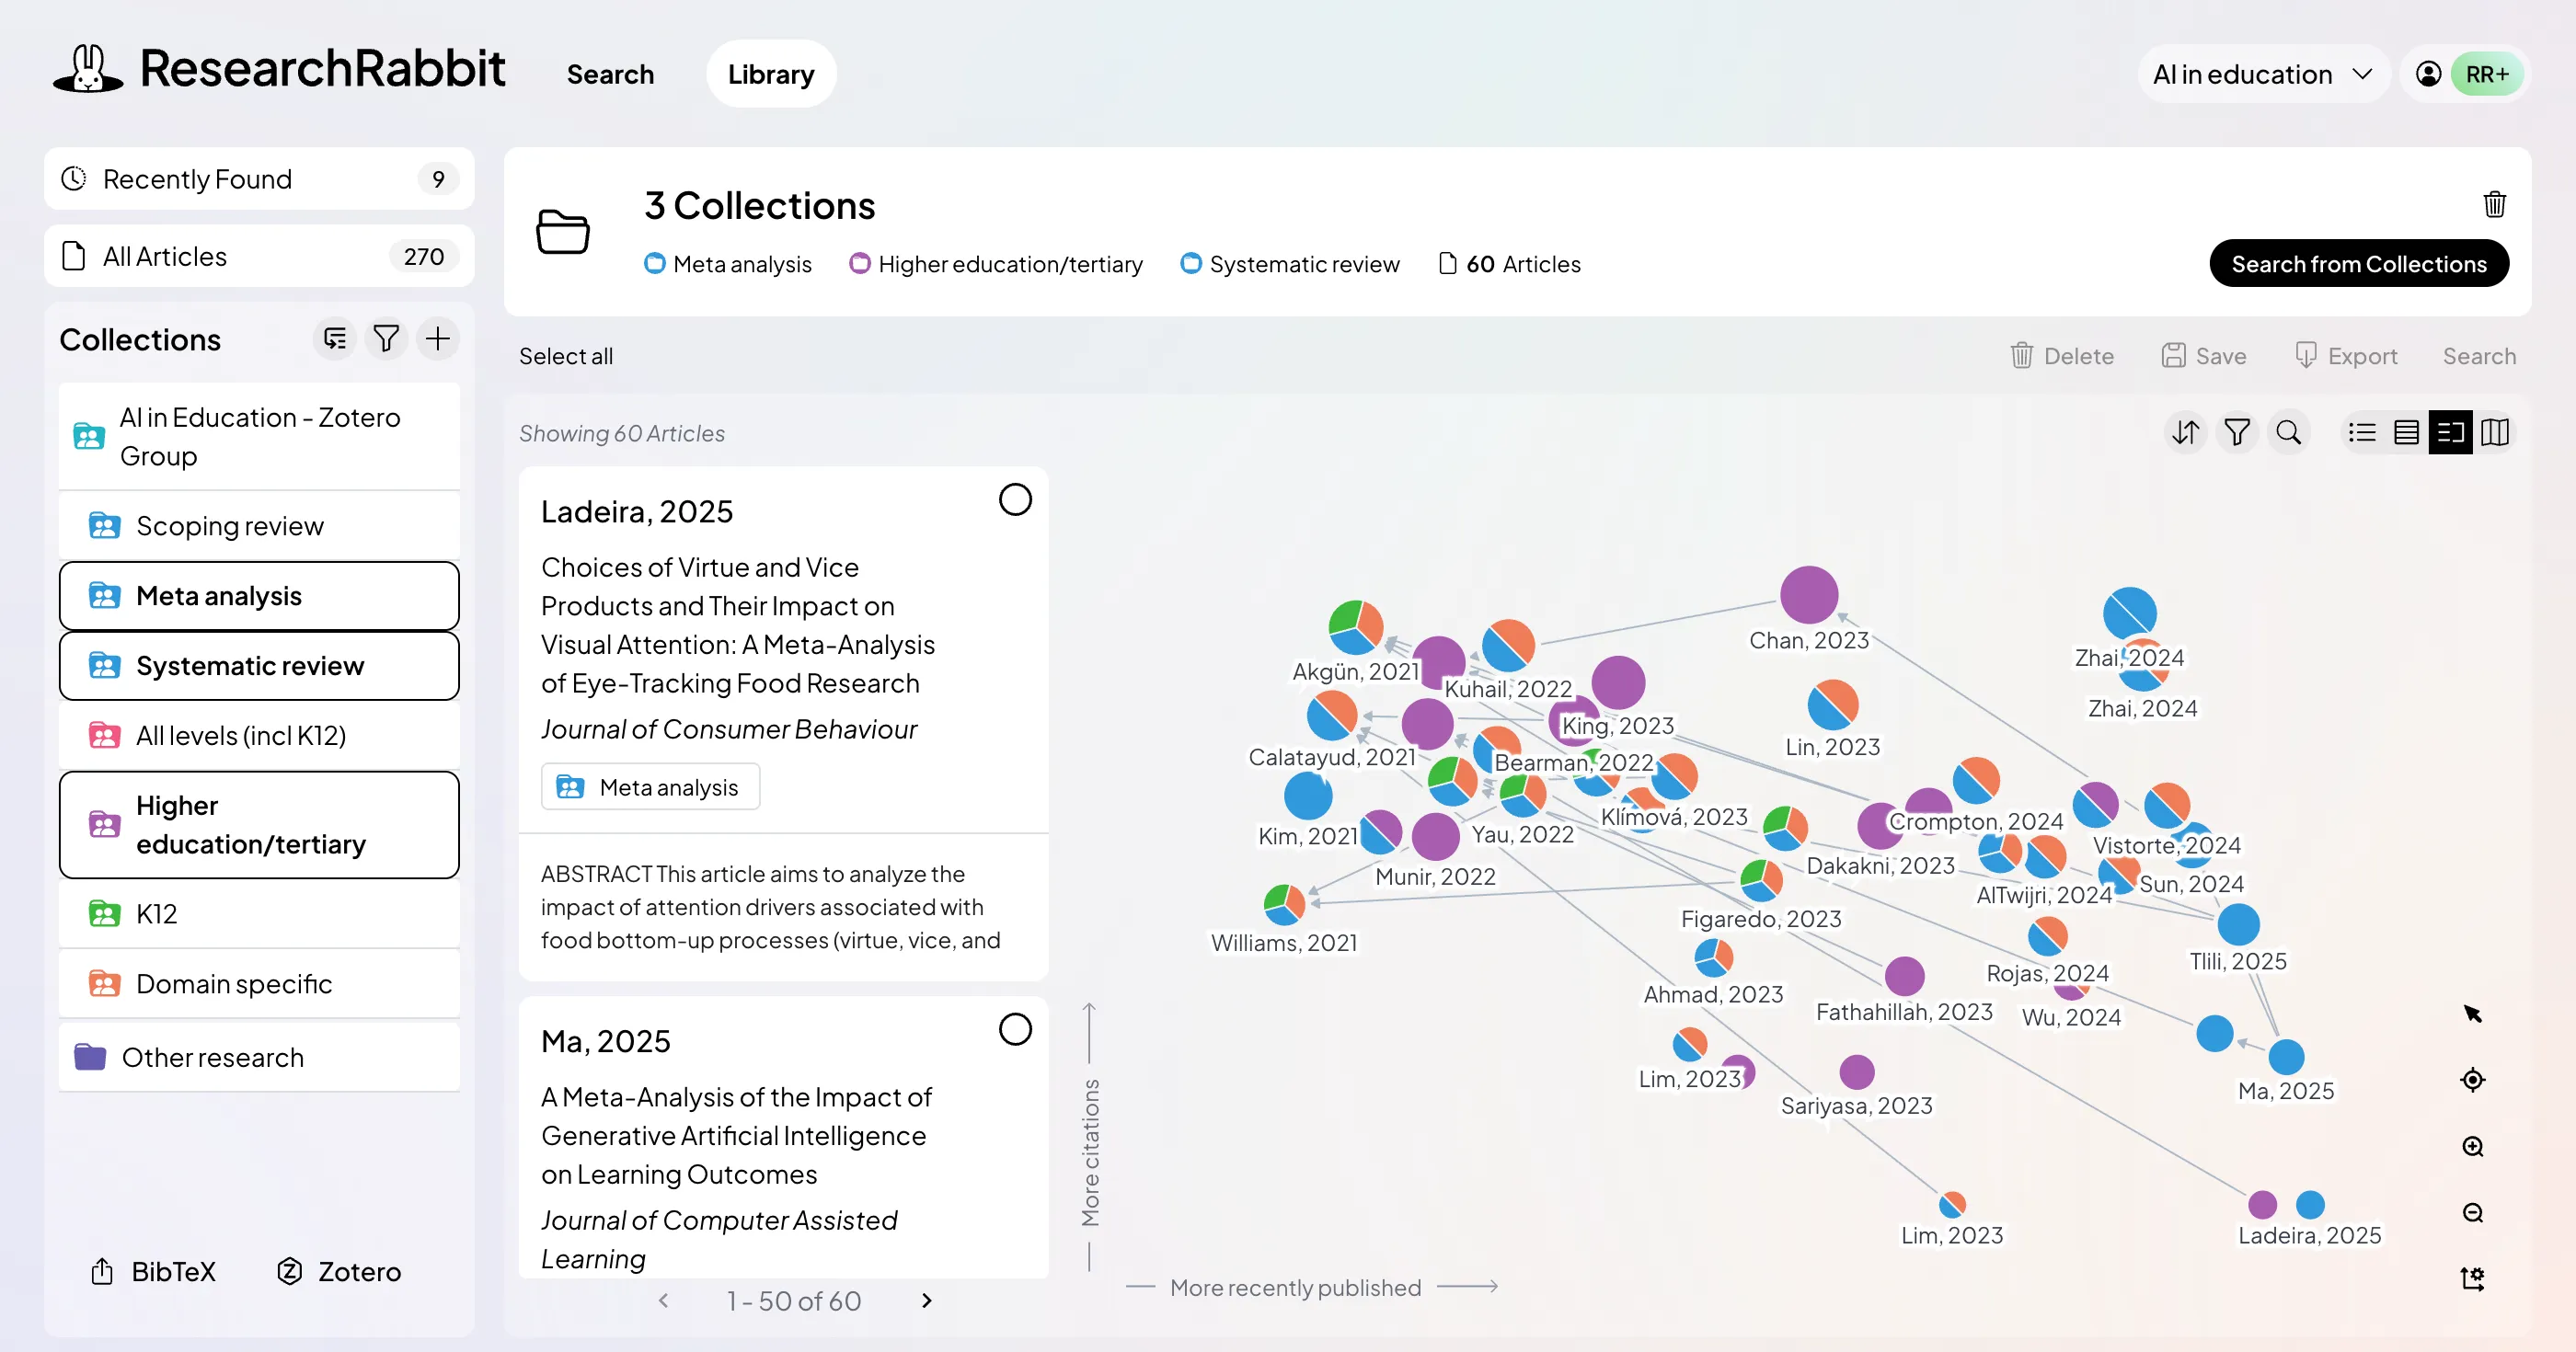
دامنه را با استنادها باز کنید. سه تا پنج مقالهٔ کلیدی را به ResearchRabbit یا Litmaps بدهید تا مقالههای پایه و تازهای را که جا انداختهاید ببینید.
همهچیز را مستقیم در Zotero ذخیره کنید. Zotero رایگان و متنباز است؛ مقاله را با افزونهٔ مرورگرش (Zotero Connector) یا با DOI اضافه کنید و هیچ ارجاعی را دستی تایپ یا از پاسخ چتبات کپی نکنید.
بخوانید و یادداشت بردارید. فایلهای PDF را در Gemini Notebook یا Humata بگذارید و کنار هر جواب، جمله و صفحهٔ منبع را بخواهید؛ بعد همان صفحه را خودتان بخوانید. این مرحله را در مقالهٔ جزوهای که با شما حرف میزند مفصلتر گفتهایم.
خودتان بنویسید، ارجاع را Zotero بگذارد. با افزونهٔ Word یا LibreOffice ارجاع درج کنید، یا اگر در Overleaf (اورلیف) با LaTeX مینویسید، از Zotero خروجی BibTeX بگیرید. اگر برای روان کردن متن فارسی از هوش مصنوعی کمک گرفتید، مراقب ترجمهزدگی باشید.
پیش از تحویل، یک دور کامل بسنجید و بیانیهٔ استفاده از هوش مصنوعی را بنویسید.
جمعبندی: به منبعی که باز نکردهاید ارجاع ندهید
منابع جعلی هوش مصنوعی نتیجهٔ طبیعی ابزاریاند که برای نوشتن متن باورپذیر ساخته شده، نه برای پیدا کردن سند. پس نقشها را جدا کنید: پیدا کردن منبع کار پایگاهها و ابزارهای مستند است، سنجیدنش کار شما، و هوش مصنوعی در فکر کردن، خلاصه کردن و ویرایش کمکتان میکند. یک قاعده بیشتر دردسرها را از بین میبرد: به هیچ منبعی که خودتان باز نکردهاید، ارجاع ندهید.
قدم بعدی: در هوش یاب بنویسید «برای مرور ادبیات پایاننامهام مقالههای معتبر پیدا کن» تا ابزارها و نقشهٔ راه همین کار را ببینید.
پرسشهای پرتکرار
آیا ChatGPT منبع واقعی میدهد؟
گاهی بله و گاهی نه، و از ظاهر ارجاع نمیشود فهمید. وقتی جستوجو خاموش است، ChatGPT ارجاع را از الگوهایی که دیده میسازد و ممکن است مقالهٔ ناموجود یا مقالهٔ واقعی با مشخصات غلط بدهد. با جستوجوی روشن، منبعها معمولاً واقعیاند، اما گاهی ادعایی را به منبعی نسبت میدهد که آن را نگفته. پس هر ارجاع را خودتان بسنجید.
چطور بفهمم یک رفرنس ساختگی است؟
اول DOI را در doi.org باز کنید و ببینید به همان مقاله میرسد یا نه. بعد عنوان دقیق را در Google Scholar یا Semantic Scholar بگردید؛ برای منبع فارسی در SID، مگیران یا گنج. نویسندگان، سال، مجله، جلد و صفحه را با صفحهٔ ناشر تطبیق دهید. اگر هیچجا نتیجهای نیامد، احتمالاً ساختگی است؛ اگر آمد، مقاله را باز کنید و مطمئن شوید همان ادعا در آن هست.
استفاده از هوش مصنوعی در پایاننامه تقلب است؟
بهخودیخود نه. طبق راهنمای وزارت علوم که آبان ۱۴۰۴ ابلاغ شد، ویرایش زبانی، ترجمه، ایدهپردازی و خلاصه کردن مقالهها با نظارت خودتان مجاز است، به شرط اینکه نوع استفاده را اعلام کنید. اما ساختن منبع یا داده، سپردن کل پیشنویس به هوش مصنوعی و استفادهٔ پنهان از استاد مجاز نیست. قانون ۱۳۹۶ هم تهیهٔ پایاننامه برای دیگران بهعنوان حرفه را جرم میداند.
بهترین هوش مصنوعی برای پیدا کردن منبع کدام است؟
یک ابزار برای همهٔ مراحل وجود ندارد: Consensus برای پرسیدن سؤال پژوهشی و گرفتن خلاصهٔ مستند، Elicit برای مرور ادبیات، ResearchRabbit یا Litmaps برای پیدا کردن مقالههای مرتبط از روی استنادها و Gemini Notebook برای پرسیدن از فایلهای PDF خودتان. برای منبع فارسی، پایگاههای ایرانی مثل SID، مگیران، نورمگز و گنج هنوز بهترین نقطهٔ شروعاند.
چطور به خود ChatGPT ارجاع بدهم؟
اگر متن یا ایدهای را مستقیم از هوش مصنوعی گرفتهاید، آن را مثل هر منبع دیگری ذکر کنید؛ در سبک APA سازنده (مثلاً OpenAI) جای نویسنده مینشیند و سال، نام ابزار و نسخه، توضیح «مدل زبانی بزرگ» و نشانی میآید. راهنمای وزارت علوم برای APA و MLA و شیکاگو نمونه آورده است. اما ChatGPT را منبع یک واقعیت علمی نکنید؛ برای آن به مقالهای ارجاع دهید که خودتان خواندهاید.
منابع
والترز و وایلدر، ارجاعهای ساختگی و خطادار ChatGPT (Scientific Reports، ۲۰۲۳)
باتاچاریا و همکاران، ارجاعهای ساختگی در متنهای پزشکی ChatGPT (Cureus، ۲۰۲۳)
گزارش GPTZero دربارهٔ ارجاعهای ساختگی در مقالههای پذیرفتهشدهٔ NeurIPS
متن قانون پیشگیری و مقابله با تقلب در تهیه آثار علمی (مرکز پژوهشهای مجلس)
خبر ابلاغ راهنمای استفاده از ابزارهای هوش مصنوعی در پژوهش (آبان ۱۴۰۴)