کوئن ۳.۸ فلش نکست (آفلاین)
Qwen3.8-Flash-Next (offline)قویترین مدل باز Qwen3.8 که میشود روی سیستم خود اجرا کرد (اوت ۲۰۲۶): ۱۲۵ میلیارد پارامتر که در هر توکن فقط ۶ میلیاردش کار میکند، با فهم تصویر و ویدئو و حافظهٔ متنی ۲۶۲ هزار توکنی. در جدول Qwen از Qwen3.8-27B جلوتر است، ولی نسخهٔ ۴ بیتیاش ۹۶ تا ۱۲۰ گیگابایت حافظه میخواهد: مک یا کامپیوتر ۱۲۸ گیگابایتی.
اجرا روی سیستم خودتان
این مدل را یک بار دانلود میکنید و بعد بدون اینترنت روی لپتاپ، کامپیوتر یا سرور خودتان اجرایش میکنید.
- بعد از نصب، بدون اینترنت
- وزنهای باز
- Qwen Community License 1.0 — استفادهٔ تجاری با شرط
- فارسی: نامعلوم
بعد از دانلود کاملاً آفلاین کار میکند و همهٔ برچسبهای فهرستشدهٔ Ollama برای این مدل محلیاند. دانلود ۹۰ تا ۱۲۰ گیگابایتی را روی اینترنت پایدار انجام دهید یا فایلها را از سیستم دیگری منتقل کنید.
استفادهٔ تجاری آزاد است، با دو شرط. اول اینکه محصولی با بیش از ۱۰۰ میلیون کاربر فعال ماهانه یا بیش از ۲۰ میلیون دلار درآمد ماهانه باید نام مدل را بهطور برجسته نشان دهد. دوم اینکه شرکتی که کسبوکارش عرضهٔ مدل بهصورت سرویس (Model as a Service) یا «دستیار کاری هوش مصنوعی» (دستیار کدنویسی یا کارهای اداری) است، برای استفادهٔ تجاری مجوز جدا از Qwen میخواهد؛ استفادهٔ داخلی شرکتها از این شرط مستثناست. Qwen3.8-27B با Apache 2.0 این شرطها را ندارد.
نسخهها و سختافزار لازم
- 125B-A6B q4_K_M (Ollama)۱۲۵B (فعال ۶B)طول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۱۲۰ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۱۲۰ گیگ یا رم ۱۲۸ گیگ
ollama run qwen3.8-flash-next:125b-a6b-q4_K_Mبرچسب اصلی Ollama؛ ۱۲۰ گیگابایت، پس عملاً دستگاه ۱۲۸ گیگابایتی یا بیشتر لازم است. نسخهٔ ۸ بیتی (125b-a6b-q8_0) ۱۸۹ و BF16 ۳۵۵ گیگابایت است. Ollama برای همهٔ برچسبها ورودی متن و تصویر و حافظهٔ متنی ۲۵۶ هزار توکنی را فهرست کرده.
- MLX nvfp4 (Ollama، مک)۱۲۵B (فعال ۶B)طول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۱۰۵ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۱۰۵ گیگ یا رم ۱۲۸ گیگ
ollama run qwen3.8-flash-next:125b-a6b-nvfp4برای مک با تراشهٔ اپل؛ ۱۰۵ گیگابایت. برچسب 125b-mlx هم همین حجم را دارد و نسخهٔ کامل MLX (125b-a6b-mlx-bf16) ۳۶۰ گیگابایت است. Ollama از نسخهٔ ۰٫۴۰ روی مکهای اپل سیلیکون مدلهای پشتیبانیشده را بهطور پیشفرض با MLX اجرا میکند.
- UD-Q4_K_XL (Unsloth GGUF)۱۲۵B (فعال ۶B)طول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۱۱۱ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۱۱۴ گیگ یا رم ۱۱۴ گیگ
برای llama.cpp نسخهٔ ۰٫۶٫۰ به بعد، KoboldCpp و Unsloth Desktop. طبق Unsloth نسخهٔ ۴ بیتی ۹۶ تا ۱۱۴ گیگابایت حافظه میخواهد. فایلهای کوچک MTP (حدود ۲ تا ۸ گیگابایت) برای سرعت بیشتر هم در مخزن هست. فایل بینایی (mmproj) فهرست نشده و راهاندازی ورودی تصویر مستند نیست.
- UD-IQ4_XS (Unsloth GGUF)۱۲۵B (فعال ۶B)طول متن ۲۵۶ هزار توکن
- حجم دانلود:
- ۹۳٫۷ گیگ
- حافظهٔ لازم:
- کارت گرافیک ۹۶ گیگ یا رم ۹۶ گیگ
کوچکترین فایل ۴ بیتی و گزینهٔ دستگاههای ۹۶ تا ۱۲۸ گیگابایتی: مک ۱۲۸ گیگ، AMD Strix Halo یا DGX Spark. کامپیوتر با کارت ۲۴ گیگابایتی و ۹۶ تا ۱۲۸ گیگابایت رم هم گزینه است، ولی سرعتش تأیید نشده. فایلهای فشردهتر ۱ تا ۳ بیتی (۷۲٫۵ تا ۹۰ گیگابایت، با ۷۵ تا ۹۰ گیگابایت حافظه) هم در همین مخزن هست.
نصب و اجرا
- ۱
Ollama را نصب یا بهروز کنیدویندوز
irm https://ollama.com/install.ps1 | iexاین دستور را در PowerShell بزنید. روی لینوکس و مک: curl -fsSL https://ollama.com/install.sh | sh. حداقل نسخهٔ Ollama برای این مدل اعلام نشده؛ آخرین نسخه را بگیرید (۰٫۴۰٫۲ در ۸ اکتبر ۲۰۲۶).
- ۲
مدل را دانلود و اجرا کنید
ollama run qwen3.8-flash-next:125b-a6b-q4_K_M۱۲۰ گیگابایت دانلود میشود و بعد آفلاین کار میکند. برای جواب سریعتر در کارهای ساده، در API فیلد think را false بگذارید یا سطح فکر را low کنید.
- ۳
روی مک: برچسب MLXمک
ollama run qwen3.8-flash-next:125b-a6b-nvfp4۱۰۵ گیگابایت؛ برای مک با تراشهٔ اپل و ۱۲۸ گیگابایت حافظه یا بیشتر.
- ۴
یا با llama.cpp و فایل GGUF
llama serve -hf unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL -c 32768llama.cpp نسخهٔ ۰٫۶٫۰ (۵ اکتبر ۲۰۲۶) یا جدیدتر لازم است. UD-Q4_K_XL حدود ۱۱۱ گیگابایت است؛ برای دستگاه ۹۶ گیگابایتی بهجایش UD-IQ4_XS (۹۳٫۷ گیگ) را بگذارید. بعد http://127.0.0.1:8080 را باز کنید. دستور Unsloth برای MTP هنوز به شاخهٔ qwen4exp/mtp اشاره میکند.
- ۵
نصب روی سیستم بدون اینترنت
ollama pull qwen3.8-flash-next:125b-a6b-q4_K_Mمدل را روی سیستم متصل بگیرید و پوشهٔ مدلهای Ollama را به سیستم آفلاین ببرید. یا فایلهای GGUF را منتقل کنید و llama.cpp را با llama serve -m و مسیر فایل اجرا کنید.
دانلود
- Ollama ↗رسمی
برچسبهای ۴ بیتی (۱۲۰ گیگ)، ۸ بیتی (۱۸۹ گیگ)، BF16 (۳۵۵ گیگ) و MLX برای مک (۱۰۵ گیگ)؛ همه با ورودی متن و تصویر.
- Hugging Face (Qwen) ↗رسمی
وزنهای اصلی BF16 و کارت مدل.
- Hugging Face (Qwen) — FP8 ↗رسمی
نسخهٔ FP8 رسمی، برای سرور با vLLM یا SGLang.
- GGUF (Unsloth) ↗غیررسمی
فایلهای GGUF از ۷۲٫۵ (۱ بیتی) تا ۳۵۴ گیگابایت، بهعلاوهٔ فایلهای کوچک MTP؛ ساخت Qwen نیست.
- راهنمای Unsloth ↗غیررسمی
جدول حافظهٔ لازم برای هر نسخه و دستورهای اجرا.
- llama.cpp v0.6.0 ↗غیررسمی
نسخهای که پشتیبانی کامل این معماری (Qwen4Exp) و MTP را آورد.
نکات امنیتی
- پورت ۱۱۴۳۴ را روی اینترنت باز نکنید: Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و API آن رمز ندارد؛ اگر روی شبکهٔ داخلی لازمش دارید، پشت پروکسی با احراز هویت یا فایروال بگذارید.
- فایل مدل را فقط از مخزنهای Qwen، Ollama یا Unsloth بگیرید. مخزنهایی مثل Qwen3.8-4B-Distill و نسخههای «Uncensored» یا ادغامشده کار جامعهاند و محصول رسمی Qwen نیستند.
- اگر به مدل اجازهٔ اجرای دستور، دسترسی به فایل یا ابزار میدهید (حالت ایجنت)، کارهای برگشتناپذیر مثل پاککردن و ارسال را فقط با تأیید دستی انجام دهید.
برای شرکتها و سازمانها
برای سرور شرکت، کارت مدل vLLM، SGLang، TokenSpeed و KTransformers را پیشنهاد میکند و نسخهٔ FP8 رسمی هم هست. Unsloth روی یک کارت RTX 6000 PRO حدود ۱۷۰ توکن در ثانیه با MTP گزارش کرده است. استفادهٔ داخلی شرکت آزاد است، ولی اگر کسبوکارتان عرضهٔ مدل بهصورت سرویس یا ساخت دستیار کدنویسی یا اداری برای مشتری است، پیش از استفادهٔ تجاری مجوز جدا از Qwen بگیرید.
برنامههایی که این مدل را اجرا میکنند
 اولاما
 لاما سیپیپی
 آنسلات دسکتاپ
 کوبولد سیپیپی
همسطح ابری
 کوئن استودیو
آخرین بررسی: ۱۷ مهر ۱۴۰۵ · انتشار: ۲۴ مرداد ۱۴۰۵
معرفی: کوئن ۳.۸ فلش نکست (آفلاین)
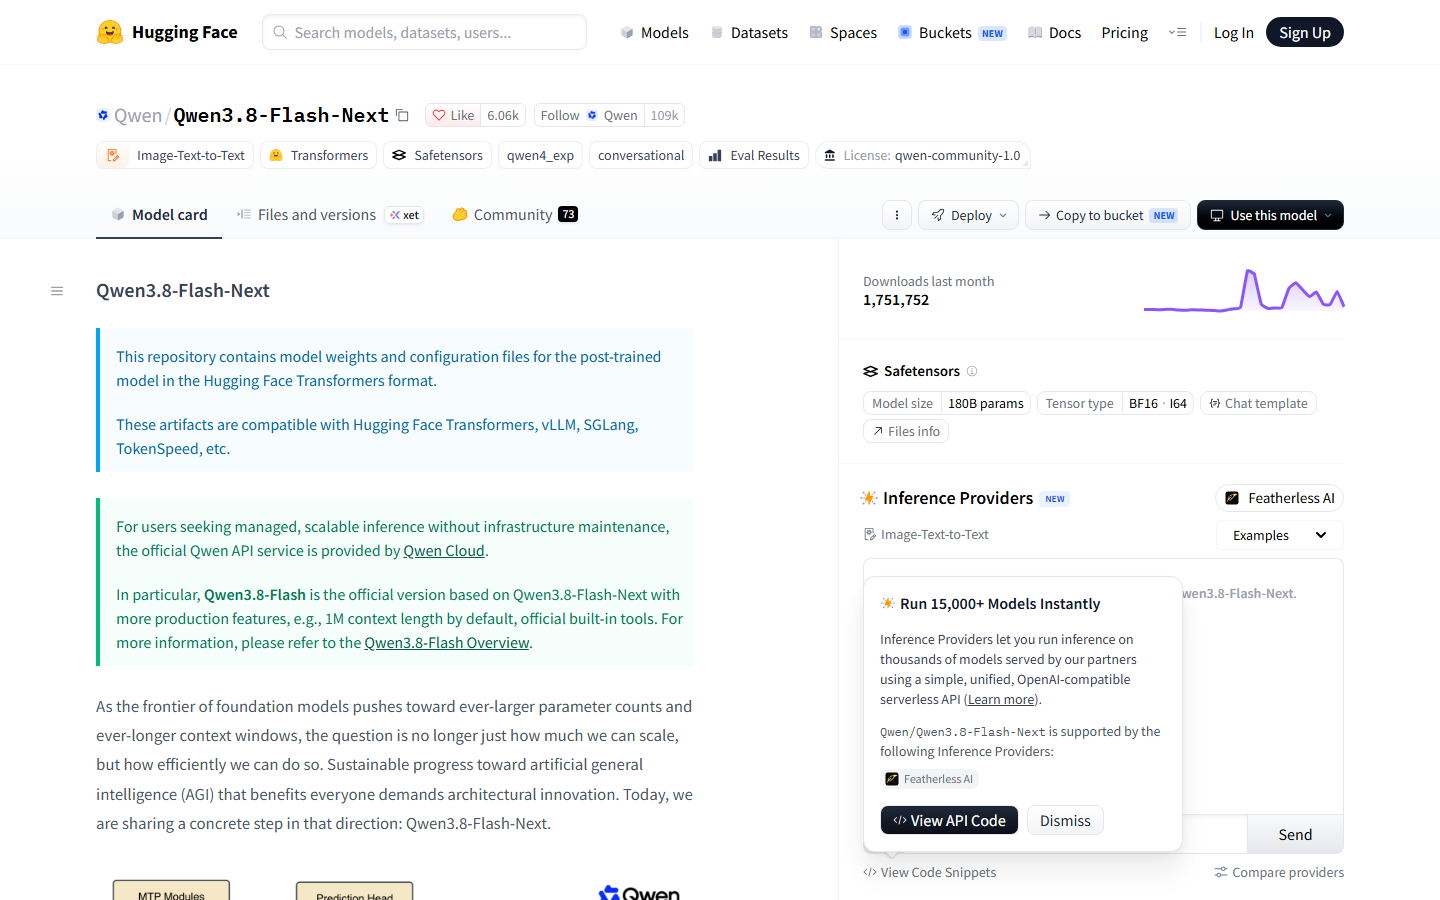
Qwen3.8-Flash-Next مدل وزنباز تیم Qwen در علیباباست که وزنهایش ۲۶ اوت ۲۰۲۶ اعلام شد (مخزن Hugging Face از ۲۴ اوت ساخته شده بود). مدل از نوع ترکیب متخصصها (MoE) است: ۱۲۵ میلیارد پارامتر که در هر توکن فقط حدود ۶ میلیاردش کار میکند، بهعلاوهٔ یک لایهٔ n-gram embedding با ۵۱ میلیارد پارامتر و یک لایهٔ پیشبینی چندتوکنی (MTP)؛ روی هم حدود ۱۸۰ میلیارد پارامتر روی دیسک. تصویر و ویدئو را میفهمد، حافظهٔ متنیاش ۲۶۲ هزار توکن است (با YaRN تا حدود یک میلیون) و فکر کردنش بهطور پیشفرض روشن است. کارت مدل آن را «پیشنمایش آزمایشی معماری Qwen4» مینامد و نسخهٔ آنلاین Qwen3.8-Flash بر پایهٔ همین مدل ساخته شده است.
واقعیت سختافزاری: این مدل لپتاپی نیست. طبق راهنمای Unsloth نسخهٔ ۴ بیتی ۹۶ تا ۱۱۴ گیگابایت حافظه میخواهد (رم و حافظهٔ کارت گرافیک روی هم، یا حافظهٔ یکپارچه)، برچسب ۴ بیتی Ollama ۱۲۰ گیگابایت و برچسب MLX مک ۱۰۵ گیگابایت است و حتی نسخهٔ ۱ بیتی ۷۵ گیگابایت حافظه میگیرد. گزینههای واقعی: مک ۱۲۸ گیگابایتی، کامپیوترهای ۱۲۸ گیگابایتی AMD Strix Halo یا DGX Spark، یا کامپیوتری با کارت گرافیک ۲۴ گیگابایتی و ۹۶ تا ۱۲۸ گیگابایت رم (سرعت این حالت آخر تأیید نشده). چون فقط ۶ میلیارد پارامتر فعال دارد، وقتی در حافظه جا شود سریع است: Unsloth روی یک کارت RTX 6000 PRO حدود ۱۷۰ توکن در ثانیه با MTP و ۱۰۰ توکن بدون آن گزارش کرده است.
در مقایسه با Qwen3.8-27B: در جدول خود Qwen در همهٔ آزمونهای گزارششده جلوتر است؛ در بعضی کمی (SWE-bench Pro ۶۲٫۵ در برابر ۶۱٫۷، GPQA Diamond ۹۱٫۷ در برابر ۸۹٫۲) و در بعضی خیلی (DeepSWE ۵۸٫۷ در برابر ۴۲٫۲، JobBench ۵۵٫۷ در برابر ۳۳٫۴، SWE-bench Multilingual ۸۱ در برابر ۷۳٫۸). اما نسخهٔ ۴ بیتی 27B در Ollama ۱۸ گیگابایت است و روی کارت ۲۴ گیگابایتی یا مک ۳۲ گیگابایتی اجرا میشود. پس برای بیشتر سیستمها 27B همچنان انتخاب درست است و Flash-Next برای کسی است که ۹۶ تا ۱۲۸ گیگابایت حافظه دارد.
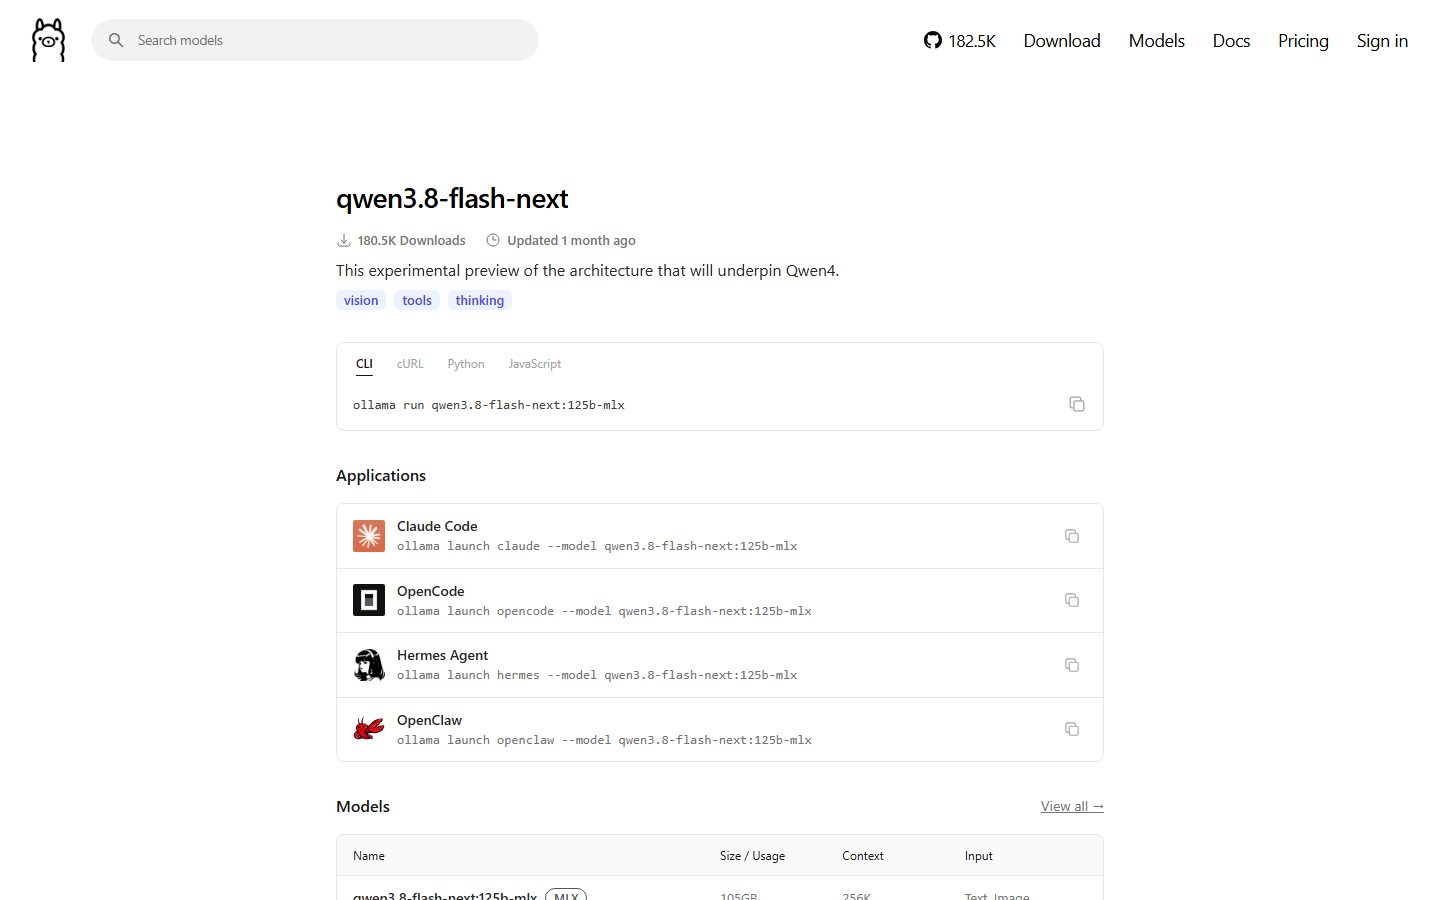
شروع: ollama run qwen3.8-flash-next:125b-a6b-q4_K_M (۱۲۰ گیگابایت)، یا روی مک برچسب MLX یعنی qwen3.8-flash-next:125b-a6b-nvfp4 (۱۰۵ گیگابایت). llama.cpp از نسخهٔ ۰٫۶٫۰ (۵ اکتبر ۲۰۲۶) پشتیبانی کامل و MTP را دارد (حدود ۱٫۵ برابر سرعت تولید روی DGX Spark) و فایلهای GGUF را Unsloth از ۷۲٫۵ تا ۳۵۴ گیگابایت منتشر کرده است. KoboldCpp از نسخهٔ ۱٫۱۲۰ و Unsloth Desktop هم اجرایش میکنند و برای سرور، vLLM، SGLang، TokenSpeed و KTransformers. پشتیبانی LM Studio محتمل است ولی تأیید نشده.
محدودیتها: مجوزش Qwen Community License 1.0 است؛ استفادهٔ تجاری آزاد است، ولی شرکتهایی که مدل را بهصورت سرویس عرضه میکنند یا دستیار کدنویسی و اداری میفروشند مجوز جدا میخواهند. کارت مدل هیچ زبانی را نام نبرده و کیفیت فارسیاش معلوم نیست. مخزن GGUF فایل بینایی (mmproj) ندارد، پس راهاندازی ورودی تصویر با llama.cpp هنوز مستند نشده است.
بهترین کاربردها
- •روی مک ۱۲۸ گیگابایتی قویترین مدل باز Qwen را آفلاین اجرا کنم
- •کدنویسی ایجنتی را بدون اینترنت روی سیستم پرحافظهٔ خودم انجام بدهم
- •روی DGX Spark یا AMD Strix Halo یک مدل بزرگ آفلاین برای کد و ابزار راه بیندازم
- •روی سرور شرکت مدلی همخانوادهٔ Qwen3.8-Flash را بدون سرویس ابری اجرا کنم
- •اسناد و کدهای طولانی را آفلاین روی کامپیوتر خودم با حافظهٔ متنی ۲۵۶ هزار توکنی تحلیل کنم
- •مدلی قویتر از Qwen3.8-27B روی سختافزار خودم و بدون اینترنت بخواهم
برای این کارها سراغش نروید
- –لپتاپ یا کامپیوتر با ۱۶ تا ۶۴ گیگابایت حافظه
- –چت سریع فارسی روی سیستم معمولی
- –عرضهٔ مدل بهصورت سرویس یا فروش دستیار کدنویسی بدون مجوز جداگانه
- –ساخت تصویر یا ویدیو
تصاویر محیط ابزار
نقاط قوت
- ✓در جدول Qwen در همهٔ آزمونهای گزارششده از Qwen3.8-27B جلوتر است؛ مثلاً DeepSWE ۵۸٫۷ در برابر ۴۲٫۲ و SWE-bench Multilingual ۸۱ در برابر ۷۳٫۸
- ✓فقط ۶ میلیارد پارامتر فعال؛ وقتی در حافظه جا شود سریع است (حدود ۱۷۰ توکن در ثانیه با MTP روی یک RTX 6000 PRO، گزارش Unsloth)
- ✓فهم تصویر و ویدئو و حافظهٔ متنی ۲۶۲ هزار توکنی، قابل گسترش تا حدود یک میلیون
- ✓برچسب آماده در Ollama (با نسخهٔ MLX برای مک) و پشتیبانی llama.cpp، KoboldCpp، Unsloth Desktop و vLLM
- ✓استفادهٔ تجاری با دو شرط آزاد است و استفادهٔ داخلی شرکتها از شرط مجوز جدا مستثناست
نقاط ضعف
- ✗نسخهٔ ۴ بیتی ۹۶ تا ۱۲۰ گیگابایت حافظه میخواهد و کوچکترین نسخه هم ۷۵ گیگابایت است؛ فقط روی مک یا کامپیوتر ۱۲۸ گیگابایتی (یا کارت ۲۴ گیگ با ۹۶ گیگ رم به بالا) اجرا میشود و دانلودش ۹۰ تا ۱۲۰ گیگابایت است
- ✗مجوز Qwen Community: شرکتهایی که مدل را بهصورت سرویس عرضه میکنند یا دستیار کدنویسی و اداری میفروشند، برای استفادهٔ تجاری مجوز جدا میخواهند
- ✗کارت مدل هیچ زبانی را نام نبرده و کیفیت فارسی آن معلوم نیست
- ✗معماری آزمایشی (پیشنمایش Qwen4) است؛ پشتیبانی کامل llama.cpp از نسخهٔ ۰٫۶٫۰ آمد و راهاندازی ورودی تصویر با GGUF مستند نشده
- ✗فکر کردن بهطور پیشفرض روشن و روی بالاترین سطح (xhigh) است؛ برای کارهای ساده باید آن را کم یا خاموش کنید
قیمتگذاری
رایگان (وزن باز)
Free (open weights)رایگان
- • دانلود و اجرا روی سختافزار خودتان
- • استفادهٔ تجاری با دو شرط مجوز Qwen Community
- • استفادهٔ داخلی شرکت بدون مجوز جدا
قیمتها تقریبی و بر اساس آخرین بازبینی است؛ برای قیمت دقیق به سایت رسمی مراجعه کنید.
پرسشهای پرتکرار
با چه سختافزاری اجرا میشود؟
نسخهٔ ۴ بیتی دستکم حدود ۹۶ گیگابایت حافظه میخواهد (رم و حافظهٔ کارت گرافیک روی هم، یا حافظهٔ یکپارچه). گزینههای واقعی مک ۱۲۸ گیگابایتی، کامپیوترهای ۱۲۸ گیگابایتی AMD Strix Halo و DGX Spark، یا کامپیوتر با کارت ۲۴ گیگابایتی و ۹۶ تا ۱۲۸ گیگابایت رم است (سرعت این حالت تأیید نشده). Unsloth میگوید لایههای n-gram را میشود با mmap روی SSD نگه داشت. کوچکترین فایل (۱ بیتی) هم ۷۲٫۵ گیگابایت است؛ با سیستم ۳۲ یا ۶۴ گیگابایتی سراغ Qwen3.8-27B بروید.
با Qwen3.8-27B چه فرقی دارد و کدام را بگیرم؟
در جدول خود Qwen، Flash-Next در همهٔ آزمونها جلوتر است؛ در بعضی خیلی (DeepSWE ۵۸٫۷ در برابر ۴۲٫۲ و JobBench ۵۵٫۷ در برابر ۳۳٫۴) و در SWE-bench Pro (۶۲٫۵ در برابر ۶۱٫۷) فقط کمی. ولی 27B در Ollama ۱۸ گیگابایت است و روی کارت ۲۴ گیگابایتی یا مک ۳۲ گیگابایتی اجرا میشود و مجوزش Apache 2.0 بدون شرط است. اگر ۹۶ تا ۱۲۸ گیگابایت حافظه ندارید، 27B را بگیرید.
فارسی بلد است؟
معلوم نیست. کارت مدل هیچ زبانی را نام نبرده و شاهدی از کیفیت فارسیاش پیدا نشد. معماریاش تازه است، پس نتیجهٔ Qwen3.8-27B را نمیشود به آن تعمیم داد؛ پیش از تصمیم با متنهای خودتان امتحانش کنید.
برای کار تجاری آزاد است؟
بله، با دو شرط مجوز Qwen Community License 1.0. اول اینکه محصولی با بیش از ۱۰۰ میلیون کاربر فعال ماهانه یا بیش از ۲۰ میلیون دلار درآمد ماهانه باید نام مدل را بهطور برجسته نشان دهد. دوم اینکه شرکتی که کسبوکارش عرضهٔ مدل بهصورت سرویس یا «دستیار کاری هوش مصنوعی» (دستیار کدنویسی یا کارهای اداری) است، برای استفادهٔ تجاری مجوز جدا از Qwen میخواهد. استفادهٔ داخلی شرکتها از این شرط دوم مستثناست.
چطور نصبش کنم؟
سادهترین راه Ollama است: ollama run qwen3.8-flash-next:125b-a6b-q4_K_M (۱۲۰ گیگابایت) یا روی مک qwen3.8-flash-next:125b-a6b-nvfp4 (۱۰۵ گیگابایت). با llama.cpp نسخهٔ ۰٫۶٫۰ به بعد فایل GGUF مخزن unsloth/Qwen3.8-Flash-Next-GGUF را اجرا کنید؛ برای دستگاه ۹۶ گیگابایتی UD-IQ4_XS (۹۳٫۷ گیگ). برای سیستم بدون اینترنت، مدل را روی سیستم متصل بگیرید و پوشهٔ مدلهای Ollama یا فایلهای GGUF را منتقل کنید.
نسخهٔ کوچکتر رسمی (مثلاً 4B یا 9B) دارد؟
نه. Qwen از نسل ۳٫۸ فقط سه مدل وزنباز منتشر کرده: همین Flash-Next، Qwen3.8-27B و مدل ۲٫۴ تریلیونی که سرور چندکارته میخواهد. مخزنهایی مثل Qwen3.8-4B-Distill یا نسخههای «Uncensored» کار جامعهاند، نه Qwen.
نظرات کاربران
هنوز نظری ثبت نشده — اولین نفر باشید!
ابزارهای مشابه
مشاهده همه
کوئن ۳.۸ 27B (آفلاین)
Qwen3.8-27B (offline)
قویترین مدل ۲۷ میلیاردی Qwen (اوت ۲۰۲۶) برای کارت گرافیک ۲۴ گیگابایتی: کدنویسی ایجنتی، کار با سند و تصویر و استدلال، طبق جدول Qwen نزدیک به Qwen3.7-Plus آنلاین، با مجوز Apache 2.0.
میمو ۲.۶ (آفلاین)
MiMo-V2.6 (offline)
خانوادهٔ مدلهای باز شیائومی (سپتامبر ۲۰۲۶، مجوز MIT) برای کدنویسی ایجنتی و کار با ابزار: نسخهٔ Distill-Qwen-9B با فایل ۵٫۸ گیگابایتی روی لپتاپ ۱۶ گیگابایتی اجرا میشود و Flash و Pro (به گزارش eWeek، Pro بالاترین مدل باز در شاخص Artificial Analysis) سرور چندکارته میخواهند؛ فارسی آزموده نشده است.

دیپسیک ۴ فلش (آفلاین)
DeepSeek-V4-Flash (offline)
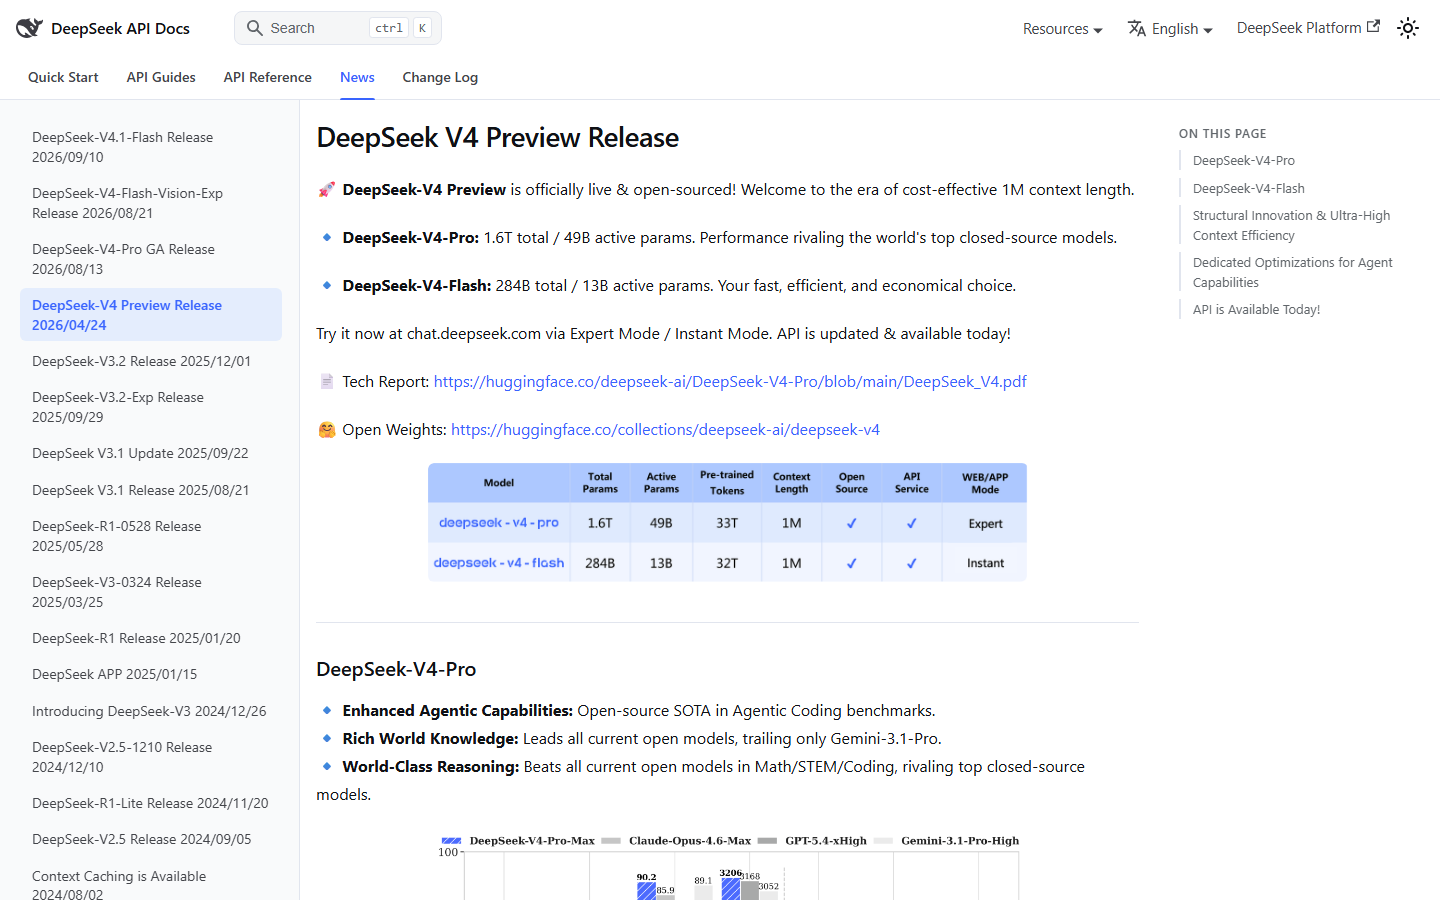
نسخهٔ متنباز DeepSeek-V4-Flash با ۲۸۴ میلیارد پارامتر و متن تا یک میلیون توکن، برای برنامهنویسی و کار ایجنتی؛ روی سرور چندکارته یا دستگاه ۱۲۸ گیگابایتی، با مجوز MIT.